여러 모델을 지원하는 AI 비디오 플랫폼을 사용할 때, 가장 어려운 부분은 종종 프롬프트 작성 자체가 아닙니다.
진정한 과제는 다음과 같은 결정을 내리는 것입니다:
“이 영상에는 실제로 어떤 모델을 사용해야 할까?”
Wan, Seedance, Kling은 모두 비디오를 생성할 수 있지만, 이것이 곧 모든 모델이 동일한 방식으로 사용되어야 한다는 의미는 아닙니다.
제품 광고와 패션 릴스(Reel)는 서로 다른 문제를 안고 있습니다. 스토리 중심의 장면은 단순한 이미지 투 비디오(Image-to-Video) 클립과는 다른 제어가 필요합니다. 대화, 다수의 캐릭터, 참조 모션(reference motion), 복잡한 상호작용 등이 포함되면 모델 선택의 중요성은 더욱 커집니다.
따라서 다양한 사용 사례에 맞는 AI 비디오 모델을 선택할 때, 어느 모델이 가장 강력한지부터 묻지 마십시오.
대신 더 나은 질문부터 시작하세요:
내가 만들려는 영상에서 가장 해결하기 어려운 부분은 무엇인가?
Movmix에서는 GPT Image 2.5, Nano Banana, Grok Image, Seedream과 같은 이미지 모델로 강력한 첫 프레임을 먼저 준비한 후, 비디오 생성 단계로 넘어갈 수 있습니다.
실용적인 워크플로우는 다음과 같습니다:
이미지 준비 → 비디오 모델 선택 → 모션 및 카메라 움직임 설명 → 생성 → 실제 문제 해결
Movmix AI Video Generator에서 시작하여 모델 이름보다는 시나리오에 따라 모델을 선택하세요.
빠른 가이드: 당신의 시나리오에 적합한 AI 비디오 모델은?
| 비디오 시나리오 | 먼저 시도해 볼 모델 | 가장 중요한 요소 |
|---|---|---|
| 단일 이미지를 자연스럽게 애니메이션화 | Wan / Kling | 간단한 모션, 첫 프레임 일관성 |
| 제품 광고 | Wan | 제품 구조, 카메라, 조명 |
| 패션, 릴스, 캐릭터 클립 | Kling / Wan | 얼굴, 의상, 신체 움직임 |
| 참고 동영상에서 모션 전환 | Kling / Seedance / Wan | 캐릭터 아이덴티티 vs 참고 모션 |
| 다중 샷 스토리텔링 | Seedance | 타이밍, 샷 진행, 연속성 |
| 다중 캐릭터 대화 | Kling / Seedance | 발화자 순서, 목소리, 타이밍 |
| 복잡한 액션 또는 다수 인물 | Seedance / Kling | 움직임 관계, 물리적 일관성 |
| 다중 레퍼런스 크리에이티브 워크플로 | Seedance | 이미지, 동영상 및 오디오 레퍼런스의 명확한 역할 |
이것은 절대적인 순위가 아닙니다.
동일한 장면은 종종 둘 이상의 모델로 생성할 수 있습니다. 진정한 핵심 질문은 작업 중 어떤 부분을 모델이 가장 잘 처리해야 하는지입니다.
시나리오 1: 이미지 한 장을 자연스럽게 움직이고 싶을 때
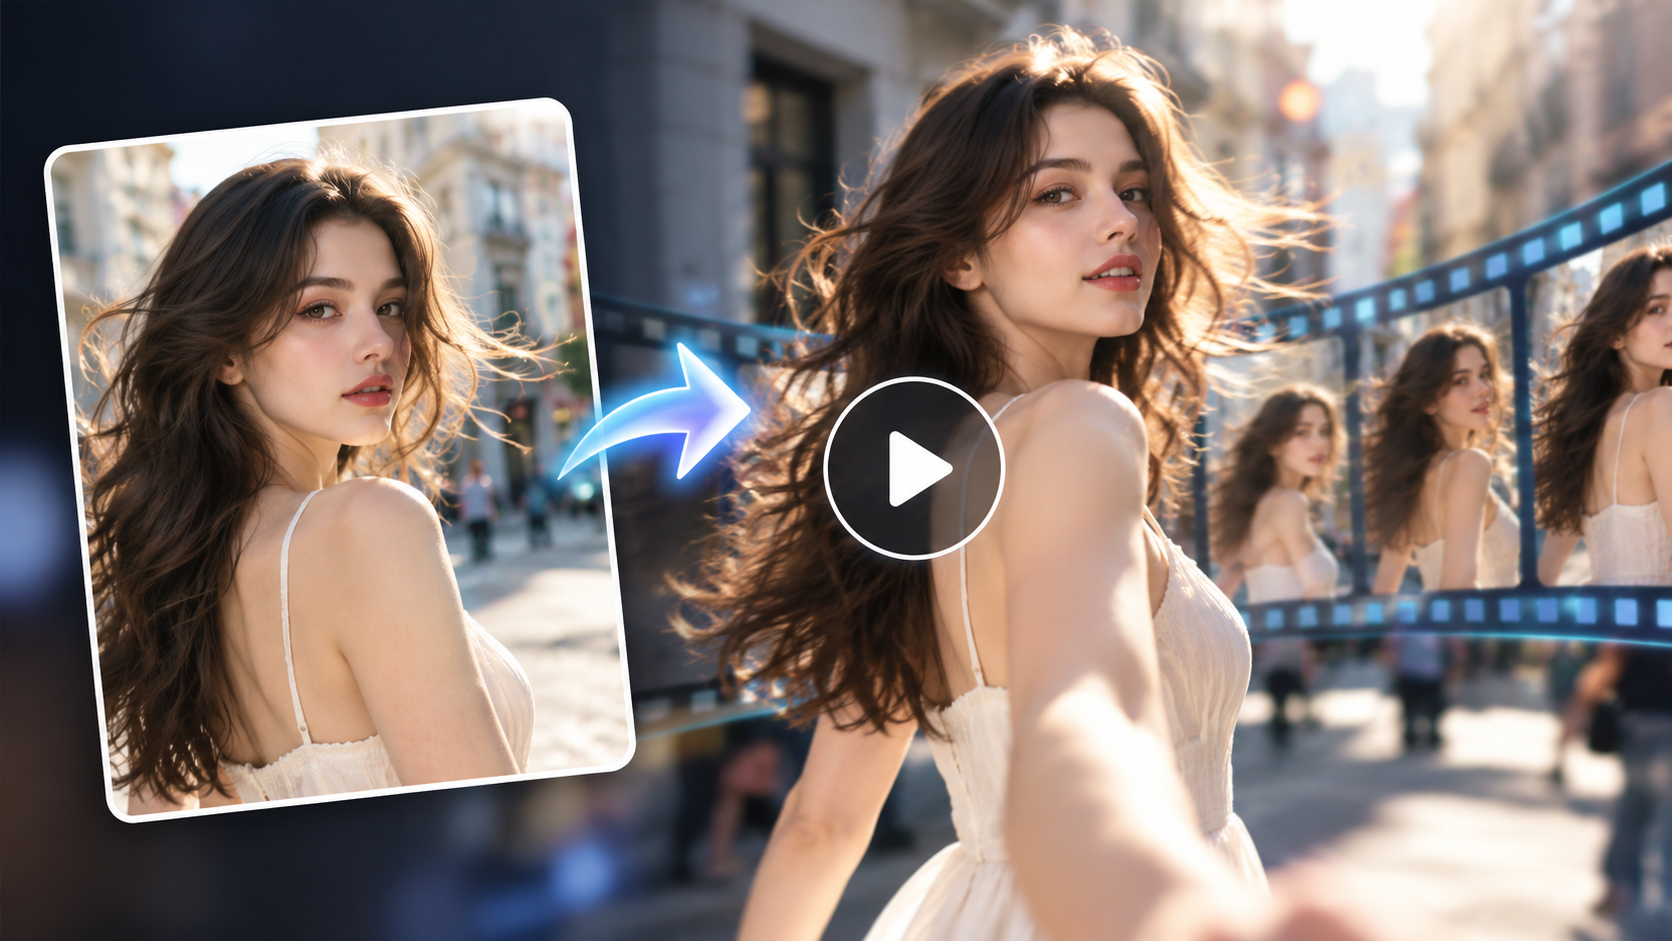
이는 가장 일반적인 이미지 투 비디오(Image-to-Video) 사용 사례입니다.
인물 사진에서 피사체가 카메라를 향해 돌아보게 하거나, 반려동물이 고개를 들게 하거나, 도시 사진 속 사람과 나무, 조명이 미묘하게 움직이도록 만들고 싶을 수 있습니다.
복잡한 스토리가 필요하지 않습니다.
Wan 또는 Kling 사용
이러한 작업에서 중요한 구조는 다음과 같습니다:
하나의 주체 + 하나의 주요 동작 + 하나의 단순한 카메라 움직임
참고 이미지는 이미 인물, 제품 또는 환경의 모습을 모델에게 전달합니다.
비디오 프롬프트는 다음에 집중해야 합니다:
다음에 무슨 일이 일어나는가?
예를 들어:
이 섹션을 위해 완전한 데모 비디오를 제작할 필요는 없습니다. 원칙 자체를 이해하는 것이 더 유용합니다:
이미지에 이미 표시된 내용을 비디오 프롬프트에서 반복해서 설명하지 마십시오.
시나리오 2: 제품 광고가 필요하며 제품이 변형되지 않아야 하는 경우
향수, 헤드폰, 스킨케어 제품, 신발, 가전제품, 음료 등 주요 문제는 대개 제품을 어떻게 움직이게 할지가 아닙니다.
핵심은 제품이 변형되지 않도록 유지하는 것입니다.
4초 후에 병뚜껑 모양이 바뀌거나 헤드폰 디자인이 갑자기 변경되면, 영상은 여전히 매력적으로 보일 수 있지만 광고로서는 더 이상 유용하지 않습니다.
Wan 먼저 사용해 보기
이러한 워크플로우에는 유용한 규칙이 하나 있습니다:
제품은 정지된 상태로 두고 카메라, 조명 및 반사 효과만 움직이세요.
전체 워크플로우 1: 프리미엄 헤드폰 광고
1단계: 첫 프레임 준비
이미 우수한 제품 이미지가 있다면 이를 직접 사용하세요.
없다면 Movmix의 이미지 생성 모델 중 하나를 사용하여 강력한 상업용 스타일의 이미지를 먼저 생성하세요.
| 첫 프레임 이미지 프롬프트 | 출력 이미지 |
|---|---|
| 밝은 회색 자연석 디스플레이 받침대 중앙에 배치된 프리미엄 오버이어 무선 헤드폰, 짙은 회색 메탈 프레임과 부드러운 가죽 이어 쿠션이 선명하게 보임, 미니멀하고 모던한 스튜디오 배경, 소재감을 강조하는 부드러운 사이드 조명, 리얼istic한 상업 제품 사진, 로우 앵글 클로즈업, 깔끔한 구도, 16:9 비율, 텍스트 없음, 로고 없음, 워터마크 없음. |
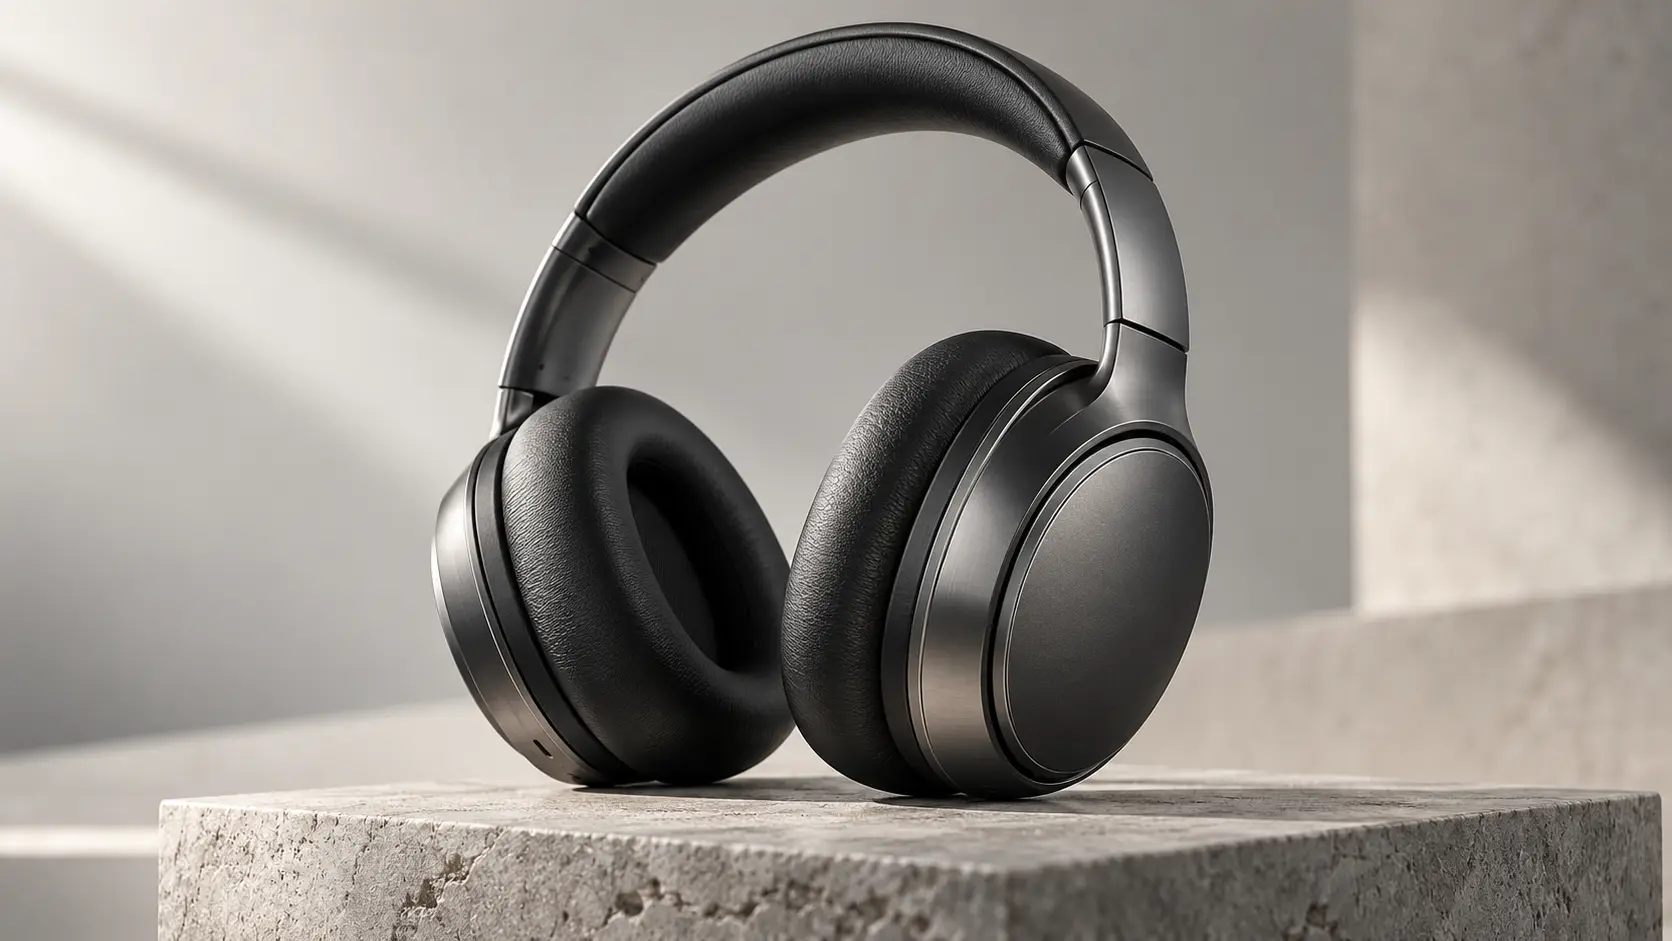 |
2단계: 이미지 업로드 및 Wan 선택
Movmix Image to Video를 열고 제품 이미지를 업로드한 후 사용 가능한 Wan 비디오 모델을 선택하세요.
3단계: 실제로 필요한 움직임만 디자인하기
비디오 프롬프트:
단계 4: 프롬프트 전체가 아닌 문제만 수정하세요
제품의 형태가 변한다면 제품의 움직임을 줄이고, 대신 카메라나 조명으로 움직임을 전달하세요.
카메라 움직임이 너무 빠르다면 카메라 속도만 조정하세요.
배경이 계속 흔들린다면 모델에게 배경을 완전히 안정적으로 유지하라고 명시적으로 지시하세요.
이는 생성 실패마다 프롬프트 전체를 다시 작성하는 것보다 훨씬 유용합니다.
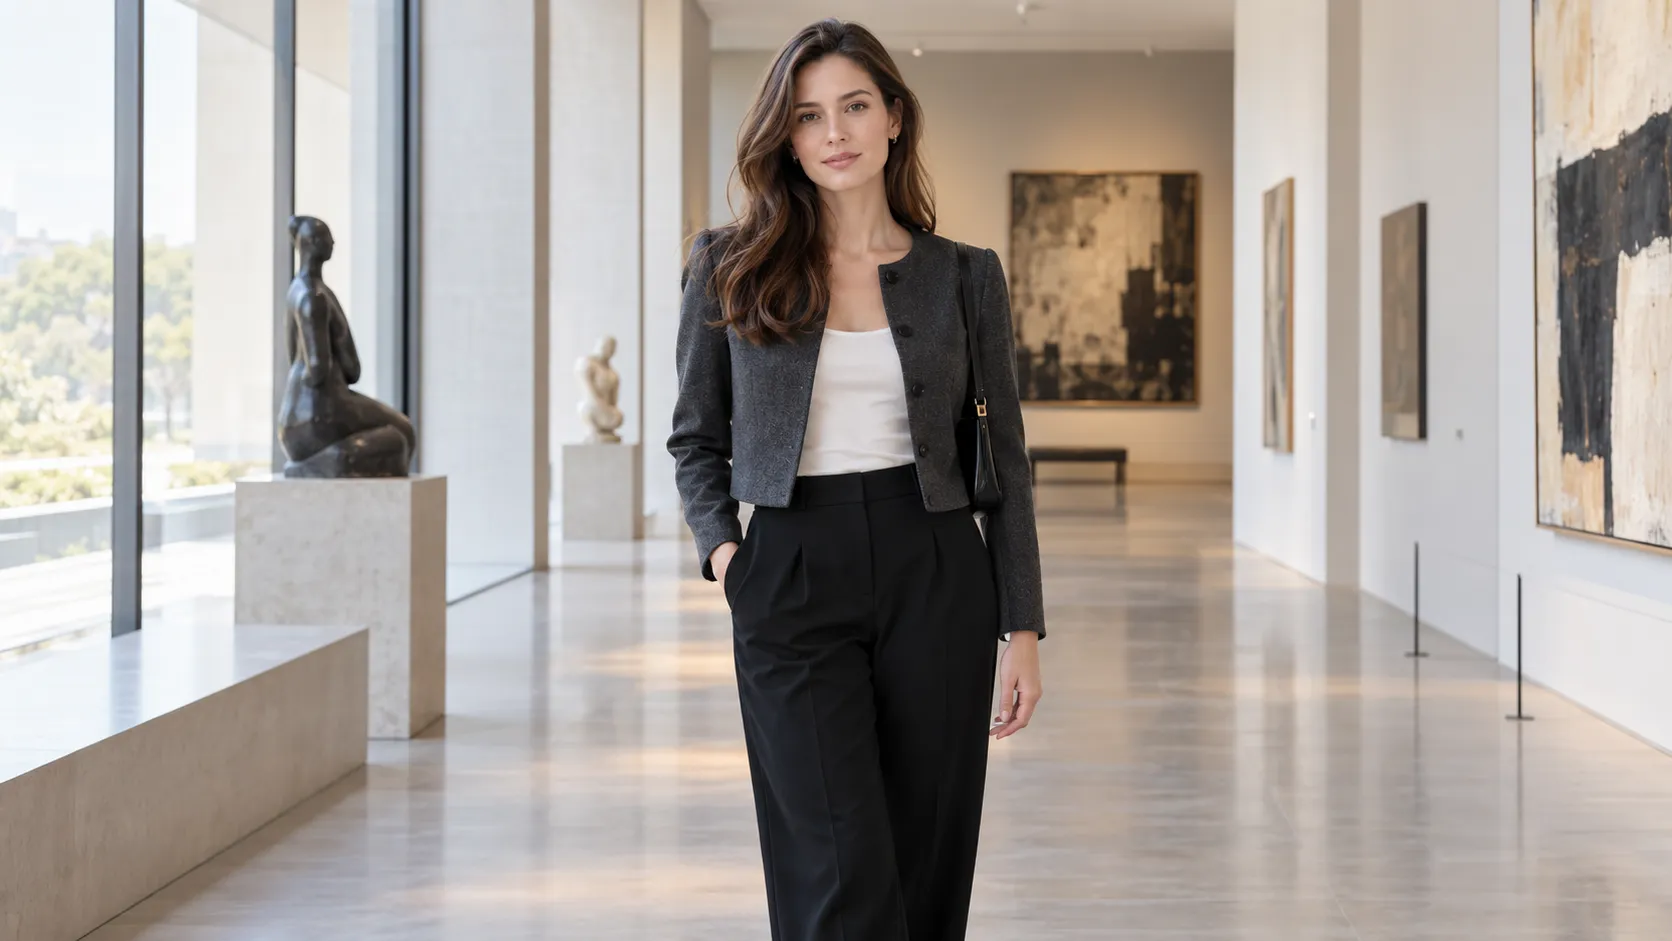
상황 3: 패션, 릴스(Reels) 또는 캐릭터 중심의 소셜 미디어 영상을 원할 때
캐릭터 영상은 완전히 다른 유형의 실패 패턴을 보입니다.
제품의 경우 형태 변화를 걱정합니다.
사람의 경우 다음을 걱정해야 합니다:
첫 번째 초에 등장한 인물이 영상 끝무렵에는 동일 인물로 보이지 않습니다.
Try Kling or Wan
패션, 라이프스타일, 가상 캐릭터 및 소셜 미디어 클립의 경우 다음 세 가지에 집중하세요:
신원 일관성 + 단순한 동작 + 명확한 카메라 움직임
예를 들어:
동작이 단순하다면 Wan과 Kling 모두 테스트해 볼 만한 합리적인 옵션입니다.
샷이 더 복잡한 신체 연기, 카메라 추적 또는 여러 참조 에셋을 포함하기 시작하면 Kling 테스트가 더 적합해집니다.
| 이미지 프롬프트 | |
|---|---|
| 현대 미술관 복도 안에 서 있는 유럽인 여성의 16:9 가로 이미지. 세련된 짙은 회색 짧은 재킷, 흰색 상의, 검은색 바지를 착용하고 자연스럽게 앞으로 걸어갈 준비를 하고 있습니다. 얼굴 디테일이 선명하며, 배경에는 현대적인 건축 양식의 라인이 보입니다. 부드러운 자연광 조명으로 촬영된 리얼리즘 프리미엄 패션 사진이며, 중간에서 전신 구도로 구성되었습니다. 텍스트, 로고, 워터마크는 없습니다. |
 |
시나리오 4: 캐릭터 이미지가 있고 다른 비디오의 동작을 복사하고 싶은 경우
이는 더 이상 일반적인 이미지 투 비디오(Image-to-Video)가 아닙니다.
이제 서로 다른 두 가지 참조 자료가 각각 다른 역할을 수행합니다.
이미지는 다음 질문에 답합니다:
누가 연기해야 하는가?
비디오는 다음 질문에 답합니다:
어떻게 움직여야 하는가?
예를 들어, 한 사람의 초상화 이미지와 별도의 스포츠, 춤, 또는 공연 영상이 있을 수 있습니다. 이때 이미지 속 인물이 비디오의 동작을 수행하도록 만들려고 합니다.
Kling, Seedance 또는 Wan 참조 워크플로우 시도하기
이 시나리오에서 가장 중요한 규칙은 다음과 같습니다:
참조 이미지 = 누가(Who)
참조 비디오 = 어떻게(How)
모델에 단순히 이렇게 지시하지 마세요:
“참조 자료처럼 만들어줘.”
각 참조 자료가 무엇을 제어하는지 정확히 지시하세요.
전체 워크플로우 2: 다른 캐릭터에 농구 모션 이식하기
다음과 같은 자료가 있다고 가정해 봅시다:
이미지 A: 성인 남성 캐릭터
비디오 B: 빠른 드리블과 회전 동작을 수행하는 운동선수
목표는 비디오 B의 운동선수를 다시 생성하는 것이 아닙니다.
목표는 이미지 A의 캐릭터가 비디오 B의 모션을 수행하도록 만드는 것입니다.
비디오 프롬프트
텍스트만으로는 설명할 수 없는 내용을 결과가 즉각적으로 보여주기 때문에 제작해 볼 가치가 있는 비디오 데모 중 하나입니다:
하나의 참조 자료는 신원을 제어하고, 다른 하나는 모션을 제어합니다.
시나리오 5: 단일 액션이 아닌 작은 스토리를 원할 때
요청 사항이 다음과 같이 들리기 시작하면:
캐릭터가 A 행동을 하고, 그다음 B 상황이 발생하며, 이어 C를 인지하고 마지막으로 반응합니다.
이제 단순한 모션 클립을 만드는 것이 아닙니다.
You are creating a story.
Seedance 사용해 보기
이러한 유형의 콘텐츠에서는 프롬프트가 단순한 시각적 형용사의 나열에서 벗어나야 합니다.
대신 일련의 흐름을 서술해야 합니다:
무엇이 먼저 일어나는지 → 무엇이 변하는지 → 카메라가 어떻게 따라가는지 → 장면이 어디서 끝나는지
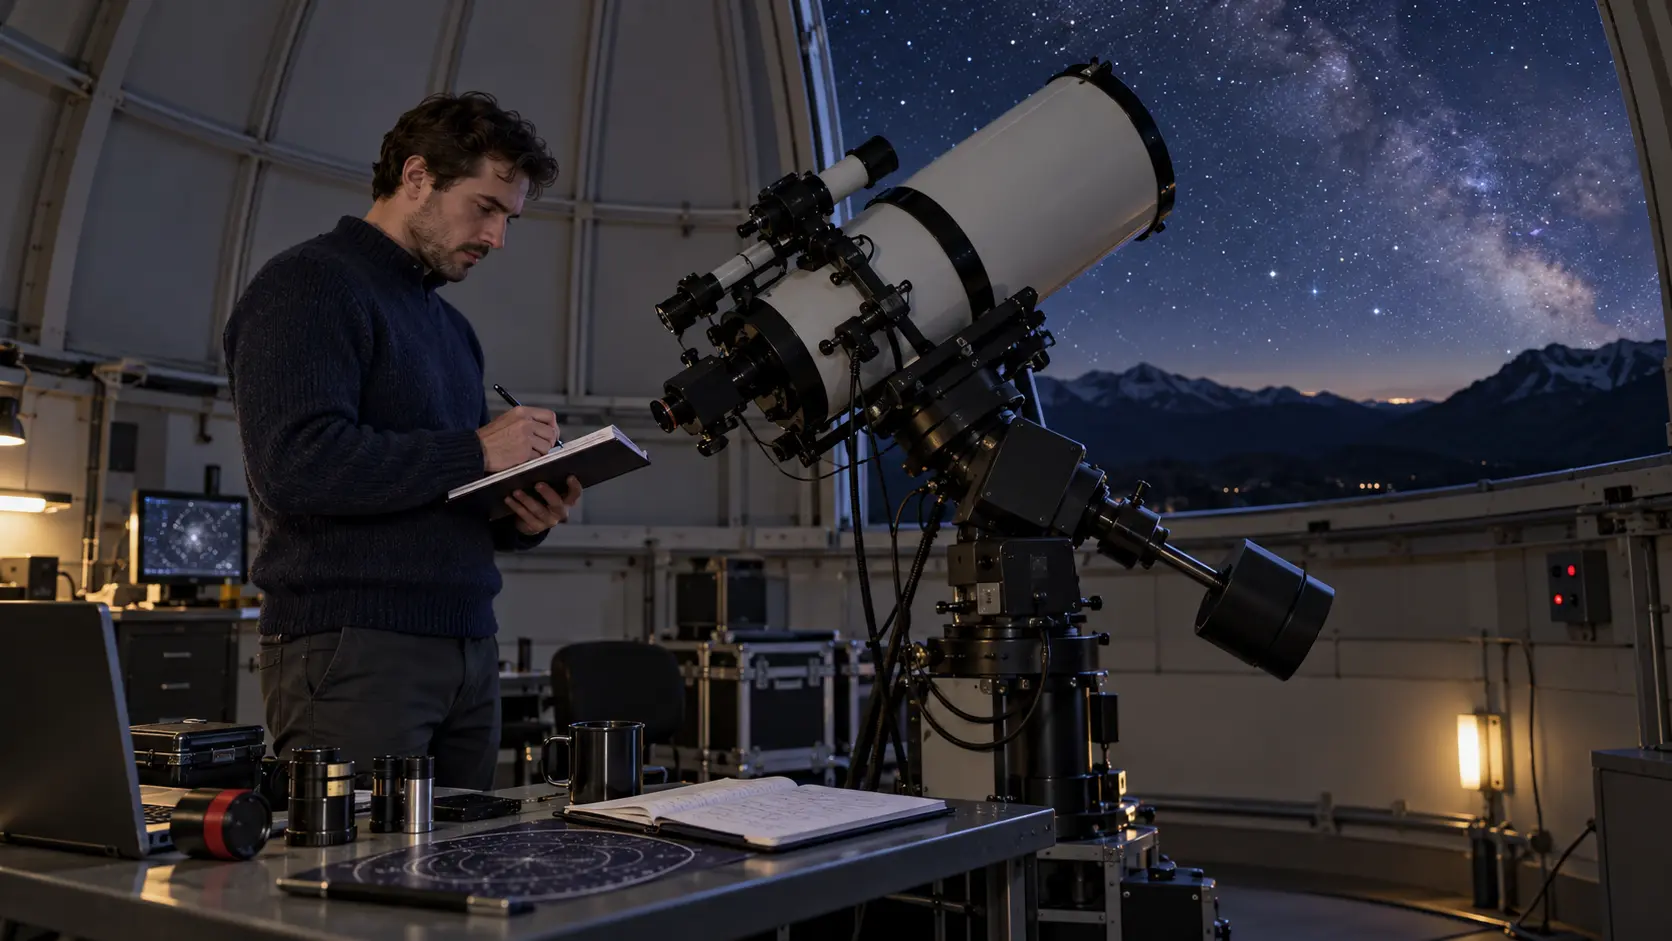
전체 워크플로 3: 천문대에서 발견한 뜻밖의 사건
1단계: 첫 번째 프레임 생성
| 이미지 프롬프트 | 출력 결과 |
|---|---|
| 조용한 산꼭대기 천문대 안에 서 있는 35세 성인 남성 천문학 연구원. 짙은 파란색 니트 스웨터와 어두운 바지를 입고 있으며, 대형 망원경 옆에서 관측 데이터를 기록하고 있습니다. 책상 위에는 노트북과 간단한 과학 장비가 놓여 있고, 천문대 돔의 개구부를 통해 맑은 밤하늘이 보입니다. 리얼리즘 다큐멘터리 사진 스타일, 미디엄 샷, 차분하고 자연스러운 실내 조명, 16:9 비율. |
 |
2단계: Seedance 선택
이번에는 단순한 움직임 이상의 것이 필요합니다.
하나의 "사건"이 필요합니다.
비디오 프롬프트
여기서 중요한 교훈은 프롬프트 그 자체가 아닙니다.
프로젝트가 단순한 '움직임'에서 '스토리텔링'으로 넘어가는 시점을 파악하는 것입니다.
시나리오 6: 두 명 이상의 캐릭터가 대화해야 하는 경우
대사가 장면에 포함되는 순간, 선택 기준이 다시 바뀝니다.
이제 모델은 매력적인 비주얼 이상을 관리해야 합니다.
또한 다음 사항들을 관리해야 합니다:
캐릭터 정체성, 화자 순서, 목소리, 타이밍 및 입 모양 동기화
Kling 또는 Seedance를 사용해 보세요
단순히 다음과 같이 작성하지 마세요:
두 디자이너가 프로젝트를 논의합니다.
이렇게 하면 거의 모든 요소가 정의되지 않은 상태로 남습니다.
더 나은 구조는 다음과 같습니다:
캐릭터 A가 먼저 말함 → 캐릭터 B가 반응함 → 캐릭터 B가 답변함 → 카메라 전환 → 환경은 일정하게 유지
대사가 중요해지면 오디오는 선택적 추가 요소가 아니라 장면 로직의 일부가 됩니다.
웹사이트에서 선보이고자 하는 주요 기능 중 하나가 대화가 아닌 경우, 여기서 별도의 데모 영상을 만들 필요는 없습니다.
시나리오 7: 복잡한 액션, 스포츠, 퍼포먼스 또는 다수 인물 등장
이러한 장면에서는 AI 비디오 모델이 훨씬 더厳しい 테스트를 받습니다.
예를 들어双人 스포츠, 협조된 퍼포먼스, 여러 캐릭터의 동시 움직임, 신체적 상호작용, 또는 여러 피사체 주위를 움직여야 하는 카메라 등이 있습니다.
Seedance 또는 Kling 사용해 보기
여기서 얻는 주요 교훈은 놀랍도록 간단합니다.
복잡한 문제를 긴 문장 하나로 해결하려고 하지 마세요.
관계를 세분화하세요.
다음과 같이 작성하는 대신:
두 사람이 강렬한 동작을 수행하는 동안 카메라가 영화처럼 움직입니다.
명확히 정의하기:
캐릭터 A는 여기서 시작합니다. 캐릭터 B는 저기서 시작합니다. 캐릭터 A가 먼저 움직입니다. 캐릭터 B가 반응합니다. 두 사람은 이 지점에서 상호작용합니다. 카메라는 여기에 위치합니다.
동작이 복잡할수록 누가 무엇을 하는지 설명하는 것이 더 중요해집니다.
이는 “다이나믹”, “웅장함”, “에너지 넘치는” 같은 불필요한 수식어를 추가하는 것보다 훨씬 유용합니다.
시나리오 8: 이미지, 동영상, 오디오, 스토리보드가 이미 준비된 경우
때로는 문제의 원인이 소재 부족이 아닙니다.
오히려 소재가 너무 많아서 발생합니다.
이미 다음 자료를 보유하고 있을 수 있습니다.
- 캐릭터 이미지
- 배경 레퍼런스
- 모션 영상
- 음악
- 음향 효과
- 스토리보드 이미지
이 시점에서 핵심 과제는 참고 자료 관리입니다.
Seedance 사용해 보기
핵심은 가능한 한 많은 자료를 업로드하는 것이 아닙니다.
핵심은 각 참고 자료에 명확한 역할을 부여하는 것입니다.
예를 들어:
이미지 A는 캐릭터를 제어합니다. 이미지 B는 배경 환경을 제어합니다. 비디오 C는 카메라 이동을 제어합니다. 오디오 D는 사운드 스타일을 제어합니다.
각 참고 자료가 어떤 역할을 담당할지 결정하지 않으면, 모델이 스스로 추측해야 합니다.
모델이 추측을 시작하면, 참고 자료를 추가로 더 많이 넣어도 제어가 강화되기보다는 오히려 워크플로우가 불명확해질 수 있습니다.
그렇다면 어떤 AI 비디오 모델을 사용해야 할까요?
다음과 같은 질문으로 시작하지 마세요:
“Wan, Seedance, Kling 중 어느 것이 가장 강력한가요?”
대신 더 실용적인 세 가지 질문을 던져보세요.
이미 보유한 자료는 무엇인가요?
텍스트뿐인가요? 이미지 한 장인가요? 아니면 이미지, 참고 영상 및 오디오까지 모두 있나요?
이 비디오 제작에서 가장 어려운 부분은 무엇인가요?
제품 일관성? 캐릭터 정체성? 모션? 스토리텔링? 대화? 다중 캐릭터 상호작용?
절대로 실패해서는 안 되는 요소는 무엇인가요?
얼굴? 제품 구조? 모션? 장면의 연속성?
이러한 질문들은 일반적인 AI 비디오 모델 비교보다 훨씬 더 유용한 통찰을 제공합니다.
제품 이미지를 깔끔한 광고 컷으로 변환하기만 하면 된다면, 복잡한 멀티 샷 스토리로 시작할 필요는 없습니다.
한 캐릭터가 다른 영상의 동작을 수행하도록 하려면, 일반적인 이미지 투 비디오 워크플로우로는 충분하지 않습니다.
스크립트에 다음과 같은 단어들이 늘어나기 시작할 때:
“그리고,” “그 후에,” “갑자기,” “마침내”...
단순한 클립을 제작하는 단계는 이미 지났을 가능성이 높습니다.
이제 당신은 스토리를 만들고 있습니다.
작업 내용에 따라 모델 선택도 달라져야 합니다.
최종 규칙: 모델을 고르기 전에 먼저 비디오를 선택하세요
Movmix에서 여러 모델을 사용할 수 있는 가치는 단순히 클릭할 버튼이 더 많아진다는 데 있지 않습니다.
진정한 가치는 서로 다른 작업에 각기 다른 워크플로우를 적용할 수 있다는 점에 있습니다.
GPT Image 2.5, Nano Banana, Grok Image, Seedream과 같은 이미지 모델을 사용하여 원하는 시각적 시작점을 준비하세요.
그다음 장면에서 다음으로 어떤 일이 일어나야 하는지에 따라 Wan, Seedance, Kling 또는 다른 사용 가능한 비디오 모델을 선택하세요.
이미지가 결정하는 요소:
무엇처럼 보이는가?
비디오 모델이 결정하는 요소:
다음에 무슨 일이 일어나는가?
프롬프트가 결정하는 요소:
어떻게 일어나야 하는가?
따라서 다음번에 어떤 AI 비디오 모델을 선택해야 할지 망설여진다면, 잠시 모델 이름은 잊으세요.
먼저 실제로 만들고 싶은 비디오를 설명해 보세요.
그러면 적합한 모델을 훨씬 쉽게 선택할 수 있게 됩니다.