Wenn eine KI-Videoplattform mehrere Modelle anbietet, ist die schwierigste Entscheidung oft nicht der Prompt, sondern das Modell.
Wan 3.0, Seedance 2.5, Kling 4.0 und MiniMax H3 sind alle auf Movmix verfügbar und können jeweils ein Bild oder einen Prompt in ein Video verwandeln. Sie sind jedoch nicht austauschbar. Jedes Modell hat seine Stärken in unterschiedlichen Bereichen: Produktkonsistenz wahren, Gesichter stabil halten, Bewegungen aus einem Referenzclip kopieren, kurze Geschichten erzählen oder zwei Charaktere miteinander sprechen lassen.
Dieser Leitfaden beantwortet eine zentrale Frage: Welches KI-Videomodell sollten Sie für Ihr aktuelles Projekt verwenden? Beginnen Sie mit der Übersichtstabelle für schnelle Antworten und springen Sie dann zu dem Szenario, das am besten zu Ihrem Projekt passt.
Eine Produktwerbung stellt andere Anforderungen als ein Fashion-Reel. Eine erzählerisch geprägte Szene benötigt andere Steuerungsmöglichkeiten als ein einfacher Image-to-Video-Clip. Sobald Dialoge, mehrere Charaktere, Referenzbewegungen oder komplexe Interaktionen ins Spiel kommen, wird die Wahl des richtigen Modells noch entscheidender.
Wenn Sie also ein KI-Videomodell für verschiedene Anwendungsfälle auswählen, beginnen Sie nicht mit der Frage, welches Modell das leistungsstärkste ist.
Stellen Sie stattdessen die bessere Frage:
Was ist die größte Herausforderung bei dem Video, das ich erstellen möchte?
Auf Movmix können Sie zunächst mit Bildmodellen wie GPT Image 2.5, Nano Banana, Grok Image oder Seedream einen starken Startframe vorbereiten und dann in die Videogenerierungsphase übergehen.
Ein praktischer Workflow sieht so aus:
Bild vorbereiten → Videomodell auswählen → Bewegung und Kameraführung beschreiben → Generieren → Das konkrete Problem lösen
Sie können beim Movmix AI Video Generator starten und das Modell basierend auf dem Anwendungsszenario statt nach dem Modellnamen auswählen.
Schnelle Antwort: Welches KI-Videomodell passt zu Ihrem Szenario?
| Videoszenario | Zuerst diese Modelle testen | Dann ausprobieren | Das ist am wichtigsten | Auf Movmix öffnen |
|---|---|---|---|---|
| Ein einzelnes Bild natürlich animieren | Wan 3.0 | Kling 4.0 | Einfache Bewegung, Konsistenz im ersten Frame | Bild zu Video |
| Produktwerbung | Wan 3.0 | MiniMax H3 (wenn Text oder Logos lesbar bleiben müssen) | Produktstruktur, Kamera, Beleuchtung | Bild zu Video |
| Mode, Reels, Charakter-Clips | Kling 4.0 | Wan 3.0 | Gesicht, Kleidung, Körperbewegung | Bild zu Video |
| Bewegung aus einem Referenzvideo übertragen | Kling 4.0 | Seedance 2.5 / Wan 3.0 | Charakteridentität vs. Referenzbewegung | Referenz zu Video |
| Storytelling mit mehreren Einstellungen | Seedance 2.5 | Kling 4.0 | Timing, Shot-Abfolge, Kontinuität | Bild zu Video / AI Story Generator |
| Dialog mit mehreren Charakteren | Kling 3.0 oder 4.0 | Seedance 2.5 / MiniMax H3 | Reihenfolge der Sprecher, Stimme, Timing | Bild zu Video |
| Komplexe Aktionen oder mehrere Personen | Seedance 2.5 | Kling 4.0 | Bewegungsbeziehungen, physische Konsistenz | Bild zu Video |
| Kreativer Workflow mit mehreren Referenzen | Seedance 2.5 | Kling 4.0 | Klare Rollen für Bild-, Video- und Audio-Referenzen | Referenz zu Video |
Dies ist keine absolute Rangliste.
Die gleiche Szene kann oft mit mehr als einem Modell erstellt werden. Die eigentliche Frage ist, welchen Teil der Aufgabe das Modell am besten bewältigen soll.
Wofür jedes Videomodell auf Movmix entwickelt wurde
Bevor Sie sich für ein Modell entscheiden, ist es hilfreich, die Grenzen der einzelnen Modelle zu kennen. Die folgenden Angaben stammen von den Movmix-Modellseiten und wurden im Oktober 2026 überprüft. Da Anbieter ihre Modelle häufig aktualisieren, sollten Sie die Modellseite vor der Planung eines längeren Projekts erneut prüfen.
| Modell | Maximale Länge pro Generierung | Auflösung | Nativer Audio-Support | Herausragende Steuerungsfunktionen | Modellseite |
|---|---|---|---|---|---|
| Wan 3.0 | Bis zu 30 s | Bis zu 1080p | Nicht für standardmäßige Text-zu-Video- oder Bild-zu-Video-Generierung | Text, Bild und Video-Referenz; starke Szenen- und Charakterkonsistenz | Wan 3.0 |
| Seedance 2.5 | Bis zu 30 s | Hängt von den Plattformeinstellungen ab | Ja | Große multimodale Referenzdatensätze, mehrstufige Erweiterung, prompt-basierte Nachbearbeitung | Seedance 2.5 |
| Kling 4.0 | Native 30 s | 4K 10-bit HDR | Ja, Stereo mit Lippensynchronisation | Bis zu 15 multimodale Referenzen und 10 Timeline-Keyframes | Kling 4.0 |
| Kling 3.0 | 3–15 s | 4K | Ja, native Stimme und mehrsprachige Dialoge | Multi-Shot-Generierung, Start- und Endbilder | Kling 3.0 |
| MiniMax H3 | Bis zu 15 s | Bis zu 2K | Ja, 32 kHz Stereo | Erstes Bild, letztes Bild oder beides; Bild-, Video- und Audio-Referenzen; Text und markenbewusste Visuals | MiniMax H3 |
Keine dieser Zahlen entscheidet allein über das Modell. Eine Obergrenze von 30 Sekunden hilft nicht, wenn sich Ihr Produkt in der vierten Sekunde verformt. Nutzen Sie die Tabelle, um Optionen auszuschließen, und wählen Sie dann anhand der unten stehenden Szenarien.
Szenario 1: Sie haben ein Bild und möchten es einfach nur natürlich bewegen
Dies ist der häufigste Anwendungsfall für die Umwandlung von Bildern in Videos.
Vielleicht haben Sie ein Porträt und möchten nur, dass sich die Person zur Kamera dreht. Oder Sie möchten, dass ein Haustier den Kopf hebt oder dass ein Stadtfoto durch subtile Bewegungen von Menschen, Bäumen und Licht lebendig wird.
Sie benötigen keine komplizierte Geschichte.
Probieren Sie Wan oder Kling aus
Für diese Art von Aufgabe ist die folgende Struktur entscheidend:
Ein Motiv + eine Hauptaktion + eine einfache Kamerabewegung
Ihr Referenzbild zeigt dem Modell bereits, wie die Person, das Produkt oder die Umgebung aussieht.
Der Video-Prompt sollte sich auf Folgendes konzentrieren:
Was passiert als Nächstes?
Zum Beispiel:
Die Figur hebt langsam den Kopf und schaut natürlich in die Kamera. Eine leichte Brise sorgt für sanfte Bewegungen im Haar, während die Kamera stabil bleibt und sich langsam nach vorne bewegt. Achten Sie darauf, dass Gesicht, Frisur, Kleidung, Körperproportionen und Hintergrund der Figur im gesamten Video konsistent bleiben.
Das Prinzip ist wichtiger als das Beispiel:
Lassen Sie den Video-Prompt nicht alles wiederholen, was das Bild bereits zeigt.
Szenario 2: Sie benötigen eine Produktanzeige, bei der das Produkt unverändert bleiben muss
Parfüm, Kopfhörer, Hautpflegeprodukte, Schuhe, Haushaltsgeräte, Getränke – das Hauptproblem ist meist nicht, wie man das Produkt in Bewegung bringt.
Es geht darum, zu verhindern, dass sich das Produkt verändert.
Wenn sich die Form eines Flaschenverschlusses nach vier Sekunden ändert oder ein Kopfhörer plötzlich neu gestaltet wird, mag das Video zwar noch attraktiv aussehen, ist aber als Werbung nicht mehr brauchbar.
Probieren Sie zuerst Wan aus
Für diesen Arbeitsablauf gilt eine nützliche Regel:
Halten Sie das Produkt ruhig. Lassen Sie Kamera, Beleuchtung und Reflexionen sich bewegen.
Vollständiger Arbeitsablauf 1: Premium-Kopfhörer-Werbung
Schritt 1: Das erste Bild vorbereiten
Wenn Sie bereits ein gutes Produktbild haben, verwenden Sie es direkt.
Falls nicht, erstellen Sie zunächst mit einem der Bildgenerierungsmodelle von Movmix ein starkes Bild im Werbestil.
| Prompt für das Startbild | Ausgabebild |
|---|---|
| Ein Premium-Paar Over-Ear-Wireless-Kopfhörer, platziert in der Mitte eines hellgrauen Sockels aus Naturstein, dunkelgrauer Metallrahmen und weiche Leder-Ohrpolster klar sichtbar, minimalistischer moderner Studio-Hintergrund, weiches Seitenlicht zur Betonung der Materialien, realistische kommerzielle Produktfotografie, Nahaufnahme aus niedriger Perspektive, saubere Komposition, 16:9, kein Text, kein Logo, kein Wasserzeichen. | 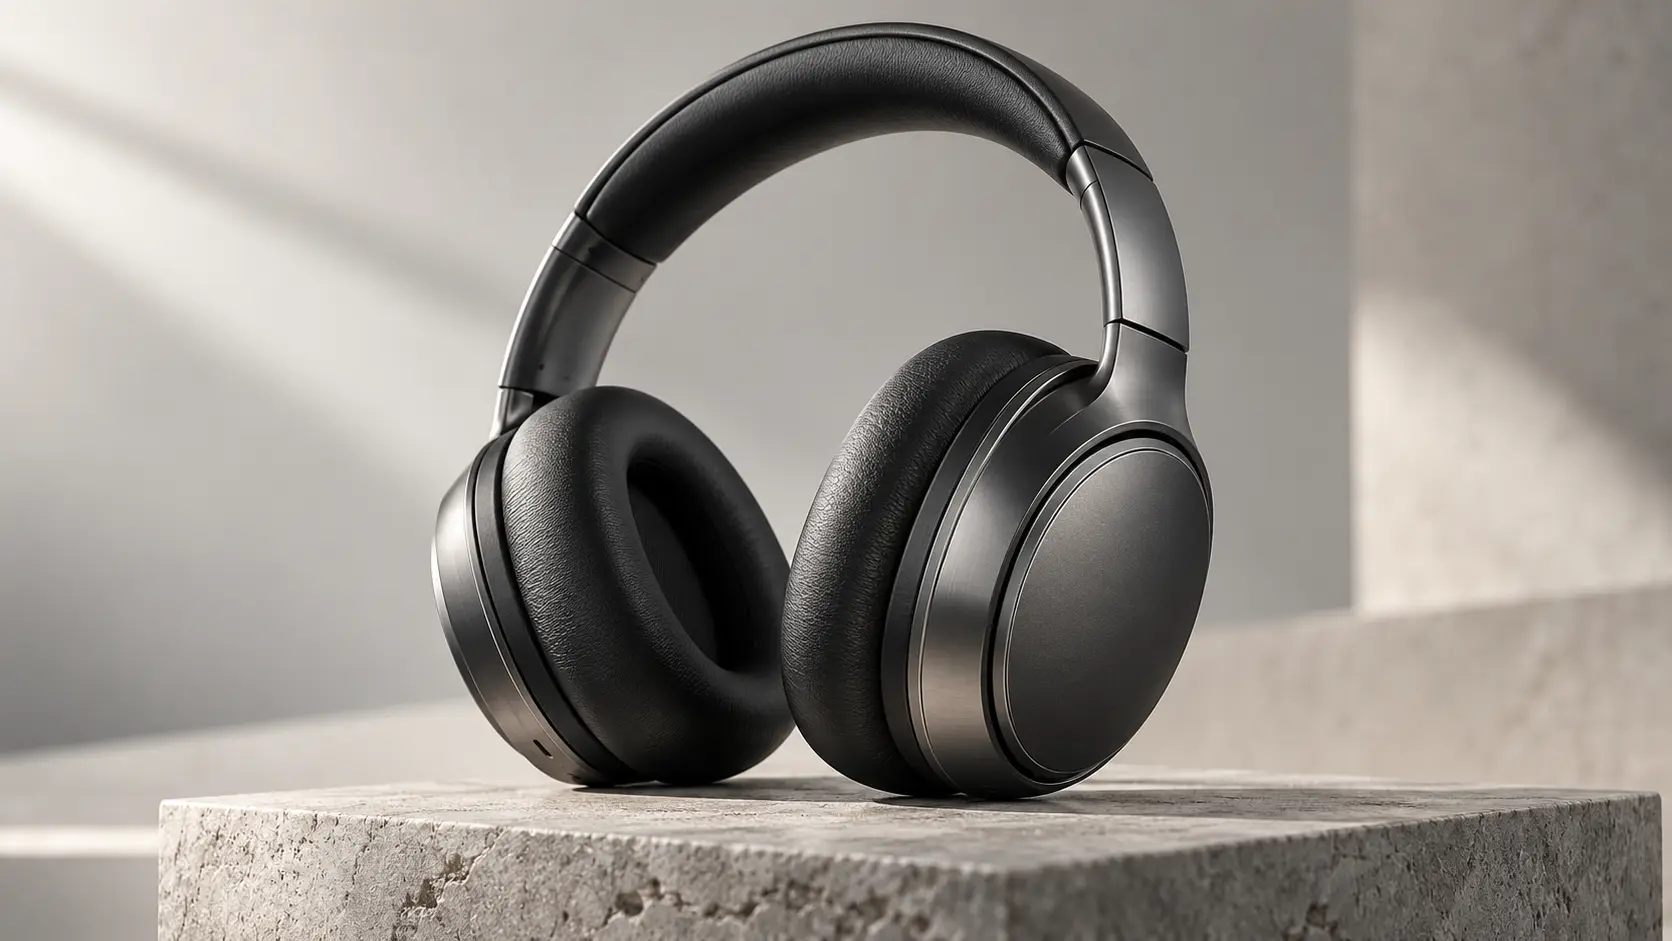 |
Schritt 2: Bild hochladen und Wan auswählen
Öffnen Sie Movmix Image to Video, laden Sie das Produktbild hoch und wählen Sie das verfügbare Wan-Videomodell aus.
Schritt 3: Nur die tatsächlich benötigte Bewegung gestalten
Video-Prompt:
Halten Sie die Kopfhörer vollständig still. Die Kamera bewegt sich langsam aus einer frontalen Dreiviertelansicht näher heran, während ein weicher Lichtstrahl allmählich über die Ohrpolster und den Metallrahmen gleitet und dabei die Texturen von Leder und Metall hervorhebt. Halten Sie den Hintergrund stabil. Beenden Sie die Aufnahme mit einer Nahaufnahme der Ohrpolster-Details. Achten Sie darauf, dass Form, Farbe, Materialien, Struktur, Bedienelemente und Proportionen der Kopfhörer während des gesamten Videos unverändert bleiben. Redesignen Sie das Produkt nicht.
Schritt 4: Beheben Sie das Problem, nicht den gesamten Prompt
Wenn sich die Form des Produkts verändert, reduzieren Sie die Bewegung des Produkts und verlagern Sie die Dynamik stattdessen auf die Kameraführung oder die Beleuchtung.
Wenn die Kamerabewegung zu schnell ist, passen Sie nur die Kamerageschwindigkeit an.
Wenn der Hintergrund ständig wechselt, weisen Sie das Modell explizit an, ihn vollständig stabil zu halten.
Das ist hilfreicher, als den gesamten Prompt nach jeder fehlgeschlagenen Generierung neu zu schreiben.
Wenn Verpackungstext oder ein Logo lesbar bleiben muss
Einige Produktvideos scheitern aus einem anderen Grund: Die Form bleibt erhalten, aber das Etikett wird zu unleserlichem Kauderwelsch. Wenn Ihre Aufnahme auf einen lesbaren Markennamen, Verpackungstext oder einen kurzen Slogan angewiesen ist, lohnt es sich, MiniMax H3 neben Wan 3.0 zu testen, da Textdarstellung und markenbewusste Visuals zu den Kernkompetenzen dieses Modells gehören.
Halten Sie die Anweisung präzise. Benennen Sie den exakten Text, der lesbar bleiben muss, führen Sie die Kamerabewegung langsam aus und vermeiden Sie eine vollständige Rotation des Produkts, da erfundener Text meist auf der Rückseite der Verpackung erscheint.
Beispiel-Prompt:
Die Hautpflegeflasche steht aufrecht und unbewegt auf dem Steinsockel. Die Kamera führt eine langsame Push-in-Bewegung aus der Frontalansicht durch, während sanftes Licht über das Glas gleitet. Halten Sie den Label-Text „AURA SERUM“ während des gesamten Videos scharf, korrekt geschrieben und lesbar. Drehen Sie die Flasche nicht. Fügen Sie keinen neuen Text hinzu. Ruhige Studioatmosphäre.
Szenario 3: Sie möchten Mode-, Reels- oder charakterfokussierte Social-Media-Videos
Charaktervideos haben einen völlig anderen Fehlermodus.
Bei einem Produkt sorgen Sie sich um die Form.
Bei einer Person sorgen Sie sich um Folgendes:
Die Person in der ersten Sekunde sieht am Ende nicht mehr wie dieselbe Person aus.
Testen Sie Kling oder Wan
Für Mode, Lifestyle, virtuelle Charaktere und Social-Media-Clips sollten Sie sich auf drei Dinge konzentrieren:
Konsistente Identität + einfache Aktion + klare Kamerabewegung
Zum Beispiel:
Die Frau geht langsam auf die Kamera zu, richtet sanft den Ärmel ihrer Jacke und blickt dann natürlich in die Linse. Die Kamera fährt dabei gleichmäßig nach hinten, während sie eine mittlere Einstellung beibehält. Achten Sie darauf, dass Gesicht, Frisur, Kleidung, Körperproportionen und Identität im gesamten Video konsistent bleiben.
Wenn die Aktion einfach ist, sind sowohl Wan als auch Kling vernünftige Optionen zum Testen.
Wenn die Aufnahme komplexere Körperbewegungen, Kamera-Tracking oder mehrere Referenz-Assets umfasst, ist Kling die relevantere Wahl für Tests.
| Bild-Prompt | |
|---|---|
| 16:9-Horizontalbild einer europäischen Frau, die in einem modernen Kunstgalerie-Korridor steht. Sie trägt eine elegante dunkelgraue kurze Jacke, ein weißes Oberteil und eine schwarze Hose und bereitet sich natürlich darauf vor, nach vorne zu gehen. Klare Gesichtsdetails, moderne architektonische Linien im Hintergrund, weiches natürliches Licht, realistische Premium-Modefotografie, Halb- bis Ganzkörperaufnahme, kein Text, kein Logo, kein Wasserzeichen. | 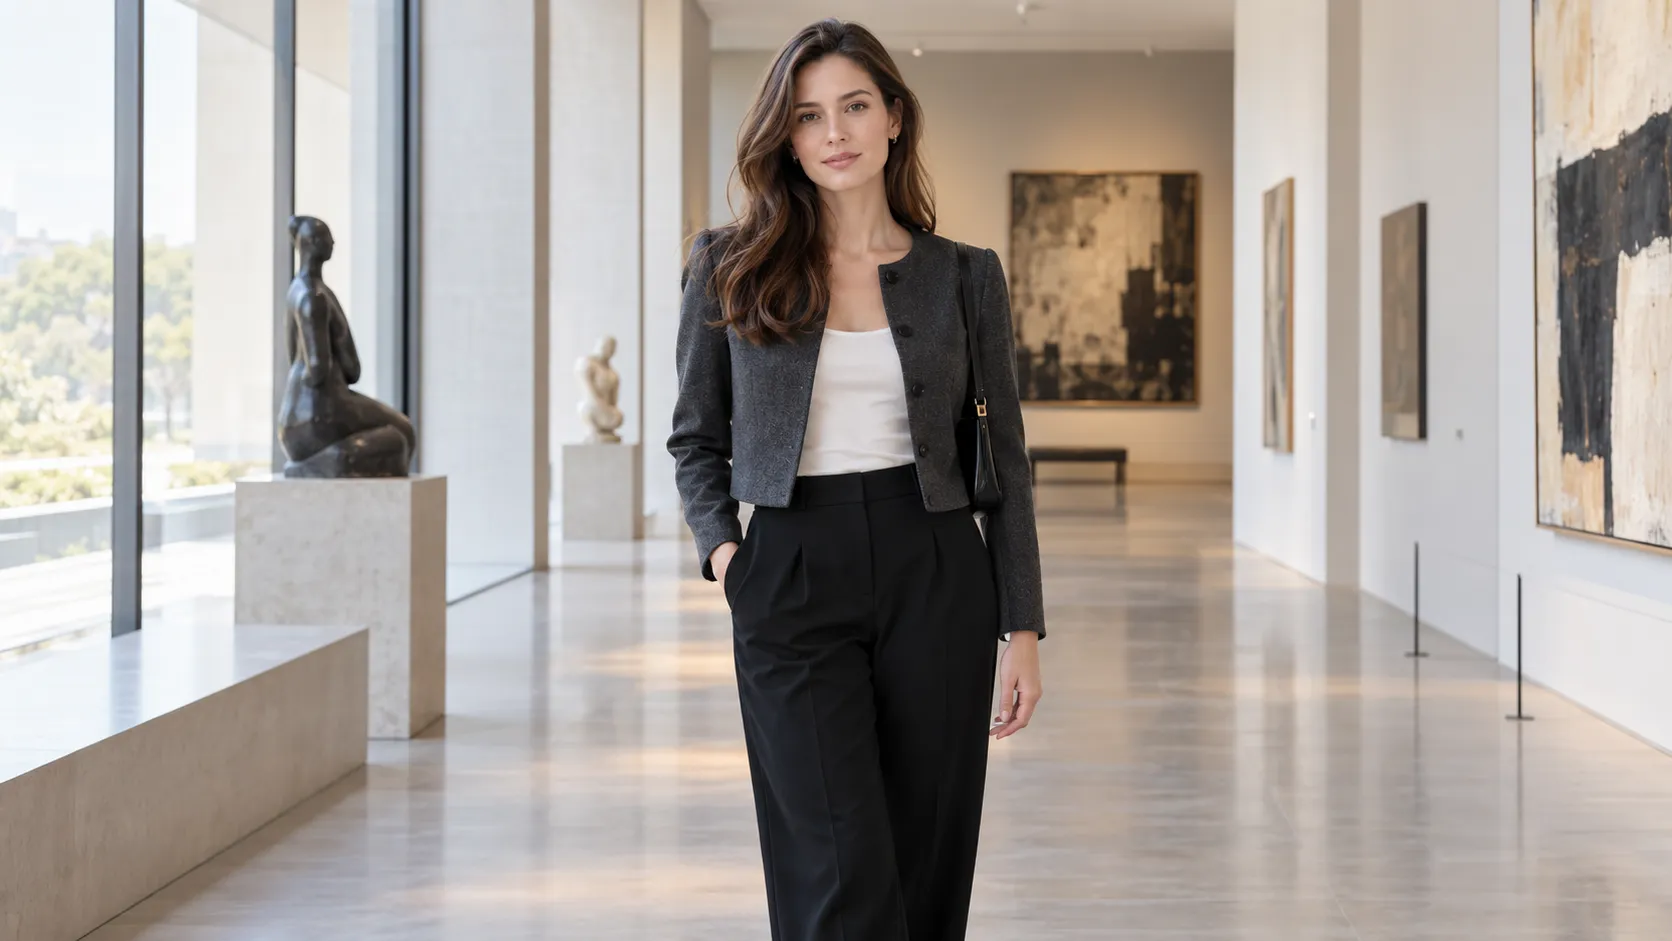 |
Dreharbeiten für Reels und TikTok: Verwenden Sie ein vertikales Startbild
Wenn der Clip für Instagram Reels oder TikTok gedacht ist, generieren Sie das erste Bild im Format 9:16, anstatt später ein 16:9-Ergebnis zuzuschneiden. Durch das Zuschneiden werden Schultern und Füße abgeschnitten, die das Modell benötigt, um die Körperkonsistenz zu wahren, und das Gesicht landet oft am Rand des Bildausschnitts.
Halten Sie das gesamte Outfit im Bild, lassen Sie etwas Platz über dem Kopf und beschreiben Sie eine Aktion, die der Zuschauer auf einem kleinen Bildschirm leicht erkennen kann: eine Drehung, ein Schritt, ein Blick in die Linse. Für vorgefertigte Social-Media-Formate decken die Reel Ready-Vorlagen Behind-the-Scenes-Clips, tägliche Vlogs und Red-Carpet-Übergänge ab, ohne dass ein Prompt geschrieben werden muss.
Szenario 4: Sie haben ein Charakterbild und möchten die Bewegung aus einem anderen Video kopieren
Dies ist kein gewöhnliches Image-to-Video mehr.
Sie haben nun zwei verschiedene Referenzen, die unterschiedliche Aufgaben erfüllen.
Das Bild beantwortet:
Wer soll auftreten?
Das Video beantwortet:
Wie soll sich die Person bewegen?
Sie haben beispielsweise ein Porträt einer Person und ein separates Sport-, Tanz- oder Performancevideo. Sie möchten, dass die Person auf dem Bild die Bewegungen aus dem Video ausführt.
Testen Sie die Referenz-Workflows von Kling, Seedance oder Wan
Die wichtigste Regel in diesem Szenario lautet:
Reference Image = WhoReference Video = How
Sagen Sie dem Modell nicht einfach:
„Mach es wie die Referenz.“
Geben Sie genau an, was jede Referenz steuert.
Vollständiger Workflow 2: Basketball-Bewegungen auf eine andere Figur übertragen
Angenommen, Sie haben:
Bild A: eine erwachsene männliche Figur
Video B: ein Athlet, der schnelles Dribbling und eine Drehbewegung ausführt
Das Ziel ist es nicht, den Athleten aus Video B neu zu generieren.
Das Ziel ist es, die Figur aus Bild A die Bewegung aus Video B ausführen zu lassen.
Video-Prompt
Verwenden Sie Bild A als Referenz für die Identität und das Erscheinungsbild der Figur. Behalten Sie die Gesichtszüge, Frisur, Kleidung, Körperproportionen und die Identität der Figur konsistent bei. Nutzen Sie Video B als Referenz für Bewegung, Rhythmus und Körperdynamik. Lassen Sie die Figur aus Bild A dem gleichen Dribbling-Rhythmus, der Drehbewegung und den Gewichtsverlagerungen folgen, die in Video B gezeigt werden. Bewahren Sie die natürliche menschliche Physik. Kopieren Sie nicht das Gesicht oder die Identität der Person in Video B. Folgen Sie der Kamerabewegung aus Video B, während Sie die Umgebung stabil halten.
Das Ergebnis verdeutlicht die Idee besser als jede Erklärung: Eine Referenz steuert die Identität. Eine andere steuert die Bewegung.
Reference to Video, Video to Video, or AI Recast?
Movmix bietet drei Tools, die alle eine Figur mit bestehender Bewegung kombinieren. Sie lösen unterschiedliche Probleme, daher lohnt es sich, die Wahl bewusst zu treffen.
- Referenz zu Video: Starten Sie mit einem Charakterbild und einem Bewegungsclip und generieren Sie ein komplett neues Video, in dem Ihre Figur diese Bewegung ausführt. Verwenden Sie dies, wenn Sie eine neue Szene erstellen möchten.
- Video zu Video: Starten Sie mit einem bestehenden Video und übertragen Sie dessen Bewegung auf einen neuen Look oder Stil. Verwenden Sie dies, wenn das Originalmaterial die Basis bildet und Sie es neu gestalten möchten.
- AI Recast: Starten Sie mit einem bestehenden Video und tauschen Sie die darin befindliche Person gegen eine andere Figur aus, wobei die ursprüngliche Bewegung beibehalten wird. Verwenden Sie dies, wenn das Filmmaterial passend ist und nur der Darsteller geändert werden muss.
Wenn Sie unsicher sind, fragen Sie sich, was Sie beibehalten möchten. Bewegung behalten und neue Szene erstellen: Referenz zu Video. Filmmaterial behalten und Stil ändern: Video zu Video. Filmmaterial behalten und Person ändern: AI Recast.
Szenario 5: Sie möchten eine kleine Geschichte, nicht nur eine einzelne Aktion
Sobald Ihre Anfrage so klingt:
Die Figur führt A aus, dann geschieht B, danach bemerkt sie C und reagiert schließlich darauf.
Sie erstellen keinen einfachen Bewegungsklip mehr.
Sie erschaffen eine Geschichte.
Seedance ausprobieren
Für diese Art von Inhalt sollte der Prompt aufhören, sich wie eine Sammlung visueller Adjektive zu verhalten.
Er sollte eine Sequenz beschreiben:
Was passiert zuerst → was verändert sich → wie folgt die Kamera → wo endet die Szene
Kompletter Workflow 3: Eine unerwartete Entdeckung in einer Sternwarte
Schritt 1: Erstellen des ersten Frames
| Bild-Prompt | Ausgabe |
|---|---|
| Ein 35-jähriger erwachsener männlicher Astronomieforscher steht in einer ruhigen Bergsternwarte, trägt einen dunkelblauen Strickpullover und eine dunkle Hose, zeichnet Beobachtungsdaten neben einem großen Teleskop auf, ein Notizbuch und einfache wissenschaftliche Geräte liegen auf dem Tisch, durch die Öffnung der Kuppel ist der klare Nachthimmel sichtbar, realistische Dokumentarfotografie, mittlere Einstellung, ruhiges natürliches Innenlicht, 16:9. | 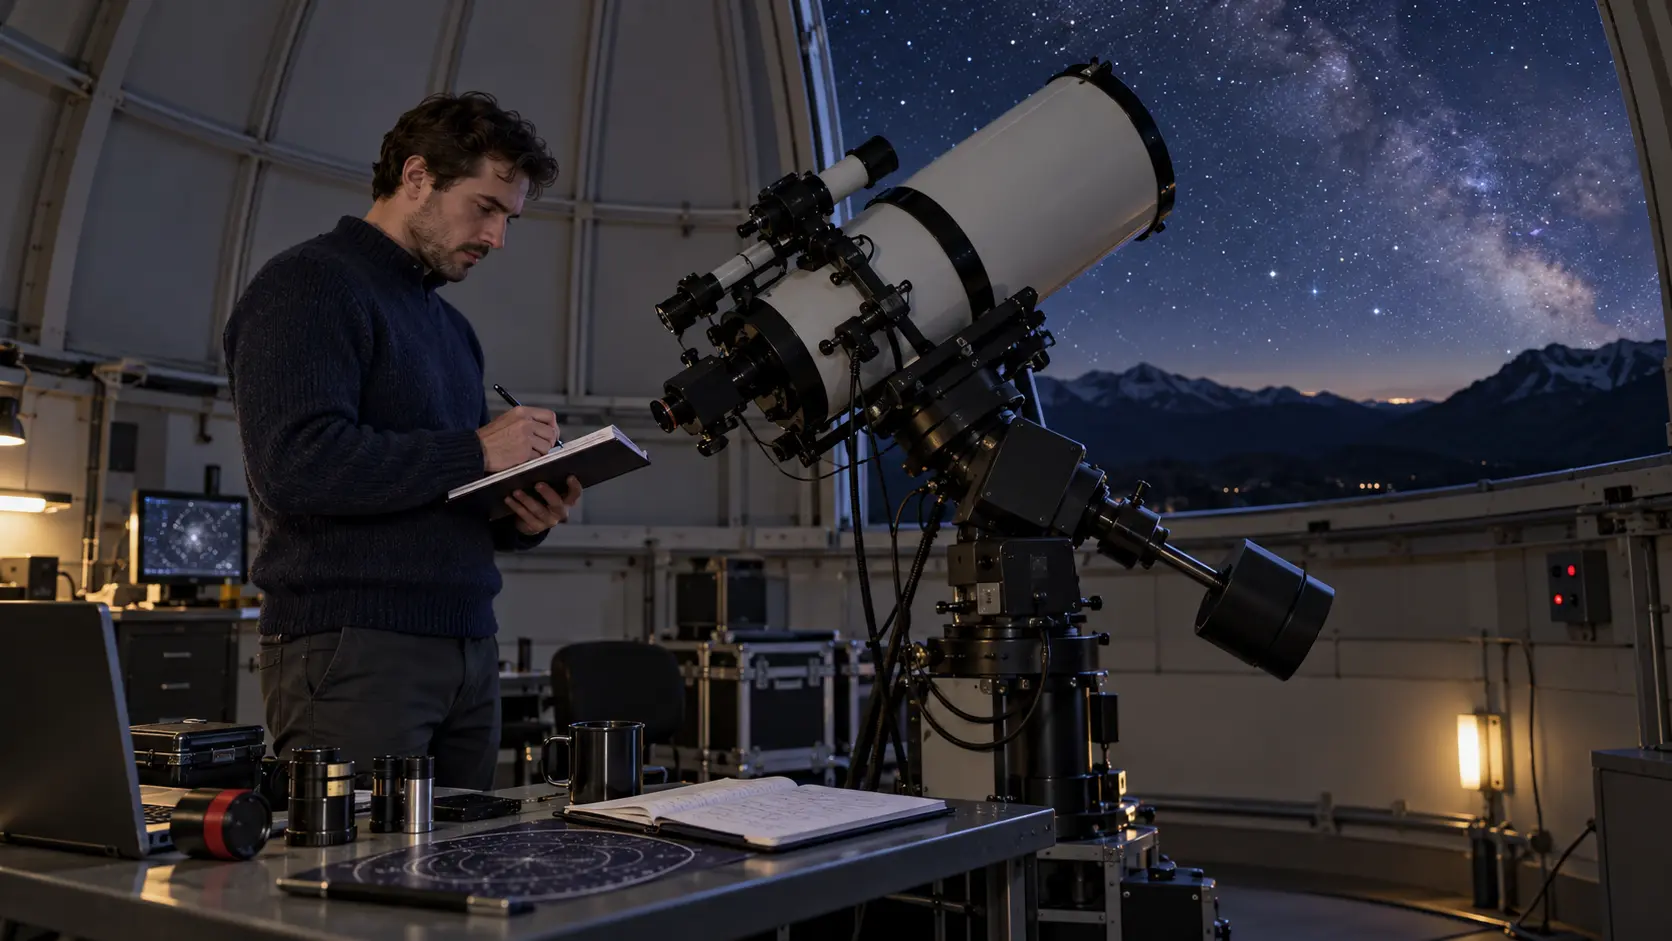 |
Schritt 2: Seedance auswählen
Diesmal brauchen wir mehr als nur eine einzelne Bewegung.
Wir brauchen ein Ereignis.
Video-Prompt
Der Forscher blickt nach unten und notiert Daten im Notizbuch. Ein kurzer Warnton ertönt von den nearby Geräten. Er hört auf zu schreiben, hebt den Kopf, schaut zum Überwachungsgerät und geht dann schnell zum Teleskop, um den Himmel zu beobachten. Die Kamera folgt ihm seitlich und wechselt dann in seine Perspektive, während ein heller Komet langsam über den fernen Nachthimmel zieht. Das Ende zeigt eine Aufnahme, die sowohl den Forscher als auch den Kometen außerhalb des Observatoriumsfensters einfängt. Achten Sie darauf, die Identität des Forschers, die Struktur des Observatoriums und die nächtliche Umgebung konsistent zu halten. Fügen Sie einen subtilen Gerätealarm, leise Schreibgeräusche und eine ruhige Innenraum-Atmosphäre hinzu.
Die wichtige Lektion hierbei ist nicht der Prompt selbst.
Es geht darum zu wissen, wann Ihr Projekt vom bloßen „In-Bewegung-Sein“ zum „Storytelling“ übergeht.
Wenn die Geschichte mehr als einen Clip benötigt
Selbst bei 30 Sekunden hat eine einzelne Generierung ihre Grenzen. Wenn Ihr Outline mehr Handlungspunkte enthält, als ein einzelner Clip fassen kann, planen Sie die Geschichte als Sequenz, anstatt sie in einen einzigen Prompt zu zwängen.
Erstellen Sie zuerst das Outline, legen Sie die Hauptfigur mit einem Referenzbild fest und generieren Sie dann Szene für Szene. Wenn ein Clip zum richtigen Moment endet, aber etwas zu früh abbricht, setzen Sie ihn mit Video Extend fort, statt von vorne zu beginnen. Für eine geführte Version dieses Workflows verwandelt der AI Story Generator eine einzige Idee in eine Handlung, visuelle Elemente und Voiceover.
Sobald Dialoge ins Spiel kommen, ändern sich Ihre Auswahlkriterien erneut.
Das Modell muss nun mehr verwalten als nur ansprechende visuelle Effekte.
Es muss außerdem Folgendes berücksichtigen:
Charakteridentität, Reihenfolge der Sprecher, Stimme, Timing und Mundbewegungen
Probieren Sie Kling oder Seedance aus
Schreiben Sie nicht einfach:
Zwei Designer diskutieren über ein Projekt.
Das lässt fast alles undefiniert.
Eine bessere Struktur wäre:
Charakter A spricht zuerst → Charakter B reagiert → Charakter B antwortet → Kamerawechsel → Umgebung bleibt stabil
Sobald Dialoge relevant sind, wird Audio Teil der Szenenlogik und nicht nur ein optionales Extra.
Beispiel für einen Dialog-Prompt
Zwei Designer sitzen sich in einem hellen Studio an einem kleinen Tisch gegenüber, ein gedrucktes Poster liegt zwischen ihnen. Die Frau links tippt auf das Poster und sagt: „Die Überschrift ist zu klein.“ Der Mann rechts lehnt sich zurück, betrachtet es kurz und antwortet: „Dann machen wir das ganze Poster darüber.“ Sie lacht. Die Kamera beginnt mit einer Zweier-Einstellung, schneidet auf eine Nahaufnahme des Mannes, während er antwortet, und kehrt dann zur Zweier-Einstellung zurück. Lassen Sie beide Gesichter, Outfits und das Studio unverändert. Natürlicher Raumklang, leichte Papiergeräusche, keine Musik.
Achten Sie darauf, was der Prompt festlegt: Wer spricht zuerst, die exakten Worte, wer reagiert und wo die Kamera bei jeder Zeile positioniert ist. Kling 3.0 und Kling 4.0 generieren Stimme zusammen mit dem Bild, und MiniMax H3 sowie Seedance 2.5 erzeugen ebenfalls nativen Audio-Output. Es lohnt sich also, diesen Prompt mit zwei dieser Modelle auszuführen und die Lippensynchronisation zu vergleichen, bevor Sie sich festlegen.
Szenario 7: Komplexe Aktionen, Sport, Performance oder mehrere Personen
In diesen Szenarien werden AI-Videomodelle meist besonders stark gefordert.
Beispiele sind Sportarten mit zwei Personen, koordinierte Performances, mehrere sich gleichzeitig bewegende Charaktere, physische Interaktionen oder eine Kamera, die sich um mehrere Subjekte herum bewegen muss.
Probieren Sie Seedance oder Kling aus
Die wichtigste Erkenntnis hier ist überraschend einfach:
Komplexität lässt sich nicht durch einen längeren Satz lösen.
Brechen Sie die Beziehungen auf.
Statt:
Zwei Personen führen eine intensive Aktion aus, während sich die Kamera kinematografisch bewegt.
Definieren Sie:
Charakter A startet hier. Charakter B startet dort. Charakter A bewegt sich zuerst. Charakter B reagiert. An diesem Punkt interagieren sie. Die Kamera ist hier positioniert.
Je komplizierter die Bewegung, desto wichtiger wird es zu erklären, wer was tut.
Das ist weitaus nützlicher, als zusätzliche Wörter wie „dynamisch“, „episch“ oder "high-energy" hinzuzufügen.
Beispiel: Zwei Tänzer, eine Kameraumkreisung
Zwei Tänzer stehen sich bei Sonnenuntergang auf einem leeren Dach gegenüber. Der Tänzer in der roten Jacke beginnt zuerst mit drei scharfen Armbewegungen, während der Tänzer in Weiß stillsteht. Auf dem vierten Takt antwortet der Tänzer in Weiß mit denselben drei Bewegungen, gespiegelt. Dann treten beide aufeinander zu und frieren Rücken an Rücken ein. Die Kamera umkreist sie während der gesamten Sequenz langsam auf Taillenhöhe und endet mit einer Frontansicht der Finalpose. Achten Sie darauf, dass Gesichter, Outfits und Körperproportionen beider Tänzer konsistent bleiben. Leichter Wind und städtische Ambient-Geräusche.
Szenario 8: Sie verfügen bereits über Bilder, Videos, Audio und Storyboards
Sometimes the problem is not a lack of material.
Es liegt an zu viel Material.
Sie verfügen möglicherweise bereits über:
- Charakterbilder
- Umgebungsreferenzen
- Bewegungsvideos
- Musik
- Soundeffekte
- Storyboard images
An diesem Punkt wird die Herausforderung zum Referenzmanagement.
Seedance ausprobieren
Der Schlüssel liegt nicht darin, so viel Material wie möglich hochzuladen.
Entscheidend ist, dass jede Referenz eine klare Aufgabe hat.
Zum Beispiel:
Bild A steuert die Figur. Bild B steuert die Umgebung. Video C steuert die Kamerabewegung. Audio D steuert den Klangstil.
Wenn Sie nicht festgelegt haben, wofür jede Referenz zuständig ist, muss das Modell raten.
Und sobald das Modell zu raten beginnt, können zusätzliche Referenzen den Workflow eher verwirren als mehr Kontrolle bieten.
Seedance 2.5 ist hier das erste Modell, das Sie ausprobieren sollten, da es für große Referenzsets konzipiert ist. Kling 4.0 ist die nächste Option, wenn Sie auch Timeline-Keyframes benötigen. Laden Sie in jedem Fall im Tool Reference to Video hoch, benennen Sie jede Datei im Prompt entsprechend ihrer Aufgabe und lassen Sie Dateien ohne klare Funktion weg.
Der erste Clip ist nahe dran, aber nicht perfekt: Verlängern, bearbeiten oder neu generieren?
Die Wahl des richtigen Modells bringt Sie näher ans Ziel, doch das erste Ergebnis ist selten das finale. Bevor Sie das Modell wechseln, analysieren Sie, um welche Art von Problem es sich handelt.
- The clip is good but ends too soon: extend it. Video Extend continues the existing clip so you keep everything that already works.
- Der Clip ist gut, bis auf ein Element, z. B. ein Outfit oder einen Hintergrund: Bearbeiten Sie ihn. Der AI Video Editor arbeitet ein bestehendes Video basierend auf einer Textanweisung neu.
- Bewegung, Identität oder Produkt sind von Anfang an falsch: Generieren Sie den Clip neu und ändern Sie im Prompt schrittweise jeweils nur einen Aspekt.
- Das gleiche Problem tritt auch nach zwei oder drei gezielten Wiederholungsversuchen auf: Probieren Sie nun das nächste Modell aus der Übersicht für schnelle Lösungen.
Der Wechsel des Modells sollte der letzte Schritt sein, nicht die erste Reaktion.
Welches KI-Videomodell sollten Sie also verwenden?
Beginnen Sie nicht mit:
„Ist Wan, Seedance oder Kling das stärkste Modell?“
Stellen Sie stattdessen drei nützlichere Fragen.
Welches Material habe ich bereits?
Nur Text? Ein Bild? Oder Bilder, Referenzvideos und Audio?
Was ist die schwierigste Komponente dieses Videos?
Produktkonsistenz? Charakteridentität? Bewegung? Storytelling? Dialoge? Interaktion zwischen mehreren Charakteren?
Was darf auf keinen Fall schiefgehen?
Das Gesicht? Die Produktstruktur? Die Bewegung? Die Szenenkontinuität?
Diese Fragen liefern Ihnen in der Regel weit mehr Erkenntnisse als ein generischer Vergleich von KI-Videomodellen.
Wenn Sie nur ein Produktbild in eine saubere Werbeaufnahme verwandeln müssen, brauchen Sie wahrscheinlich nicht mit einer komplizierten Geschichte aus mehreren Einstellungen zu beginnen.
Wenn Sie möchten, dass ein Charakter die Bewegungen aus einem anderen Video ausführt, reicht ein normaler Image-to-Video-Workflow nicht mehr aus.
Und wenn Ihr Skript sich zunehmend mit Wörtern wie:
„dann“, „danach“, „plötzlich“ und „schließlich“ füllt...
erstellen Sie wahrscheinlich keinen einfachen Clip mehr.
Sie erzählen eine Geschichte.
Ihre Modellwahl sollte sich an der Aufgabe orientieren. Wenn Sie diese Modelle nebeneinander mit demselben Prompt testen möchten, starten Sie im AI Video Generator und wechseln Sie die Modelle, ohne die Seite zu verlassen.
Goldene Regel: Wähle zuerst das Video, dann das Modell
Der Wert mehrerer Modelle auf Movmix liegt nicht einfach darin, dass es mehr Buttons zum Klicken gibt.
Der wahre Vorteil ist, dass unterschiedliche Aufgaben verschiedene Workflows nutzen können.
Nutze Bildmodelle wie GPT Image 2.5, Nano Banana, Grok Image oder Seedream, um den gewünschten visuellen Ausgangspunkt vorzubereiten.
Wähle dann Wan, Seedance, Kling oder ein anderes verfügbares Videomodell basierend darauf, was in der Szene als Nächstes passieren soll.
Das Bild bestimmt:
Wie sieht es aus?
Das Videomodell bestimmt:
Was passiert als Nächstes?
Und dein Prompt bestimmt:
Wie soll es passieren?
Wenn du also unsicher bist, welches KI-Videomodell du wählen sollst, vergiss die Modellnamen für einen Moment.
Beschreibe zunächst das Video, das du tatsächlich erstellen möchtest.
Von dort aus wird die Wahl des richtigen Modells meist viel einfacher.
FAQ: Auswahl eines KI-Videomodells
F: Welches KI-Videomodell ist insgesamt das beste?
A: Es gibt nicht das eine beste Modell. Wan 3.0 ist eine starke erste Wahl für stabile Produktaufnahmen und einfache Bildanimationen, Seedance 2.5 für kurze Geschichten und große Referenzdatensätze, Kling für Charakterdarstellung, Bewegung und Dialoge sowie MiniMax H3 für kurze Markenclips, bei denen der Text lesbar bleiben muss. Wählen Sie basierend auf der schwierigsten Komponente Ihres Videos.
F: Welches KI-Videomodell sollte ich für Produktwerbung verwenden?
A: Beginnen Sie mit Wan 3.0 und halten Sie das Produkt still, während sich Kamera und Licht bewegen. Wenn Etiketten, Logos oder Verpackungstexte lesbar bleiben müssen, testen Sie auch MiniMax H3. Laden Sie Ihr Produktfoto in „Image to Video“ hoch und fixieren Sie die Form, Farbe und Materialien des Produkts im Prompt.
F: Welches Modell eignet sich am besten zum Kopieren von Bewegungen aus einem anderen Video?
A: Verwenden Sie einen Referenz-Workflow statt einer einfachen Bild-zu-Video-Konvertierung. Kling ist das erste Modell, das Sie ausprobieren sollten, wobei Seedance 2.5 und Wan 3.0 Alternativen darstellen. Laden Sie das Charakterbild und den Bewegungsclip in „Reference to Video“ hoch und geben Sie an, welche Datei die Identität und welche die Bewegung steuert.
F: Kann ich in demselben Projekt mehr als ein KI-Videomodell verwenden?
A: Ja. Viele Projekte funktionieren so am besten: Erstellen Sie den ersten Frame mit einem Bildmodell wie GPT Image 2.5 oder Nano Banana, animieren Sie die Produktaufnahmen mit einem Videomodell und generieren Sie die Dialogszene mit einem anderen. Auf Movmix sind all diese Modelle über dasselbe Konto verfügbar.
F: Wie lang kann ein KI-Video auf Movmix sein?
A: Das hängt vom Modell ab. Wan 3.0, Seedance 2.5 und Kling 4.0 generieren bis zu 30 Sekunden in einem Durchgang, während Kling 3.0 und MiniMax H3 bis zu 15 Sekunden erreichen. Für längere Videos setzen Sie einen Clip mit „Video Extend“ fort oder planen Sie die Geschichte Szene für Szene.
F: Sollte ich das Modell wechseln, wenn eine Generierung fehlschlägt?
A: Nicht sofort. Ändern Sie zuerst eine Sache im Prompt, z. B. die Kamerageschwindigkeit oder eine Anweisung zur Konsistenz. Wenn das gleiche Problem nach zwei oder drei gezielten Wiederholungsversuchen weiterhin besteht, probieren Sie das nächste Modell für dieses Szenario aus.