Cuando una plataforma de vídeo con IA te ofrece varios modelos, la decisión más difícil a menudo no es el prompt, sino el modelo.
Wan 3.0, Seedance 2.5, Kling 4.0 y MiniMax H3 están todos disponibles en Movmix, y cada uno puede convertir una imagen o un prompt en vídeo. Sin embargo, no son intercambiables. Cada uno destaca en una parte diferente del proceso: mantener un producto sin cambios, conservar la estabilidad facial, replicar el movimiento desde un clip de referencia, contar una historia breve o hacer que dos personajes conversen.
Esta guía responde a una pregunta: ¿qué modelo de vídeo con IA deberías usar para el vídeo que estás creando ahora mismo? Comienza con la tabla de respuestas rápidas y luego salta al escenario que se ajuste a tu proyecto.
Un anuncio de producto plantea problemas diferentes a los de un Reel de moda. Una escena basada en una narrativa necesita controles distintos a los de un simple clip de imagen a vídeo. Cuando aparecen diálogos, múltiples personajes, movimiento de referencia o interacciones complejas, la elección del modelo importa aún más.
Así que, al elegir un modelo de vídeo con IA para diferentes casos de uso, no empieces preguntándote cuál es el modelo más potente.
Empieza con una pregunta mejor:
¿Cuál es la parte más difícil del vídeo que intento crear?
En Movmix, puedes preparar primero un fotograma inicial sólido con modelos de imagen como GPT Image 2.5, Nano Banana, Grok Image o Seedream, y luego pasar a la etapa de generación de vídeo.
Un flujo de trabajo práctico sería así:
Preparar la imagen → Elegir el modelo de vídeo → Describir el movimiento y la cámara → Generar → Solucionar el problema real
Puedes empezar desde el Generador de Vídeo con IA de Movmix y elegir el modelo según el escenario, en lugar de hacerlo por el nombre del modelo.
Respuesta rápida: ¿Qué modelo de vídeo con IA se adapta a tu escenario?
| Escenario de vídeo | Modelos para probar primero | Luego prueba | Lo más importante | Abrir en Movmix |
|---|---|---|---|---|
| Animar una sola imagen de forma natural | Wan 3.0 | Kling 4.0 | Movimiento simple, coherencia en el primer fotograma | Imagen a vídeo |
| Publicidad de productos | Wan 3.0 | MiniMax H3 (cuando el texto o los logotipos deben permanecer legibles) | Estructura del producto, cámara e iluminación | Imagen a vídeo |
| Moda, Reels y clips de personajes | Kling 4.0 | Wan 3.0 | Rostro, ropa y movimiento corporal | Imagen a vídeo |
| Transferir movimiento desde un vídeo de referencia | Kling 4.0 | Seedance 2.5 / Wan 3.0 | Identidad del personaje frente al movimiento de referencia | Referencia a vídeo |
| Narrativa con múltiples planos | Seedance 2.5 | Kling 4.0 | Temporización, progresión de planos y continuidad | Imagen a vídeo / Generador de historias con IA |
| Diálogo entre varios personajes | Kling 3.0 o 4.0 | Seedance 2.5 / MiniMax H3 | Orden de los hablantes, voz y temporización | Imagen a vídeo |
| Acciones complejas o varias personas | Seedance 2.5 | Kling 4.0 | Relaciones de movimiento y coherencia física | Imagen a vídeo |
| Flujo de trabajo creativo con múltiples referencias | Seedance 2.5 | Kling 4.0 | Roles claros para las referencias de imagen, vídeo y audio | Referencia a vídeo |
Esta no es una clasificación absoluta.
La misma escena suele poder crearse con más de un modelo. La verdadera cuestión es qué parte de la tarea necesitas que el modelo gestione mejor.
Para qué está diseñado cada modelo de vídeo en Movmix
Antes de elegir un modelo por su nombre, es útil conocer los límites dentro de los cuales opera cada uno. Las cifras siguientes se han extraído de las páginas de modelos de Movmix y se verificaron en octubre de 2026. Los proveedores de modelos actualizan sus herramientas con frecuencia, así que consulta la página del modelo antes de planificar un proyecto a largo plazo.
| Modelo | Duración máxima por generación | Resolución | Audio nativo | Controles destacados | Página del modelo |
|---|---|---|---|---|---|
| Wan 3.0 | Hasta 30 s | Hasta 1080p | No apto para conversión estándar de texto o imagen a vídeo | Texto, imagen y referencia a vídeo; gran consistencia en escenas y personajes | Wan 3.0 |
| Seedance 2.5 | Hasta 30 s | Depende de la configuración de la plataforma | Sí | Grandes conjuntos de referencia multimodal, extensión multironda y reedición basada en prompts | Seedance 2.5 |
| Kling 4.0 | Nativo de 30 s | HDR de 10 bits en 4K | Sí, estéreo con sincronización labial | Hasta 15 referencias multimodales y 10 fotogramas clave en la línea de tiempo | Kling 4.0 |
| Kling 3.0 | 3–15 s | 4K | Sí, voz nativa y diálogo multilingüe | Generación de múltiples tomas, fotogramas de inicio y fin | Kling 3.0 |
| MiniMax H3 | Hasta 15 s | Hasta 2K | Sí, estéreo a 32 kHz | First frame, last frame or both; image, video and audio references; text and brand-aware visuals | MiniMax H3 |
Ninguna de estas cifras determina por sí sola el modelo. Un límite de 30 segundos no sirve de nada si tu producto cambia de forma en el cuarto segundo. Utiliza la tabla para descartar opciones y luego emplea los escenarios siguientes para elegir.
Escenario 1: Tienes una imagen y solo quieres que se mueva de forma natural
Este es el caso de uso más común de imagen a vídeo.
Quizás tengas un retrato y solo quieras que la persona gire hacia la cámara. Tal vez quieras que una mascota levante la cabeza, o que una foto de una ciudad cobre un movimiento sutil con personas, árboles y luz.
No necesitas una historia complicada.
Prueba Wan o Kling
Para este tipo de tarea, la estructura importante es:
Un sujeto + una acción principal + un movimiento de cámara simple
Tu imagen de referencia ya le indica al modelo cómo es la persona, el producto o el entorno.
El prompt de vídeo debería centrarse en:
¿Qué sucede después?
Por ejemplo:
El personaje levanta lentamente la cabeza y mira naturalmente hacia la cámara. Una brisa ligera crea un movimiento sutil en el cabello mientras la cámara permanece estable y avanza lentamente. Mantén consistente el rostro, el peinado, la ropa, las proporciones corporales y el fondo del personaje durante todo el vídeo.
El principio importa más que el ejemplo:
No hagas que el prompt de vídeo repita todo lo que la imagen ya muestra.
Escenario 2: Necesitas un anuncio de producto y el producto no debe cambiar
Perfumes, auriculares, productos para el cuidado de la piel, zapatos, electrodomésticos, bebidas... el principal problema suele ser cómo hacer que el producto se mueva.
El reto está en evitar que el producto cambie.
Si la tapa de una botella cambia de forma después de cuatro segundos o unos auriculares se rediseñan de repente, el vídeo puede seguir siendo atractivo, pero ya no sirve como anuncio.
Prueba Wan primero
Para este tipo de flujo de trabajo, una regla útil es:
Mantén el producto estático. Deja que la cámara, la iluminación y los reflejos se muevan.
Flujo de trabajo completo 1: Anuncio premium de auriculares
Paso 1: Prepara el primer fotograma
Si ya tienes una buena imagen del producto, úsala directamente.
Si no es así, crea primero una imagen de estilo publicitario impactante con uno de los modelos de generación de imágenes de Movmix.
| Prompt para la imagen del primer fotograma | Imagen de salida |
|---|---|
| Unos auriculares inalámbricos premium de diadema colocados en el centro de un pedestal de exhibición de piedra natural gris claro, con marco metálico gris oscuro y almohadillas de cuero suave claramente visibles, fondo de estudio moderno y minimalista, iluminación lateral suave que resalta los materiales, fotografía realista de producto comercial, primer plano en ángulo bajo, composición limpia, 16:9, sin texto, sin logotipo, sin marca de agua. |
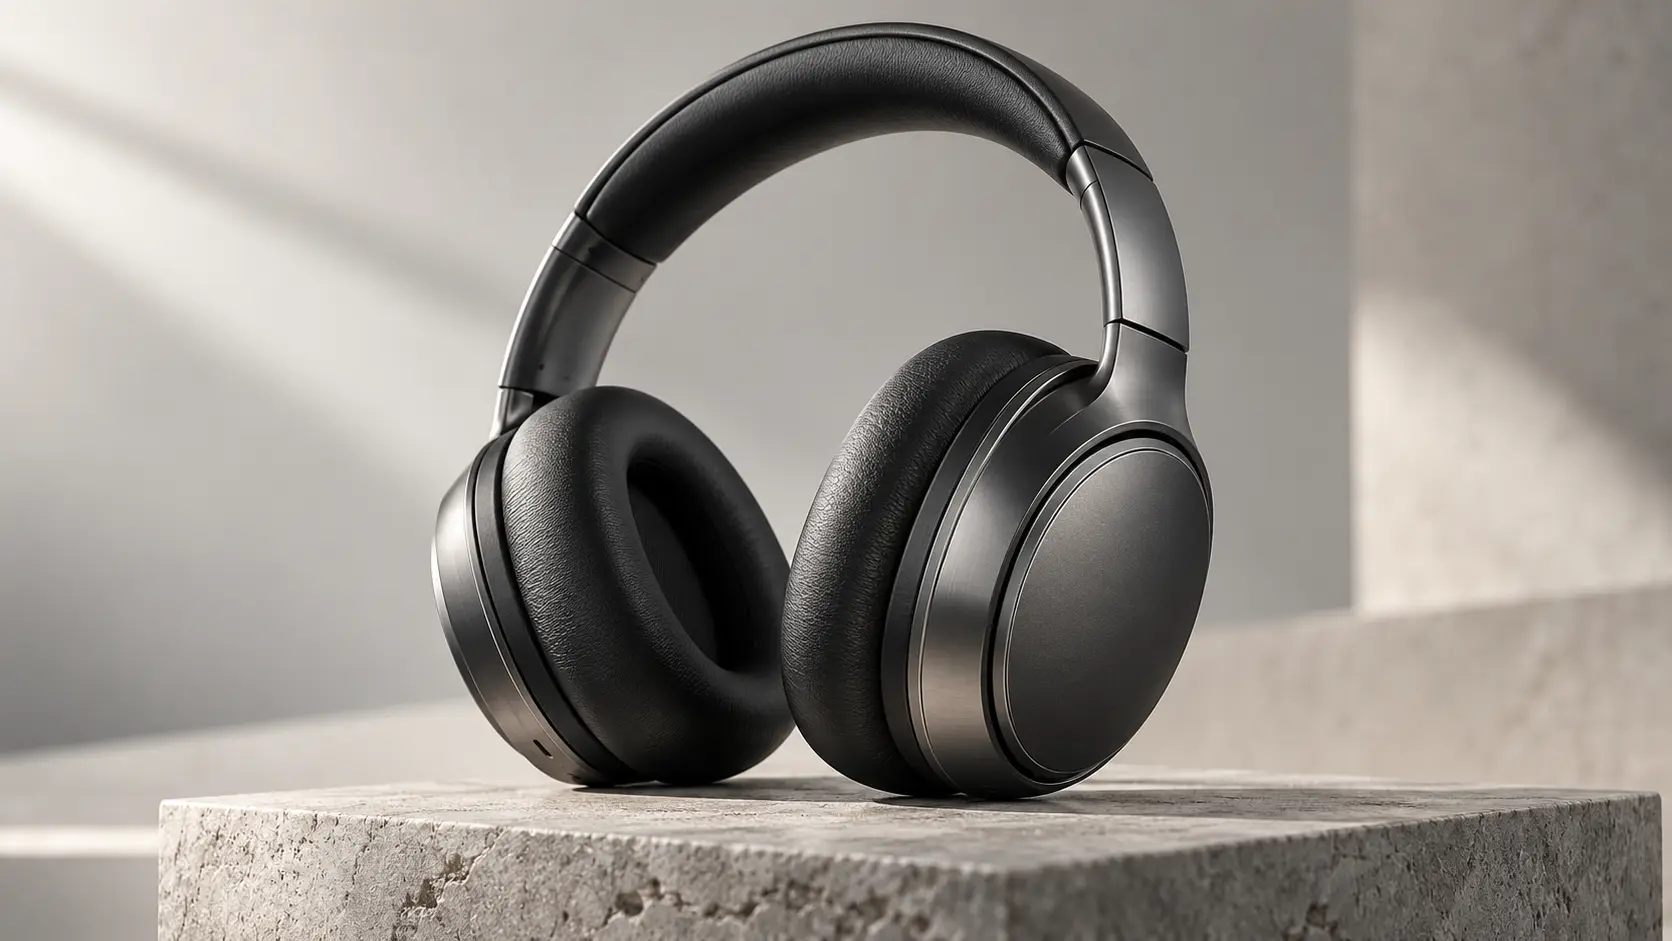 |
Paso 2: Sube la imagen y selecciona Wan
Abre Movmix Image to Video, sube la imagen del producto y selecciona el modelo de vídeo Wan disponible.
Paso 3: Diseña solo el movimiento que realmente necesitas
Prompt de vídeo:
Mantén los auriculares completamente inmóviles. La cámara se acerca lentamente desde un ángulo frontal de tres cuartos, mientras un suave haz de luz pasa gradualmente por las almohadillas y el marco metálico, revelando las texturas del cuero y el metal. Mantén el fondo estable. Termina con un primer plano de los detalles de la almohadilla. Mantén la forma, el color, los materiales, la estructura, los controles y las proporciones de los auriculares completamente inalterados durante todo el vídeo. No rediseñes el producto.
Paso 4: Soluciona el problema, no todo el prompt
Si el producto cambia de forma, reduce su movimiento y traslada la acción a la cámara o a la iluminación.
Si la cámara va demasiado rápida, cambia únicamente la velocidad de la cámara.
Si el fondo sigue cambiando, indica explícitamente al modelo que lo mantenga completamente estable.
Esto es más útil que reescribir todo el prompt después de cada generación fallida.
Cuando el texto del embalaje o un logotipo deben permanecer legibles
Algunos vídeos de productos fallan por una razón diferente: la forma se mantiene, pero la etiqueta se convierte en un sinsentido. Si tu toma depende de que el nombre de la marca, el texto del embalaje o un eslogan corto sean legibles, merece la pena probar MiniMax H3 junto a Wan 3.0, ya que el texto y las imágenes conscientes de la marca son algunas de las funciones para las que está diseñado.
Mantén la instrucción específica. Nombra el texto exacto que debe permanecer legible, mantén el movimiento de cámara lento y evita pedir que el producto gire completamente, porque la parte trasera del embalaje es donde suele aparecer texto inventado.
Ejemplo de prompt:
El bote de cuidado de la piel permanece vertical e inmóvil sobre el pedestal de piedra. La cámara realiza un lento acercamiento desde una vista frontal, mientras una luz suave se desplaza sobre el cristal. Mantén el texto de la etiqueta "AURA SERUM" nítido, correctamente escrito y legible durante todo el vídeo. No gires el bote. No añadas ningún texto nuevo. Ambiente de estudio silencioso.
Escenario 3: Quieres moda, Reels o vídeos sociales centrados en personajes
Los vídeos de personajes tienen un modo de fallo completamente diferente.
Con un producto, te preocupas por la forma.
Con una persona, te preocupas por esto:
La persona del primer segundo ya no parece la misma al final.
Prueba Kling o Wan
Para moda, estilo de vida, personajes virtuales y clips para redes sociales, céntrate en tres aspectos:
Consistencia de identidad + acción sencilla + movimiento de cámara claro
Por ejemplo:
Si la acción es sencilla, tanto Wan como Kling son opciones razonables para probar.
Si la toma implica una interpretación corporal más compleja, seguimiento de cámara o varios activos de referencia, Kling se vuelve más relevante para probar.
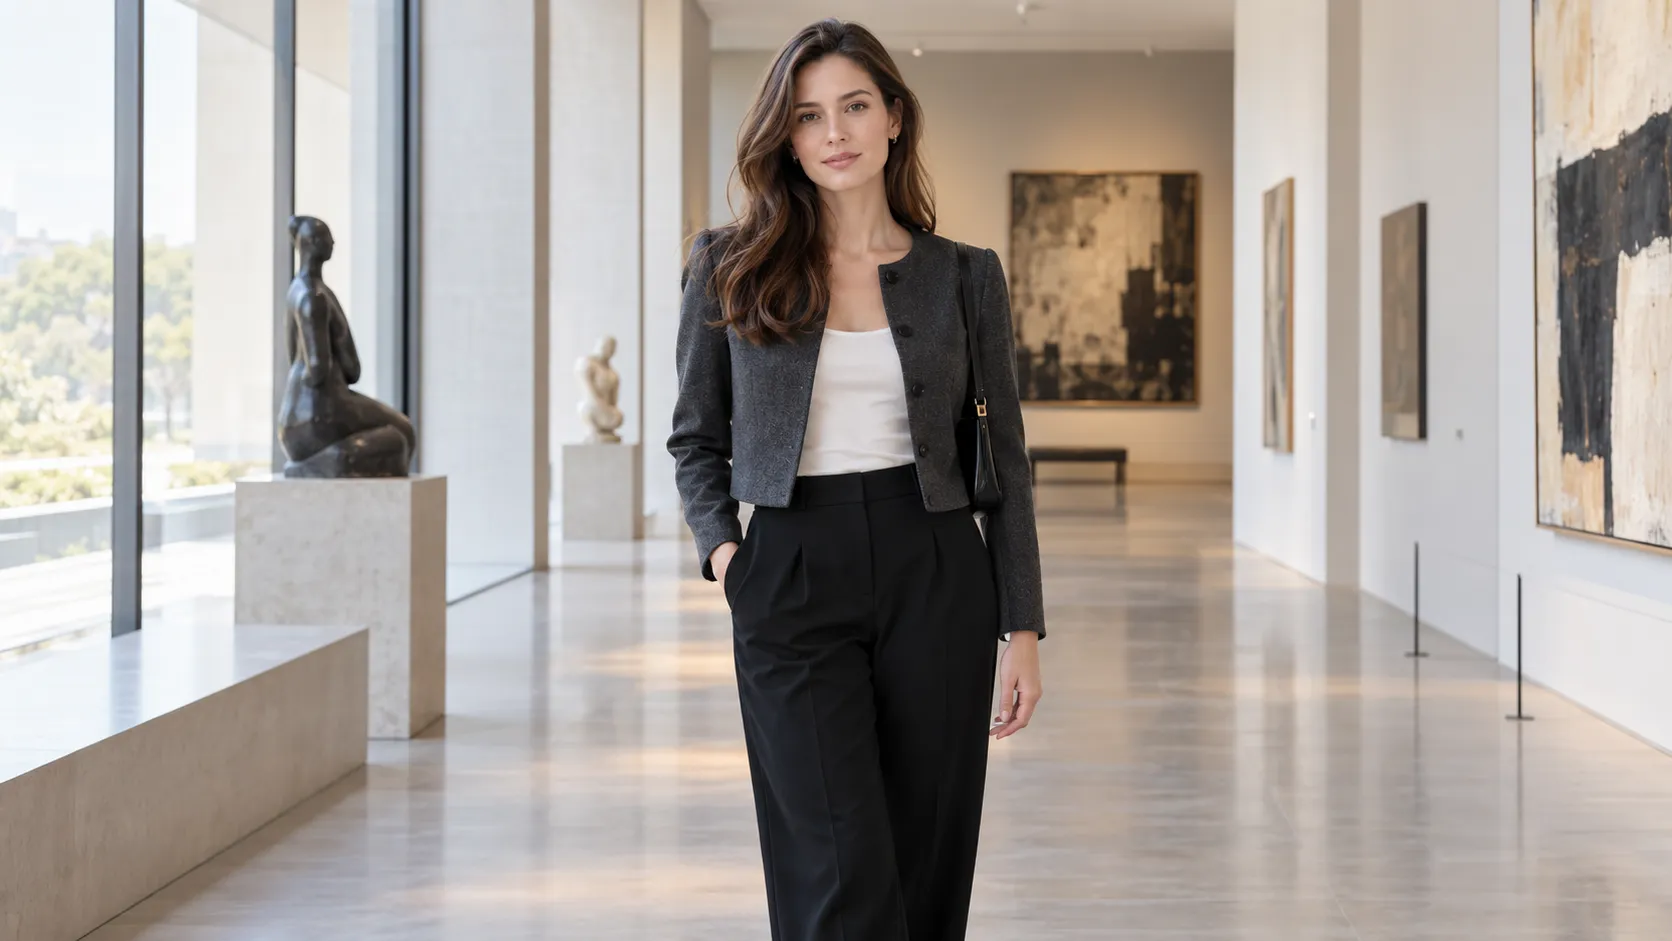
| Prompt de imagen | |
|---|---|
| Imagen horizontal 16:9 de una mujer europea de pie en el pasillo de una galería de arte moderna, vestida con una elegante chaqueta corta gris oscuro, una parte de arriba blanca y pantalones negros, preparándose naturalmente para caminar hacia adelante, con detalles faciales nítidos, líneas arquitectónicas modernas al fondo, iluminación natural suave, fotografía de moda premium realista, composición de cuerpo entero a medio cuerpo, sin texto, sin logotipo, sin marca de agua. |
 |
Grabación para Reels y TikTok: Usa un primer fotograma vertical
Si el clip va destinado a Instagram Reels o TikTok, genera el primer fotograma en formato 9:16 en lugar de recortar posteriormente un resultado 16:9. El recorte elimina los hombros y los pies que el modelo necesita para mantener la consistencia corporal y, a menudo, empuja el rostro hacia el borde del encuadre.
Mantén todo el atuendo dentro del encuadre, deja un poco de espacio sobre la cabeza y describe una acción que el espectador pueda identificar fácilmente en una pantalla pequeña: un giro, un paso, una mirada a la lente. Para formatos sociales listos para usar, las plantillas Reel Ready cubren clips entre bastidores, vlogs diarios y transiciones de alfombra roja sin necesidad de escribir un prompt.
Escenario 4: Tienes una imagen de un personaje y quieres copiar el movimiento de otro vídeo
Esto ya no es una simple conversión de imagen a vídeo.
Ahora tienes dos referencias diferentes realizando dos tareas distintas.
La imagen responde:
¿Quién debe actuar?
El vídeo responde:
¿Cómo debe moverse?
Por ejemplo, puedes tener el retrato de una persona y un vídeo separado de deportes, baile o actuación. Quieres que la persona de la imagen realice los movimientos del vídeo.
Prueba los flujos de trabajo con referencias de Kling, Seedance o Wan
La regla más importante en este escenario es:
Imagen de referencia = QuiénVídeo de referencia = Cómo
No te limites a decirle al modelo:
“Hazlo como la referencia.”
Indícale exactamente qué controla cada referencia.
Flujo de trabajo completo 2: Transferir el movimiento de baloncesto a otro personaje
Supongamos que tienes:
Imagen A: un personaje masculino adulto
Vídeo B: un atleta realizando un regate rápido y un giro
El objetivo no es regenerar al atleta del Vídeo B.
El objetivo es hacer que el personaje de la Imagen A realice el movimiento del Vídeo B.
Prompt de vídeo
Utiliza la Imagen A como referencia de identidad y apariencia del personaje. Mantén consistentes los rasgos faciales, el peinado, la ropa, las proporciones corporales y la identidad del personaje. Usa el Vídeo B como referencia de movimiento, ritmo y desplazamiento corporal. Haz que el personaje de la Imagen A siga el mismo ritmo de regate, el movimiento de giro y los cambios de peso corporal mostrados en el Vídeo B. Preserva la física humana natural. No copies la cara ni la identidad de la persona del Vídeo B. Sigue el movimiento de cámara del Vídeo B mientras mantienes estable el entorno.
El resultado muestra la idea con más claridad que cualquier explicación: Una referencia controla la identidad. Otra controla el movimiento.
¿Referencia a vídeo, vídeo a vídeo o AI Recast?
Movmix ofrece tres herramientas que combinan un personaje con un movimiento existente. Cada una resuelve problemas diferentes, por lo que vale la pena elegir con criterio.
- Referencia a vídeo: parte de una imagen de personaje y un clip de movimiento para generar un vídeo completamente nuevo en el que tu personaje realiza esa acción. Úsalo cuando quieras crear una escena nueva.
- Vídeo a vídeo: parte de un vídeo existente y transfiere su movimiento a una nueva apariencia o estilo. Úsalo cuando el metraje original sea la base y quieras cambiar su estilo.
- AI Recast: parte de un vídeo existente y sustituye a la persona que aparece por otro personaje, manteniendo el movimiento original. Úsalo cuando el metraje sea adecuado y solo necesites cambiar al intérprete.
Si tienes dudas, pregúntate qué quieres conservar. Conserva el movimiento y crea una escena nueva: Referencia a vídeo. Conserva el metraje y cambia el estilo: Vídeo a vídeo. Conserva el metraje y cambia a la persona: AI Recast.
Escenario 5: Quieres una pequeña historia, no solo una acción
Una vez que tu solicitud empieza a sonar así:
El personaje hace A, luego ocurre B, después se da cuenta de C y, finalmente, reacciona.
Ya no estás creando un simple clip de movimiento.
Estás creando una historia.
Prueba Seedance
Para este tipo de contenido, el prompt debe dejar de comportarse como una colección de adjetivos visuales.
Debe describir una secuencia:
Lo que ocurre primero → qué cambia → cómo sigue la cámara → dónde termina la escena
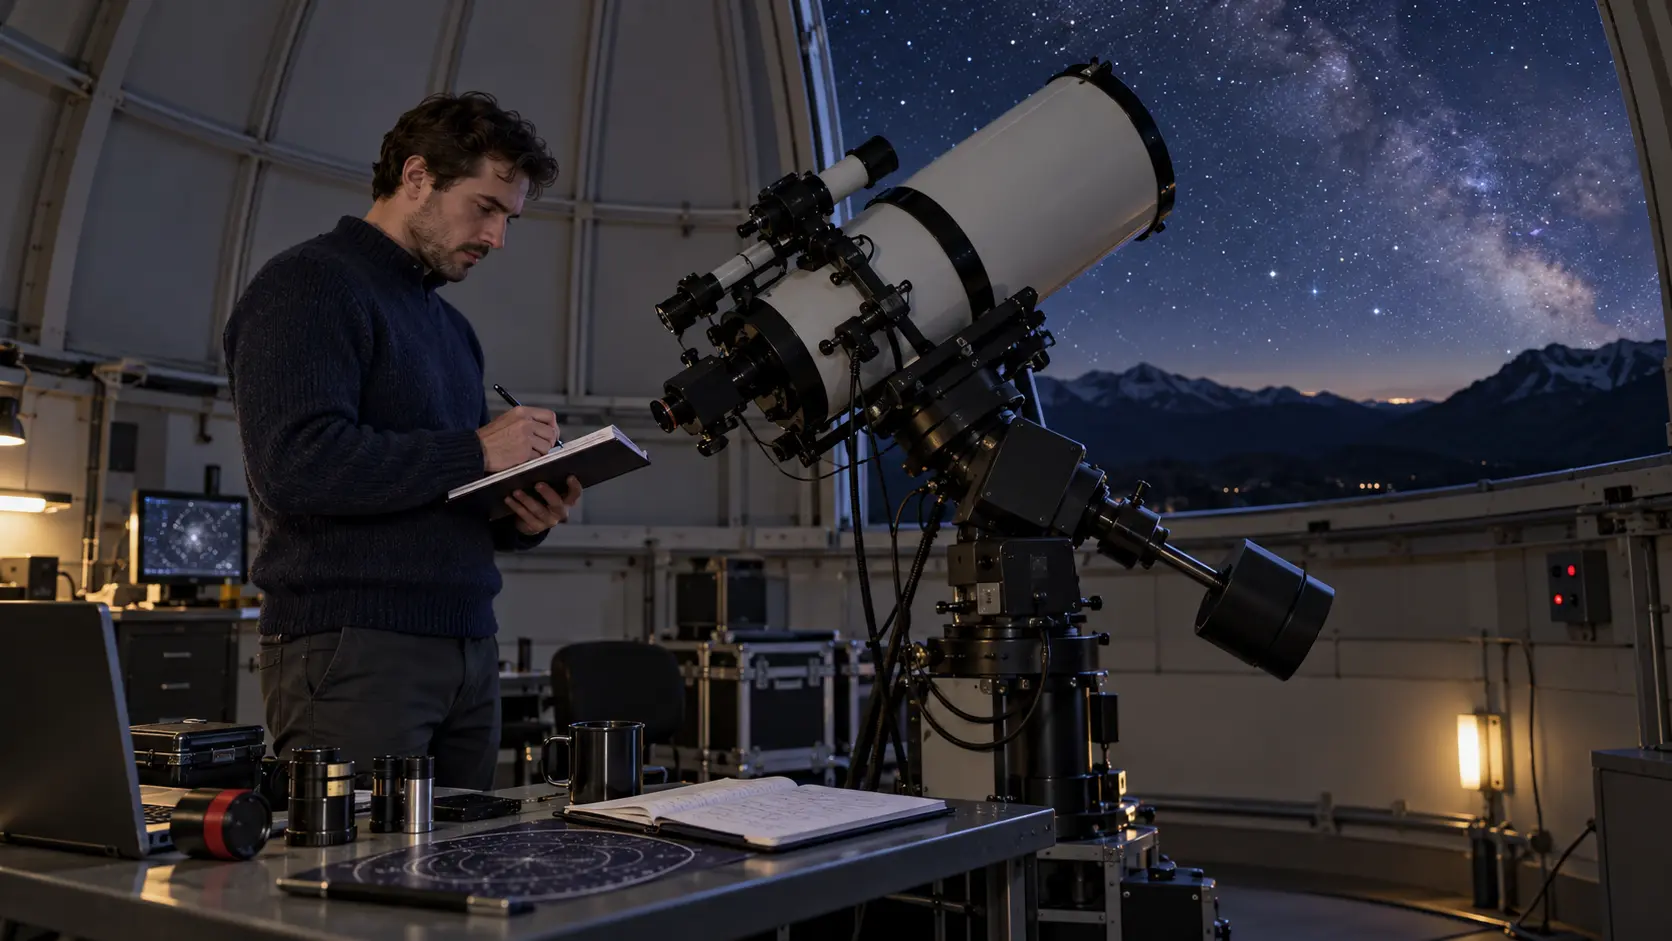
Flujo de trabajo completo 3: Un descubrimiento inesperado en un observatorio
Paso 1: Crear el primer fotograma
| Prompt de imagen | Resultado |
|---|---|
| Un investigador de astronomía masculino adulto de 35 años de pie dentro de un tranquilo observatorio en la cima de una montaña, vistiendo un suéter de punto azul oscuro y pantalones oscuros, registrando datos de observación junto a un gran telescopio, con un cuaderno y equipo científico sencillo sobre el escritorio, cielo nocturno despejado visible a través de la abertura de la cúpula del observatorio, fotografía documental realista, plano medio, iluminación interior natural y calmada, 16:9. |
 |
Paso 2: Elegir Seedance
Esta vez, necesitamos más que un solo movimiento.
Necesitamos un evento.
Prompt de video
El investigador mira hacia abajo y anota datos en el cuaderno. Se escucha un breve sonido de alerta procedente del equipo cercano. Deja de escribir, levanta la cabeza, mira hacia el dispositivo de monitoreo y luego se dirige rápidamente al telescopio para observar el cielo. La cámara lo sigue desde un lateral y luego cambia a su punto de vista, mostrando cómo un cometa brillante se desplaza lentamente por el cielo nocturno distante. Termina con una toma que muestra tanto al investigador como al cometa a través de la ventana del observatorio. Mantén la identidad del investigador, la estructura del observatorio y el entorno nocturno consistentes. Añade una sutil alerta del equipo, sonidos suaves de escritura y una ambientación interior tranquila.
La lección importante aquí no es el prompt en sí.
Se trata de saber cuándo tu proyecto ha pasado de ser simple "movimiento" a "narrativa".
Cuando la historia necesita más de un clip
Una sola generación tiene un límite, incluso si dura 30 segundos. Cuando tu guion tiene más momentos de los que caben en un solo clip, planifica la historia como una secuencia en lugar de forzarla en un único prompt.
Escribe primero el guion, define al personaje principal con una imagen de referencia y genera escena por escena. Si un clip termina en el momento adecuado pero demasiado pronto, continúa con Video Extend en lugar de empezar de nuevo. Para una versión guiada de este flujo de trabajo, el AI Story Generator convierte una idea en trama, elementos visuales y voz en off.
En el momento en que el diálogo entra en escena, tus criterios de selección cambian nuevamente.
Ahora el modelo necesita gestionar algo más que imágenes atractivas.
También necesita gestionar:
La identidad del personaje, el orden de los interlocutores, la voz, el ritmo y el movimiento de la boca
Prueba Kling o Seedance
No te limites a escribir:
Dos diseñadores discuten sobre un proyecto.
Esto deja casi todo sin definir.
Una estructura mejor sería:
El personaje A habla primero → El personaje B reacciona → El personaje B responde → Cambio de cámara → El entorno permanece estable
Cuando el diálogo es relevante, el audio se convierte en parte de la lógica de la escena y no en un extra opcional.
Ejemplo de prompt de diálogo
Dos diseñadores están sentados frente a frente en una pequeña mesa dentro de un estudio luminoso, con un póster impreso entre ellos. La mujer de la izquierda da unos golpecitos sobre el póster y dice: «El titular es demasiado pequeño». El hombre de la derecha se recuesta, lo observa durante un segundo y responde: «Entonces hagamos que todo el póster gire en torno a eso». Ella se ríe. La cámara comienza con un plano conjunto, corta a un primer plano del hombre mientras responde y luego vuelve al plano conjunto. Mantén intactos los rostros, la vestimenta y el estudio. Sonido ambiental natural, leves sonidos de papel, sin música.
Fíjate en qué elementos fija el prompt: quién habla primero, las palabras exactas, quién reacciona y dónde está situada la cámara en cada intervención. Tanto Kling 3.0 como Kling 4.0 generan voz junto con la imagen, y MiniMax H3 y Seedance 2.5 también producen audio nativo, por lo que vale la pena probar este prompt en dos de ellos y comparar la sincronización labial antes de comprometerte con uno.
Escenario 7: Acción compleja, deportes, actuaciones o varias personas
Estas escenas son aquellas en las que los modelos de vídeo con IA suelen ponerse a prueba de forma más exigente.
Algunos ejemplos incluyen deportes en pareja, actuaciones coordinadas, varios personajes moviéndose al mismo tiempo, interacciones físicas o una cámara que necesita desplazarse alrededor de varios sujetos.
Prueba Seedance o Kling
La lección principal aquí es sorprendentemente simple:
No resuelvas la complejidad escribiendo una frase más larga.
Desglosa la relación.
En lugar de:
Dos personas realizan una acción intensa mientras la cámara se mueve de forma cinematográfica.
Define:
El personaje A empieza aquí. El personaje B empieza allí. El personaje A se mueve primero. El personaje B responde. Interactúan en este punto. La cámara está situada aquí.
Cuanto más complicado sea el movimiento, más importante resulta explicar quién hace qué.
Esto es mucho más útil que añadir palabras extra como «dinámico», «épico» o «lleno de energía».
Ejemplo: Dos bailarines, una órbita de cámara
Dos bailarines se encuentran de pie, uno frente al otro, en una azotea vacía al atardecer. El bailarín con chaqueta roja comienza primero con tres movimientos bruscos de brazos, mientras que el bailarín de blanco permanece inmóvil. En el cuarto compás, el bailarín de blanco responde con los mismos tres movimientos, pero en espejo. Ambos avanzan luego el uno hacia el otro y se congelan espalda con espalda. La cámara orbita lentamente alrededor de ellos a la altura de la cintura durante toda la secuencia y termina con una vista frontal de la pose final. Mantén consistentes los rostros, atuendos y proporciones corporales de ambos bailarines. Viento ligero y ambiente urbano.
Escenario 8: Ya tienes imágenes, vídeos, audio y guiones gráficos
A veces, el problema no es la falta de material.
Es tener demasiado material.
Es posible que ya tengas:
- Imágenes de personajes
- Referencias de entorno
- Vídeos de movimiento
- Música
- Efectos de sonido
- Imágenes del guion gráfico
En este punto, el desafío se convierte en la gestión de referencias.
Prueba Seedance
La clave no es subir la mayor cantidad de material posible.
La clave es asignar una función específica a cada referencia.
Por ejemplo:
La imagen A controla el personaje. La imagen B controla el entorno. El video C controla el movimiento de cámara. El audio D controla el estilo de sonido.
Si no has decidido qué responsabilidad tiene cada referencia, el modelo tendrá que adivinar.
Y una vez que el modelo comienza a adivinar, añadir más referencias puede hacer que el flujo de trabajo sea menos claro en lugar de estar más controlado.
Seedance 2.5 es el primer modelo a probar aquí porque está diseñado para trabajar con grandes conjuntos de referencias, y Kling 4.0 es la siguiente opción cuando también necesitas fotogramas clave en la línea de tiempo. En cualquier caso, sube los archivos en Reference to Video, etiqueta cada archivo en el prompt según su función y omite cualquier archivo que no tenga una asignada.
El primer clip se acerca, pero no es correcto: ¿extender, editar o regenerar?
Elegir el modelo adecuado te acerca al resultado, pero el primer intento rara vez es el definitivo. Antes de cambiar de modelo, determina qué tipo de problema estás enfrentando.
- El clip es bueno pero termina demasiado pronto: extiéndelo. Video Extend continúa el clip existente para que conserves todo lo que ya funciona.
- El clip es bueno excepto por un elemento, como el vestuario o el fondo: edítalo. El AI Video Editor rehace un vídeo existente a partir de una instrucción de texto.
- El movimiento, la identidad o el producto son incorrectos desde el inicio: regenera y cambia un solo elemento del prompt cada vez.
- Si el mismo problema persiste después de dos o tres reintentos enfocados: prueba ahora el siguiente modelo en la tabla de respuestas rápidas.
Cambiar de modelo debería ser el último paso, no la primera reacción.
¿Qué modelo de vídeo con IA deberías utilizar?
No empieces con:
«¿Son Wan, Seedance o Kling los más potentes?»
En su lugar, formula tres preguntas más útiles.
¿Qué material ya tengo?
¿Solo texto? ¿Una imagen? ¿O imágenes, vídeos de referencia y audio?
¿Cuál es la parte más difícil de este vídeo?
¿Consistencia del producto? ¿Identidad del personaje? ¿Movimiento? ¿Narrativa? ¿Diálogos? ¿Interacción entre varios personajes?
¿Qué no puede fallar bajo ningún concepto?
¿El rostro? ¿La estructura del producto? ¿El movimiento? ¿La continuidad de la escena?
Estas preguntas suelen aportarte mucha más información que una comparativa genérica de modelos de vídeo con IA.
Si solo necesitas convertir la imagen de un producto en un plano publicitario limpio, probablemente no haga falta que empieces con una historia compleja de múltiples tomas.
Si quieres que un personaje realice el movimiento de otro vídeo, un flujo de trabajo estándar de imagen a vídeo ya no es suficiente.
Y cuando tu guion empieza a llenarse de palabras como:
«entonces», «después», «de repente» y «finalmente»...
probablemente ya no estés creando un clip sencillo.
Estás construyendo una historia.
Tu elección del modelo debe adaptarse a la tarea. Si quieres ver estos modelos lado a lado con el mismo prompt, empieza desde el Generador de Vídeos con IA y cambia de modelo sin salir de la página.
Regla final: Elige primero el video, luego elige el modelo
El valor de tener múltiples modelos en Movmix no es simplemente que haya más botones para hacer clic.
El verdadero valor es que diferentes tareas pueden usar diferentes flujos de trabajo.
Utiliza modelos de imagen como GPT Image 2.5, Nano Banana, Grok Image o Seedream para preparar el punto de partida visual que realmente deseas.
Luego, elige Wan, Seedance, Kling u otro modelo de video disponible según lo que la escena necesite hacer a continuación.
La imagen decide:
¿Cómo se ve?
El modelo de video decide:
¿Qué sucede después?
Y tu prompt decide:
¿Cómo debería suceder?
Así que la próxima vez que no estés seguro de qué modelo de video con IA elegir, olvídate por un momento de los nombres de los modelos.
Describe primero el video que realmente quieres crear.
Desde ahí, suele ser mucho más fácil elegir el modelo adecuado.
Preguntas frecuentes: Cómo elegir un modelo de vídeo con IA
P: ¿Cuál es el mejor modelo de vídeo con IA en general?
R: No existe un único modelo mejor que los demás. Wan 3.0 es una excelente primera opción para tomas de producto estables y animaciones simples de imágenes; Seedance 2.5, para historias cortas y grandes conjuntos de referencias; Kling, para actuaciones de personajes, movimiento y diálogos; y MiniMax H3, para clips breves de marca donde el texto debe permanecer legible. Elige según la parte más difícil de tu vídeo.
P: ¿Qué modelo de vídeo con IA debo usar para anuncios de productos?
R: Comienza con Wan 3.0 y mantén el producto estático mientras la cámara y la iluminación se mueven. Si la etiqueta, el logotipo o el texto del embalaje deben permanecer legibles, prueba también MiniMax H3. Sube la foto de tu producto en la función «Imagen a vídeo» y fija la forma, el color y los materiales del producto en el prompt.
P: ¿Qué modelo es mejor para replicar el movimiento de otro vídeo?
R: Utiliza un flujo de trabajo con referencia en lugar de la opción básica de «Imagen a vídeo». Kling es el primer modelo que deberías probar, con Seedance 2.5 y Wan 3.0 como alternativas. Sube la imagen del personaje y el clip de movimiento en la función «Referencia a vídeo», e indica qué archivo controla la identidad y cuál controla el movimiento.
P: ¿Puedo usar más de un modelo de vídeo con IA en el mismo proyecto?
R: Sí. De hecho, muchos proyectos funcionan mejor así: crea el primer fotograma con un modelo de imagen como GPT Image 2.5 o Nano Banana, anima las tomas del producto con un modelo de vídeo y genera la escena de diálogo con otro. En Movmix, todos estos modelos están disponibles desde la misma cuenta.
P: ¿Cuánto puede durar un vídeo generado con IA en Movmix?
R: Depende del modelo. Wan 3.0, Seedance 2.5 y Kling 4.0 generan hasta 30 segundos de una sola vez, mientras que Kling 3.0 y MiniMax H3 llegan hasta 15 segundos. Para vídeos más largos, continúa un clip con la función «Extensión de vídeo» o planifica la historia escena por escena.
P: ¿Debería cambiar de modelo cuando falla una generación?
R: No inmediatamente. Primero cambia un solo elemento en el prompt, como la velocidad de la cámara o una instrucción de consistencia. Si el mismo problema se repite después de dos o tres intentos específicos, prueba el siguiente modelo para ese escenario.