구글은 최근 인상적인 AI 모델을 다수 출시했지만, 최신 Gemini 업데이트에서 가장 흥미로운 부분은 단일 모델이 아닐 수 있습니다.
그것은 워크플로우입니다.
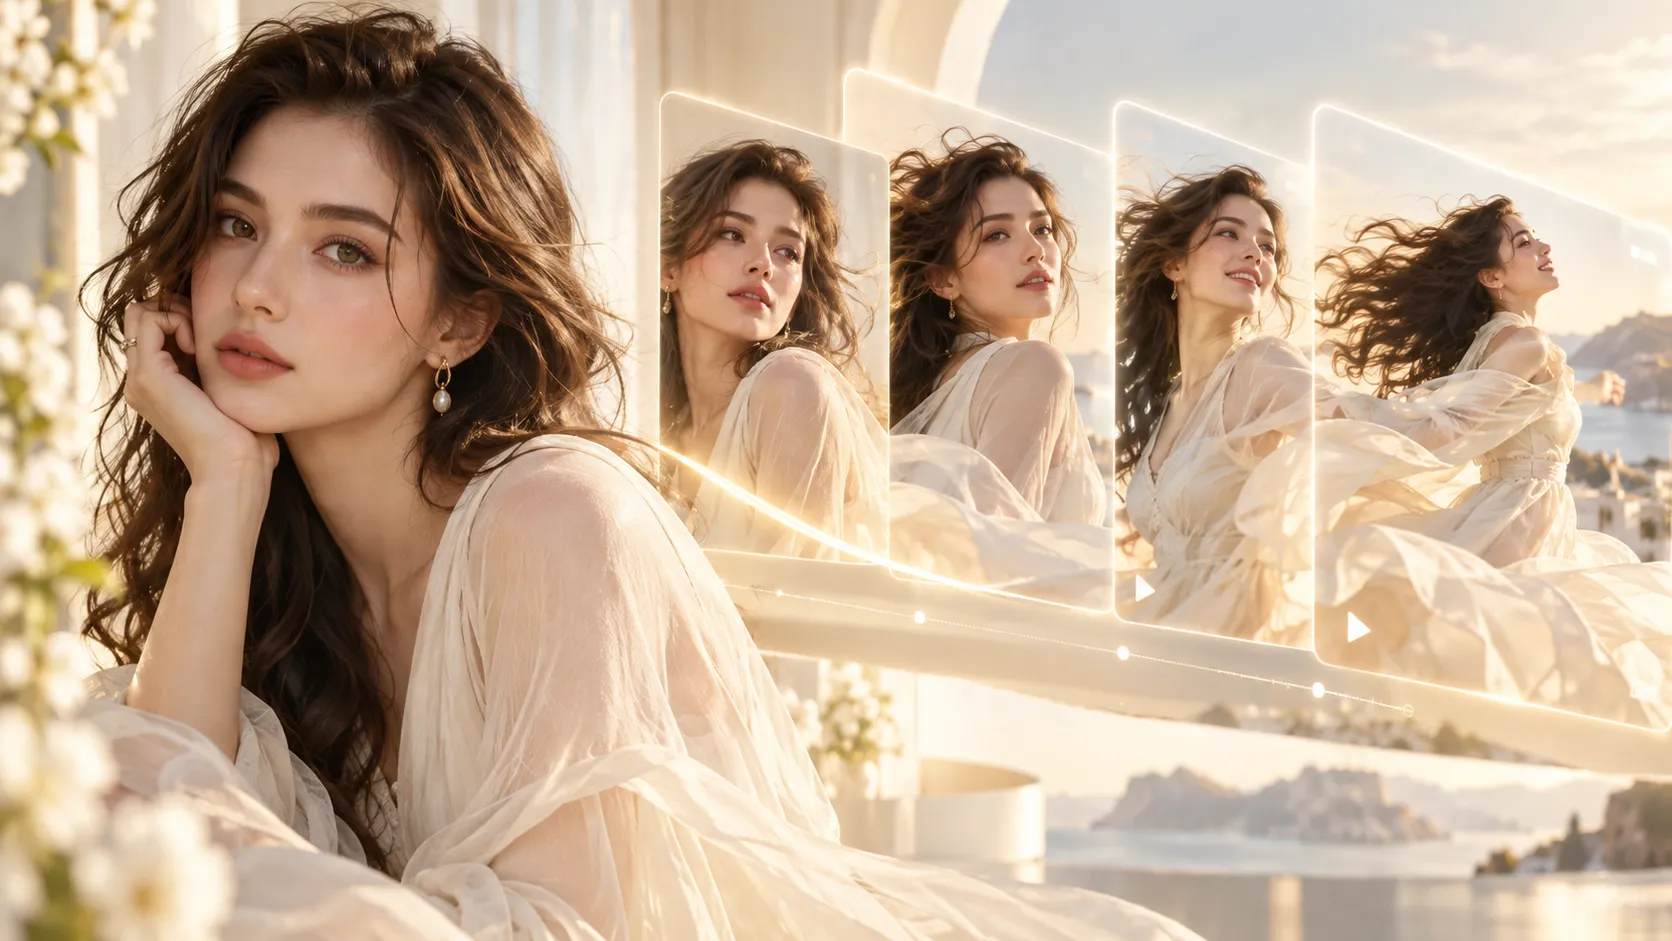
구글은 이제 크리에이터들에게 Nano Banana 2 Lite와 Gemini Omni Flash를 결합하는 방법을 명시적으로 보여줍니다. 먼저 이미지를 생성하거나 다듬은 후, 해당 이미지를 Omni에 입력하여 비디오로 변환합니다.
즉,
첫 프레임을 완벽하게 만든 다음, 움직임을 추가하세요.
이는 당연해 들릴 수 있지만, AI 비디오의 가장 큰 문제 중 하나인 하나의 모델에게 캐릭터, 구성, 환경, 모션, 카메라 및 최종 샷을 동시에 모두 창작하도록 요구하는 문제를 해결합니다.
구글은 Nano Banana 2 Lite를 가장 빠르고 비용 효율적인 Nano Banana 이미지 모델이라고 설명하며, Gemini Omni Flash는 텍스트, 이미지 및 비디오 입력의 조합을 사용한 비디오 생성 및 대화형 편집을 위해 설계되었습니다. 구글은 특히 엔드투엔드 미디어 워크플로우를 위해 두 모델을 연결하여 사용할 것을 권장합니다.
또한 두 워크플로우 모두 Movmix에서 이용 가능하므로, 파일을 계속 다운로드하거나 관련 없는 도구 사이를 오가지 않고도 동일한 아이디어를 따를 수 있습니다.
먼저, 구글이 실제로 출시한 것은 무엇인가요?
이번 업데이트에는 두 가지 핵심 요소가 있습니다.
Nano Banana 2 Lite는 빠른 이미지 생성 및 편집을 위해 구축되었습니다. 구글은 이 모델이 약 4초 만에 1K 텍스트-이미지 결과를 생성할 수 있으며, 대량 처리 및 저지연 워크플로우에 최적화되어 있다고 밝혔습니다.
처음부터 시작한다면, Nano Banana 2 Lite Text to Image를 사용하여 첫 프레임을 만들 수 있습니다.
이미 사진이나 제품 이미지가 있나요? Nano Banana 2 Lite Image to Image를 사용하여 모든 것을 다시 만들 필요 없이 장면, 스타일링 또는 구도를 변경하세요.
그 다음에는 Gemini Omni Flash가 등장합니다.
구글은 Omni Flash를 멀티모달 비디오 생성 및 편집 모델로 위치시킵니다. 이는 대화형 편집, 멀티모달 참조, 실세계 지식, 그리고 텍스트, 그래픽 및 액션 간의 동기화를 지원합니다.
하지만 일상적인 크리에이터들에게 가장 유용한 부분은 더 간단합니다.
이미 좋아하는 이미지를 제공하고, 비디오 프롬프트에서는 다음에 어떤 일이 일어나야 하는지에 집중하면 됩니다.
진정한 변화: 비디오 모델에 모든 것을 맡기지 마세요
많은 실패한 AI 영상은 잘못된 첫 프레임에서 시작됩니다.
얼굴이 약간 어색할 수 있습니다.
제품의 각도가 잘못되었을 수 있습니다.
방의 분위기가 상상했던 것과 완전히 다를 수 있습니다.
그런 다음 우리는 더 긴 비디오 프롬프트를 작성하고, 비디오 모델이 애니메이션을 만들면서 Somehow 모든 문제를 해결해 주기를 기대합니다.
이는 지나친 요구입니다.
더 나은 첫 프레임 기반 비디오 워크플로우는 역할을 분리합니다.
이미지 모델은 다음 질문에 답합니다:
이 장면은 어떻게 보여야 할까?
비디오 모델은 다음 질문에 답합니다:
다음에는 어떤 일이 일어나야 할까?
이렇게 생각하면 프롬프트 작성이 훨씬 쉬워집니다.
이미 눈에 보이는 병, 모델, 방 또는 의상을 설명하는 데 비디오 프롬프트의 절반을 소비하는 대신, 그 분량을 모션, 타이밍 및 카메라 움직임에 활용할 수 있습니다.
这正是 Google이 Nano Banana 2 Lite와 Gemini Omni Flash를 연결하기로 한 결정이 또 다른 벤치마크 차트보다 중요한 이유입니다.
Movmix에서 워크플로우 재현하는 방법
간단한 제품 광고를 만들어 보겠습니다.
스킨케어 제품 이미지 한 장을 짧은 프로모션 영상으로 변환하고 싶다고 가정해 봅시다.
1단계: Nano Banana 2 Lite로 첫 프레임 생성하기
이미지로 시작하세요.
예시:
| 프롬프트 | 이미지 |
|---|---|
| 신선한 녹색 잎사귀 옆 매끄러운 돌 플랫폼 위에 놓인 프리미엄 스킨케어 병, 부드러운 아침 햇살, 은은한 물방울, 깔끔한 자연 배경, 우아한 제품 사진, 16:9 비율, 텍스트 없음, 로고 없음. | 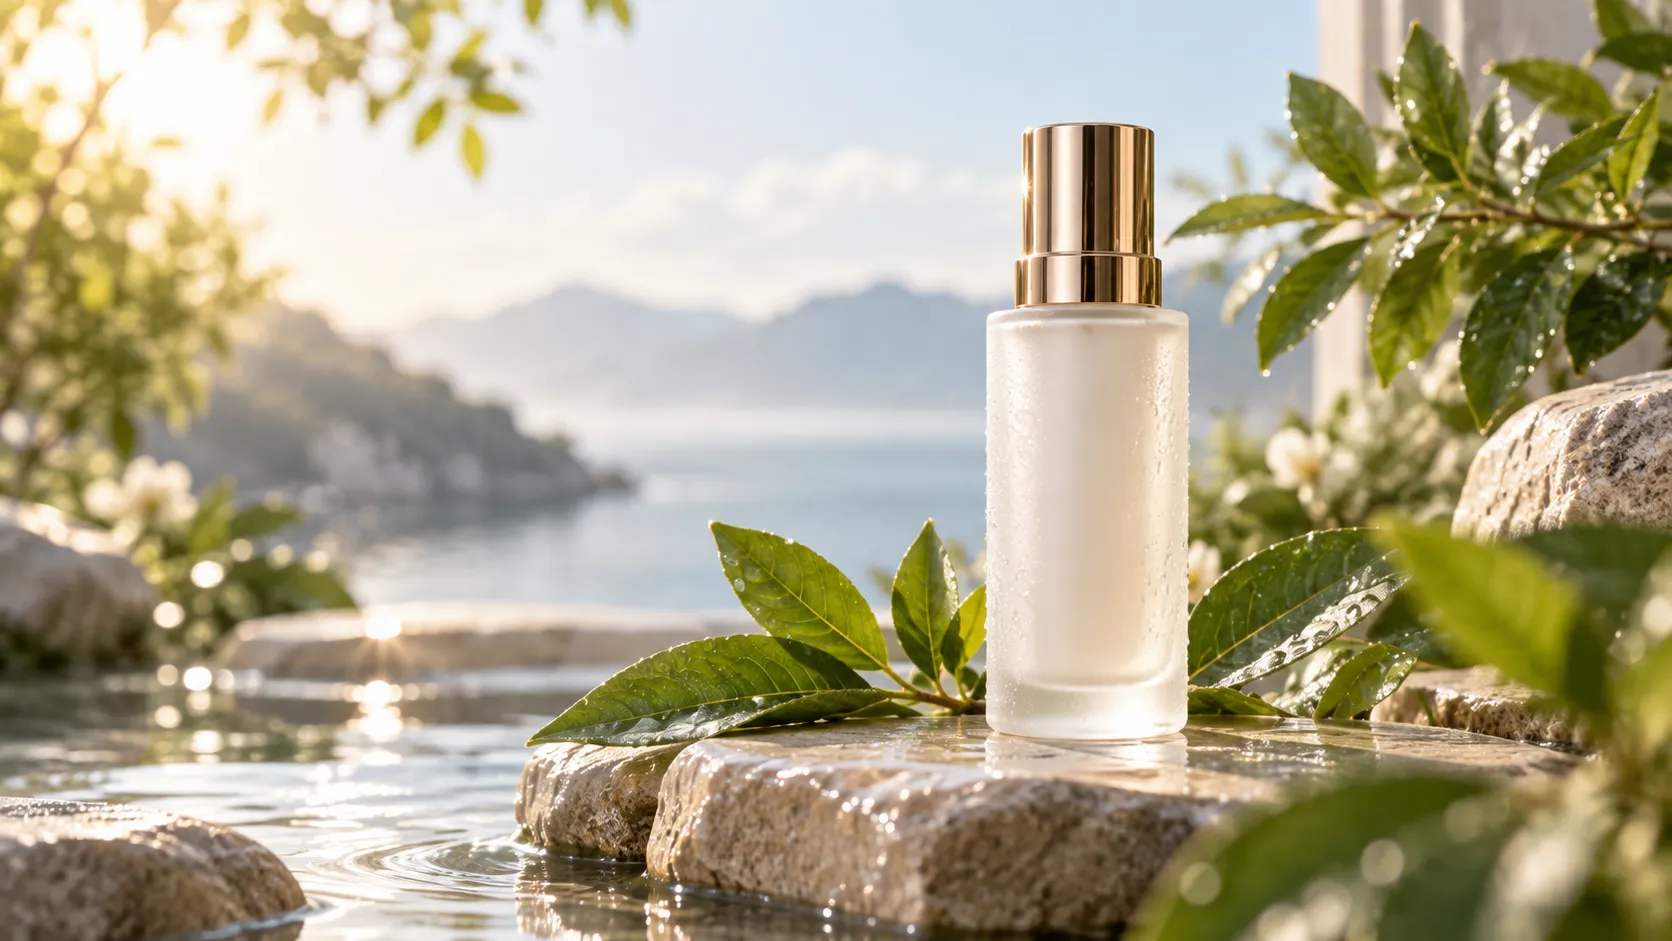 |
이 단계에서는 모션을 완전히 잊으세요.
결과물을 확인하며 자문해 보세요. 병의 형태가 올바른가요? 구도가 좋은가요? 조명이 마음에 드나요? 배경이 충분히 깔끔한가요?
아니라면 지금 이미지를 수정하세요.
이미지를 생성한 후에 문제를 발견하는 것보다 훨씬 쉽습니다.
2단계: Gemini Omni로 이미지를 영상으로 변환하기
첫 프레임이 만족스러우면, 이를 Gemini Omni 이미지 투 비디오에 업로드하세요.
이제 프롬프트는 다음 사항에만 집중하면 됩니다:
무엇이 빠져 있는지 눈치채셨나요?
우리는 병에 대한 설명을 다시 반복하지 않습니다.
이미지가 그 역할을 이미 수행했기 때문입니다.
영상 프롬프트는 주로 다음을 제어합니다:
모션 → 카메라 → 일관성 → 엔딩
이는 훨씬 더 명확한 역할 분담입니다.
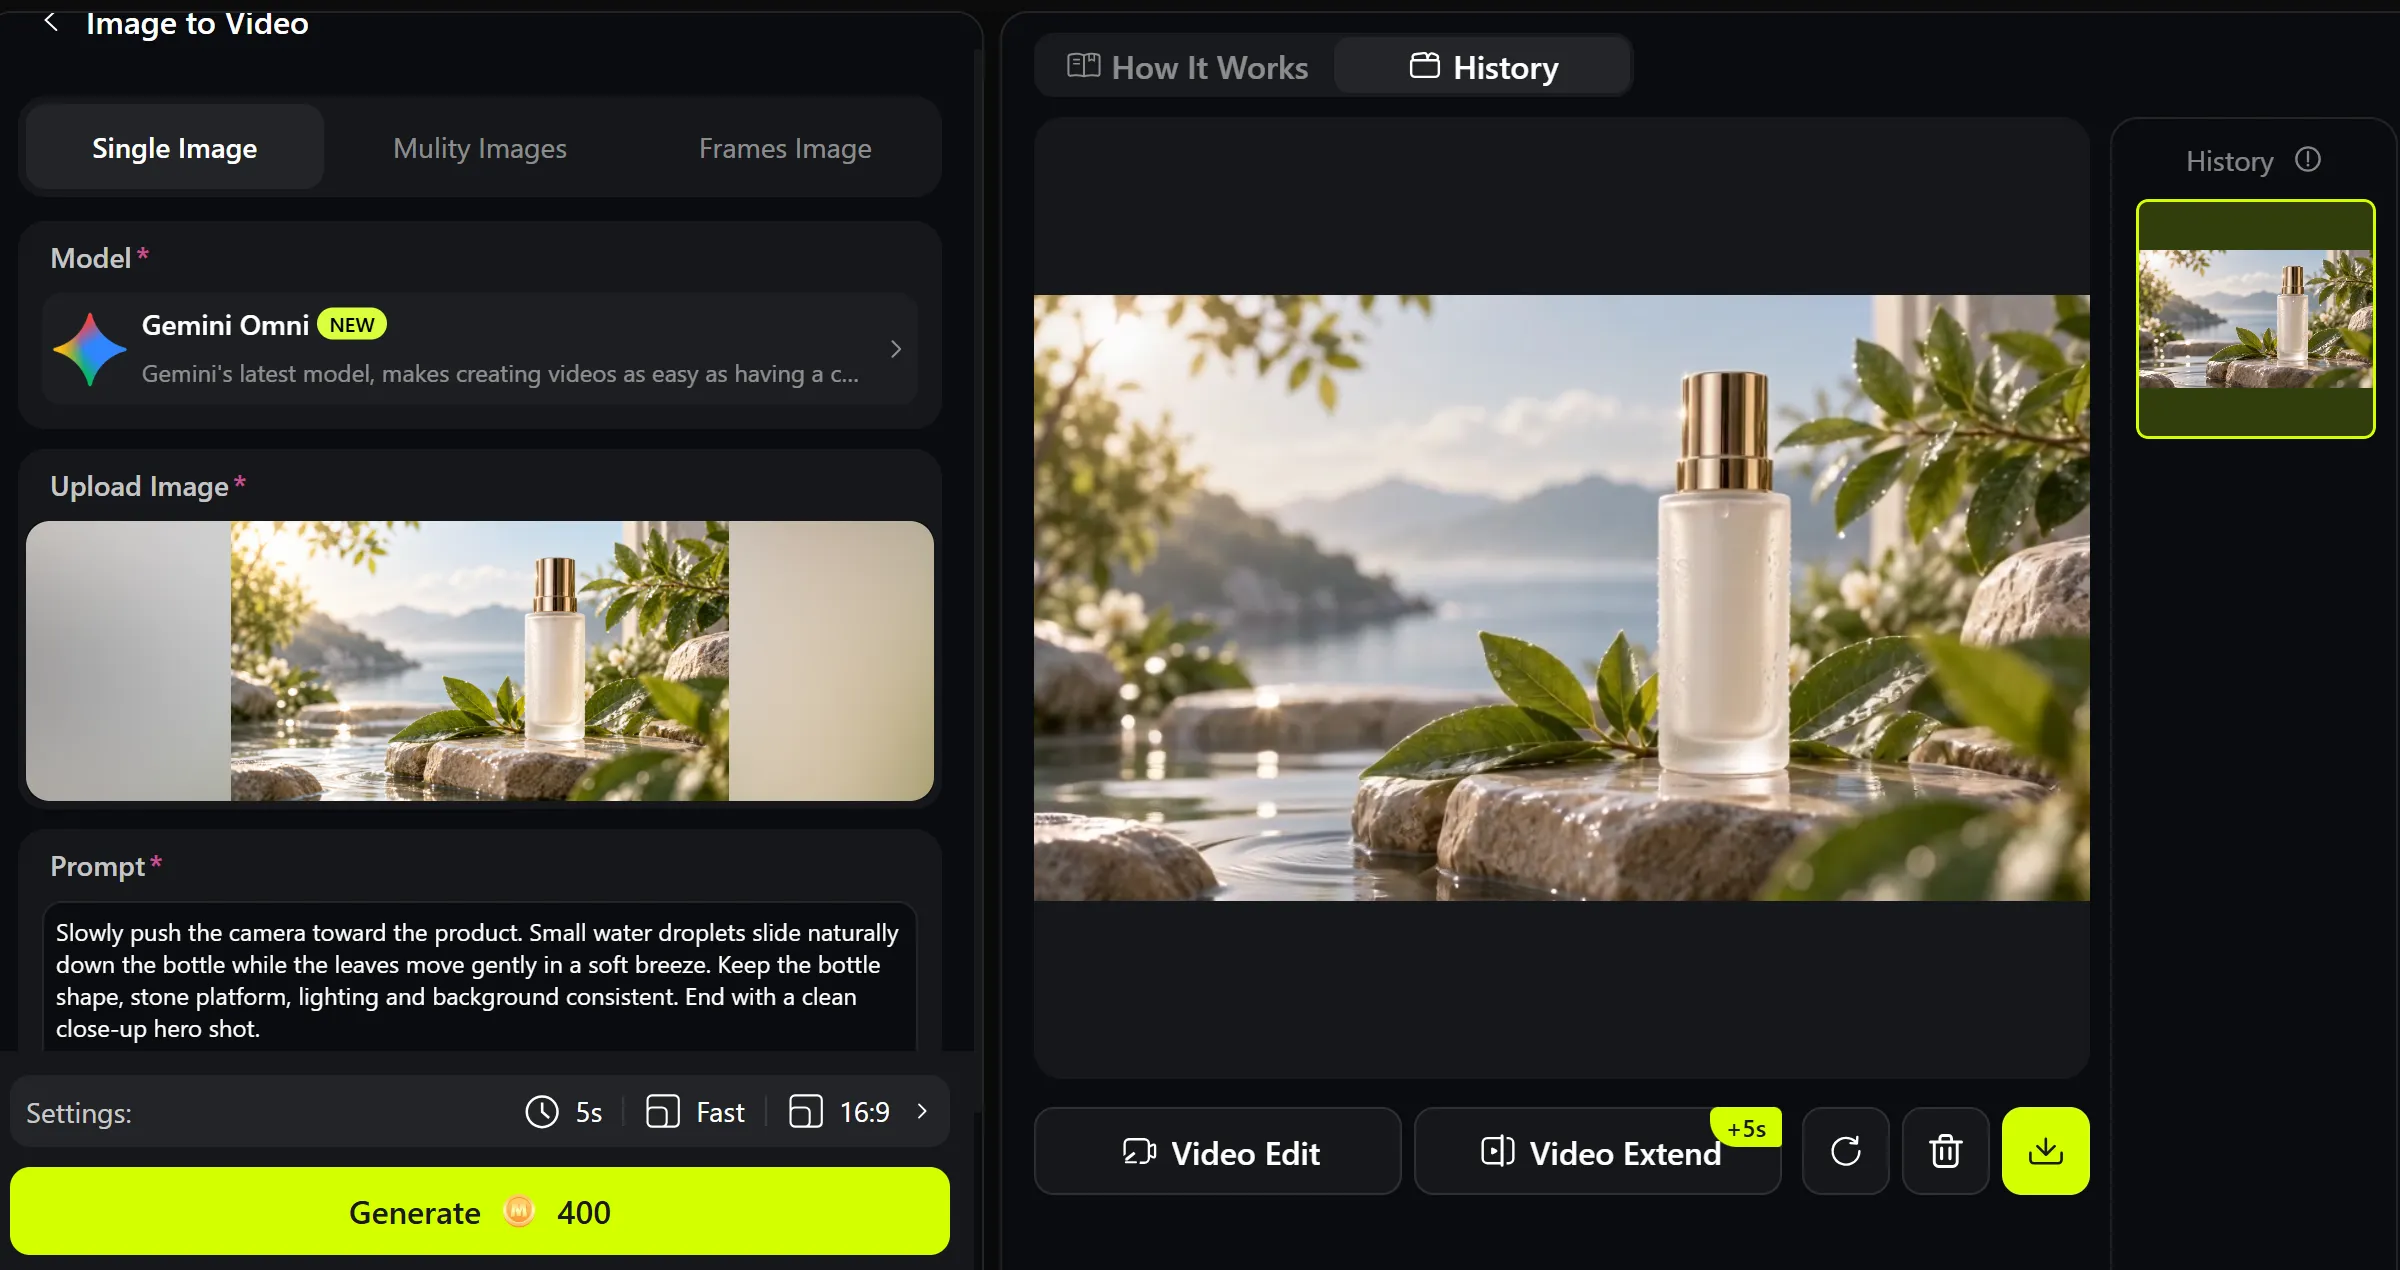
3단계: 전체 프로젝트가 아닌 모션만 다듬기
첫 영상이 괜찮지만 카메라 움직임이 마음에 들지 않는다고 가정해 봅시다.
이미지를 다시 생성하지 마세요.
다음 부분만 변경하세요:
카메라를 천천히 앞으로 밀어넣기
예를 들어 다음과 같이:
제품 주위를 시계 방향으로 천천히 회전하는 카메라
Or maybe you want the composition completely locked:
카메라를 고정하세요. 움직이는 것은 나뭇잎과 물방울뿐입니다.
간단해 보이지만, 이는 작업 방식을 근본적으로 바꿉니다.
문제가 발생할 때마다 전체 프로젝트를 다시 시작하는 대신, 실제 문제가 있는 단계만 수정하면 됩니다.
생성된 클립이 이미 근사하고 시각적 조정만 필요하다면, 모든 것을 다시 만드는 대신 Gemini Omni AI 비디오 에디터를 사용하여 작업을 이어갈 수 있습니다.
구글은 이미 이 워크플로우가 효과적인 사례를 보여주고 있습니다
구글은 Nano Banana 2 Lite와 Gemini Omni가 어떻게 협업하는지 보여주기 위해 여러 데모를 특별히 제작했습니다.
첫 번째 데모는 Anywhere입니다. 셀카나 사진을 업로드하면 Nano Banana 2 Lite가 인물을 다양한 위치로 이동시키고, 이미지를 선택하면 Gemini Omni가 이를 애니메이션 비디오로 변환합니다.
워크플로우는 기본적으로 다음과 같습니다:
사진 → 새로운 장면 → 애니메이션 클립
창의적인 결정이 애니메이션 시작 전에 이루어지기 때문에, 이는 AI 생성 이미지를 애니메이션화하는 매우 실용적인 방법입니다.
또 다른 데모는 Space Lift입니다. Nano Banana 2 Lite가 먼저 업로드된 방을 재디자인한 후, Gemini Omni가 선택된 인테리어 컨셉을 시네마틱한 무빙 쇼케이스로 변환합니다.
비디오 모델에 방을 재디자인하면서 동시에 카메라를 움직이도록 요청하는 대신, 먼저 방이 어떻게 변해야 할지 결정합니다.
그다음 이를 애니메이션으로 만듭니다.
구글의 세 번째 예시는 아마도 가장 상업적으로 유용할 것입니다: Omni Product Studio는 Nano Banana 2 Lite의 정적 제품 이미지를 Gemini Omni를 사용하여 이커머스 비디오로 변환합니다.
이는 본질적으로 AI 제품 비디오 워크플로우입니다:
제품 이미지 생성 → 제품 이미지 승인 → 제품 이미지 애니메이션화 → 비디오 다듬기
마케터와 온라인 스토어에게는 매번 완전히 다른 제품 샷을 맹목적으로 생성하는 것보다 이것이 훨씬 더 유용합니다.
단순한 이미지 투 비디오를 넘어선 기능
Omni의 흥미로운 점은 이 워크플로우가 정적 이미지 한 장에서 멈추지 않는다는 것입니다.
프로젝트에 추가적인 시각적 참조나 모션 가이드가 필요하다면, Movmix에는 Gemini Omni Reference to Video 워크플로우도 마련되어 있습니다.
이는 다음과 같은 새로운 형태의 창작을 가능하게 합니다:
하나의 자산으로 피사체의 외형을 정의하고, 다른 자산으로 샷의 움직임을 전달할 수 있습니다.
이 지점에서 멀티모달 비디오는 전통적인 '이미지 한 장을 업로드하고 결과를 기대하는' 이미지 투 비디오 방식보다 훨씬 유용해지기 시작합니다.
Gemini Omni Flash의 한계
아직 새로운 모델인 만큼, Google은 현재의 제한 사항을 명확히 밝히고 있습니다.
Gemini Omni Flash는 현재 10초 분량의 비디오를 생성합니다. Google은 또한 업로드된 오디오 참조 및 장면 확장이 현재 Gemini API를 통해 지원되지 않는다고 명시했습니다. 최대 3초의 비디오 참조는 API 스키마에서 허용될 수 있지만, 모델에서 아직 올바르게 처리되지 않으며 장면 전환이나 큰 패닝 움직임 시 캐릭터 일관성이 약해질 수 있습니다.
따라서 아직 다음과 같은 단계는 아닙니다:
“아무거나 업로드해서 완벽한 2분짜리 영화를 만들고 퇴근하기.”
현재 가장 강력한 활용 사례는 훨씬 더 집중되어 있습니다:
강력한 첫 프레임을 구축하고, 명확한 움직임을 부여한 후, 짧은 클립을 생성하여 다듬습니다.
솔직히 말해, 이것만으로도 이미 충분히 유용합니다.
새로운 AI 모델 출시보다 중요한 이유
여기서 가장 큰 변화는 구글이 또 다른 이미지 모델과 비디오 모델을 내놓았다는 사실이 아닙니다.
두 영역 간의 경계가 사라지고 있다는 점입니다.
이미지 생성이 비디오 생성의 일부가 됩니다.
비디오 편집 또한 생성 과정의 일부가 됩니다.
참고 자료(Reference)가 프롬프팅의 일부가 됩니다.
모든 것을 완벽하게 처리하는 신비로운 단일 모델을 찾기보다는, 크리에이터는 하나의 아이디어를 구현하는 각 단계에 맞춰 다양한 도구를 활용할 수 있습니다.
실무 워크플로우 관점에서 보면 이 접근 방식이 훨씬 더 합리적입니다.
완전히 새로운 이미지가 필요하신가요? Nano Banana 2 Lite Text to Image로 시작하세요.
이미 보관할 만한 이미지가 있다면, 이를 다듬어 보세요.
첫 번째 프레임이 준비되면 Gemini Omni에 입력하고 장면의 다음 동작을 지시하세요.
구글의 새로운 워크플로우는 한 문장으로 요약할 수 있습니다:
원하는 프레임을 먼저 만들고, 그다음 움직임을 추가하세요.
2026년 AI 비디오 제작 환경에서 이는 겉으로 들리는 것보다 훨씬 더 큰 변화일 수 있습니다.