當你開啟一個支援多種模型的 AI 影片平台時,最困難的部分往往不是撰寫提示詞。
而是決定:
「我究竟該為這段影片選擇哪個模型?」
Wan、Seedance 和 Kling 都能生成影片,但這並不意味著它們的使用方式完全相同。
產品廣告與時尚 Reel 面臨的問題截然不同。故事驅動的場景所需的控制項,也不同於簡單的圖生影片片段。一旦涉及對話、多個角色、參考動作或複雜互動,模型選擇就變得更加關鍵。
因此,在為不同使用情境選擇 AI 影片模型時,不要先問哪個模型最強大。
從一個更好的問題開始:
我要創作的影片中,最難處理的部分是什麼?
在 Movmix 上,你可以先使用 GPT Image 2.5、Nano Banana、Grok Image 或 Seedream 等圖像模型準備一張高品質的首幀,然後再進入影片生成階段。
一個實用的工作流程如下:
準備圖像 → 選擇影片模型 → 描述動作與鏡頭 → 生成 → 解決實際問題
你可以從 Movmix AI 影片生成器開始,根據使用情境而非模型名稱來選擇模型。
快速指南:哪種 AI 影片模型適合你的使用情境?
| 影片情境 | 建議優先嘗試的模型 | 關鍵重點 |
|---|---|---|
| 自然呈現單張圖像動畫 | Wan / Kling | 簡單動作、首幀一致性 |
| 產品廣告 | Wan | 產品結構、攝影機、燈光 |
| 時尚、Reels、角色片段 | Kling / Wan | 臉部、服裝、肢體動作 |
| 從參考影片轉移動作 | Kling / Seedance / Wan | 角色身份 vs. 參考動作 |
| 多鏡頭敘事 | Seedance | 時機、鏡頭推進、連貫性 |
| 多角色對話 | Kling / Seedance | 發言順序、語音、時機 |
| 複雜動作或多人群體 | Seedance / Kling | 動作關係、物理一致性 |
| 多參考創意工作流程 | Seedance | 圖片、影片和音訊參考的明確角色分工 |
這並非絕對的排名。
同一個場景往往可以使用多種模型來生成。真正的關鍵在於你希望模型最擅長處理任務的哪一部分。
情境一:你有一張圖片,只想讓它自然動起來
這是最常見的圖生影片(Image-to-Video)應用案例。
也許你有一張人像照,只希望人物轉向鏡頭;或者你想讓寵物抬起頭,又或是讓城市照片因人群、樹木和光影而產生細微的動態。
你不需要複雜的劇情。
嘗試使用 Wan 或 Kling
針對這類任務,重要的結構如下:
一個主體 + 一個主要動作 + 一個簡單的鏡頭移動
你的參考圖片已經告訴模型人物、產品或環境的樣子。
影片提示詞應專注於:
接下來發生什麼事?
例如:
本節無需製作完整的示範影片。其原則本身更具實用價值:
不要讓影片提示詞重複圖片中已呈現的所有內容。
情境二:您需要一則產品廣告,且產品外觀必須保持不變
香水、耳機、護膚品、鞋子、家電、飲料——主要問題通常不在於如何讓產品動起來。
而在於如何防止產品發生變形。
如果瓶蓋在四秒後變了形狀,或耳機突然被重新設計,影片看起來可能仍然吸引人,但作為廣告已失去實用價值。
優先嘗試 Wan
針對這類工作流程,一個實用的原則是:
保持產品靜止,讓鏡頭、光影和反射產生動態。
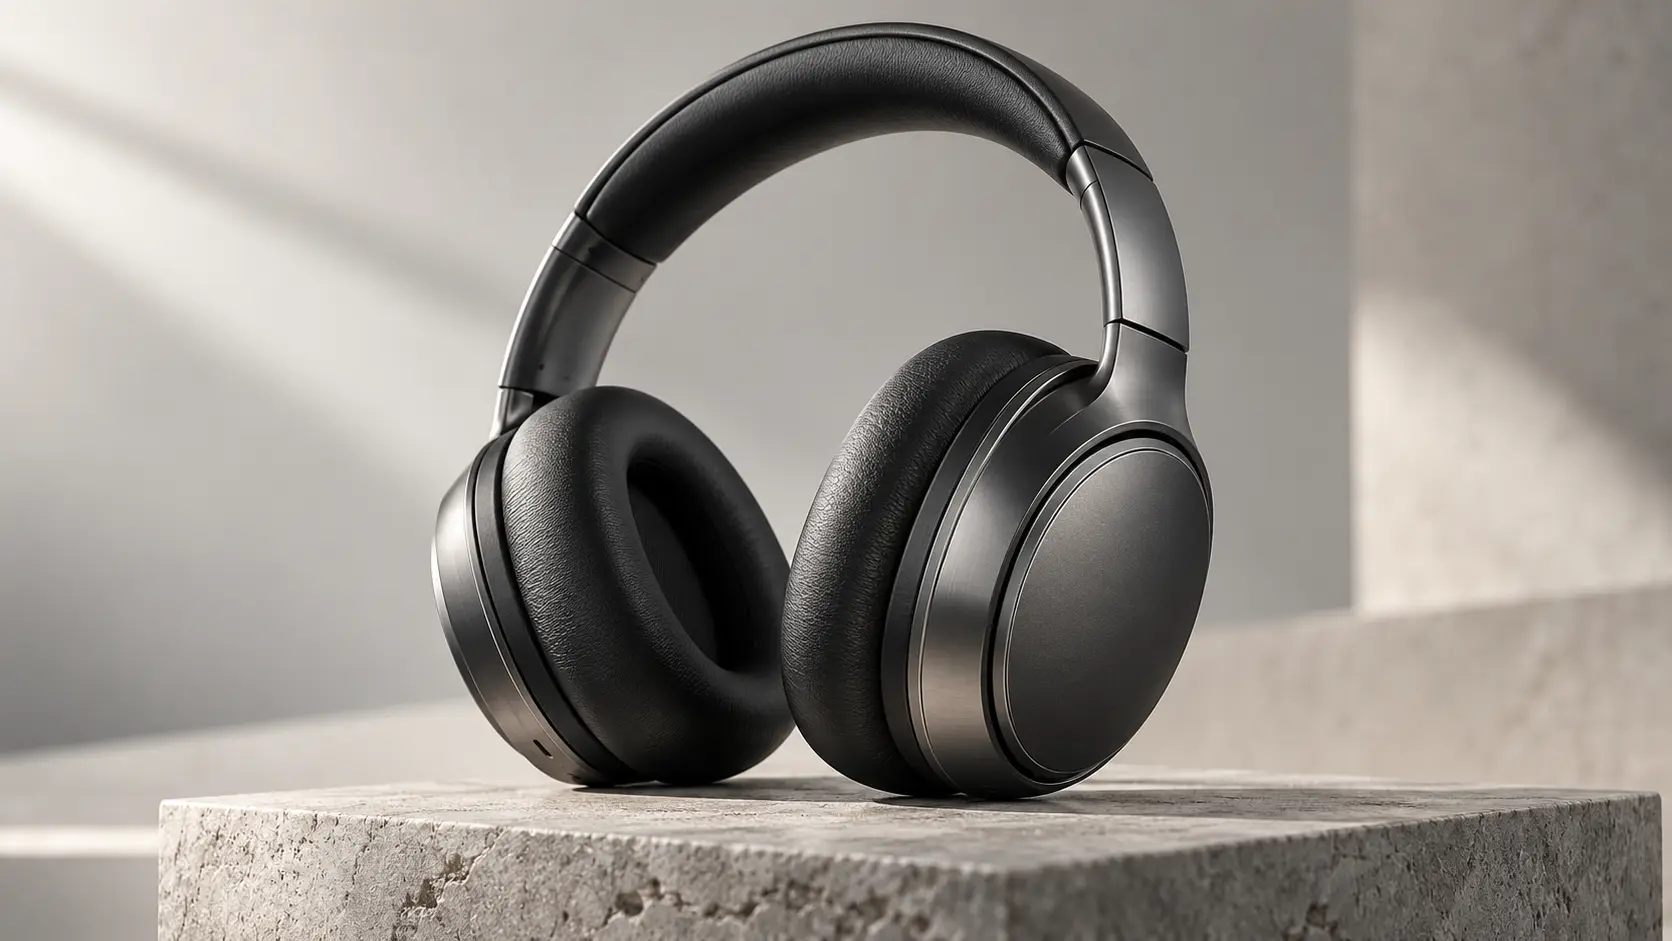
完整工作流程 1:高級耳機商業廣告
步驟 1:準備首幀畫面
如果您已有優質的產品圖片,請直接使用。
如果沒有,請先使用 Movmix 的其中一種圖像生成模型,創建一張具有強烈商業風格的圖片。
| 首幀圖像提示詞 | 輸出圖像 |
|---|---|
| 一副高級頭戴式無線耳機放置在淺灰色天然石材展示台的中央,深灰色金屬框架和柔軟的皮革耳墊清晰可見,極簡現代攝影棚背景,柔和側光強調材質質感,逼真的商業產品攝影,低角度特寫,構圖簡潔,16:9,無文字、無商標、無浮水印。 |
 |
步驟 2:上傳圖片並選擇 Wan
開啟 Movmix 的「圖生視頻」功能,上傳產品圖片,並選擇可用的 Wan 視頻模型。
步驟 3:僅設計您實際需要的動作
視頻提示詞:
步驟 4:修正問題,而非重寫整個提示詞
如果產品形狀發生變化,請減少產品本身的移動,將動態轉移至攝影機運動或燈光變化上。
如果攝影機移動速度太快,僅調整攝影機速度即可。
如果背景不斷晃動,請明確指示模型保持背景完全穩定。
這比在每次生成失敗後重寫整個提示詞更有用。
情境 3:您需要時尚、Reels 或以角色為主的社群影片
角色影片的失敗模式完全不同。
對於產品,您擔心的是形狀。
對於人物,您擔心的是這一點:
影片開頭的人物,到結尾時看起來已不再是同一個人。
嘗試使用 Kling 或 Wan
對於時尚、生活方式、虛擬角色和社群媒體短片,請專注於以下三點:
身份一致性 + 簡單動作 + 清晰的攝影機運動
例如:
如果動作簡單,Wan 和 Kling 都是值得測試的合理選項。
如果鏡頭涉及更複雜的身體表演、攝影機追蹤或多個參考素材,則更適合測試 Kling。
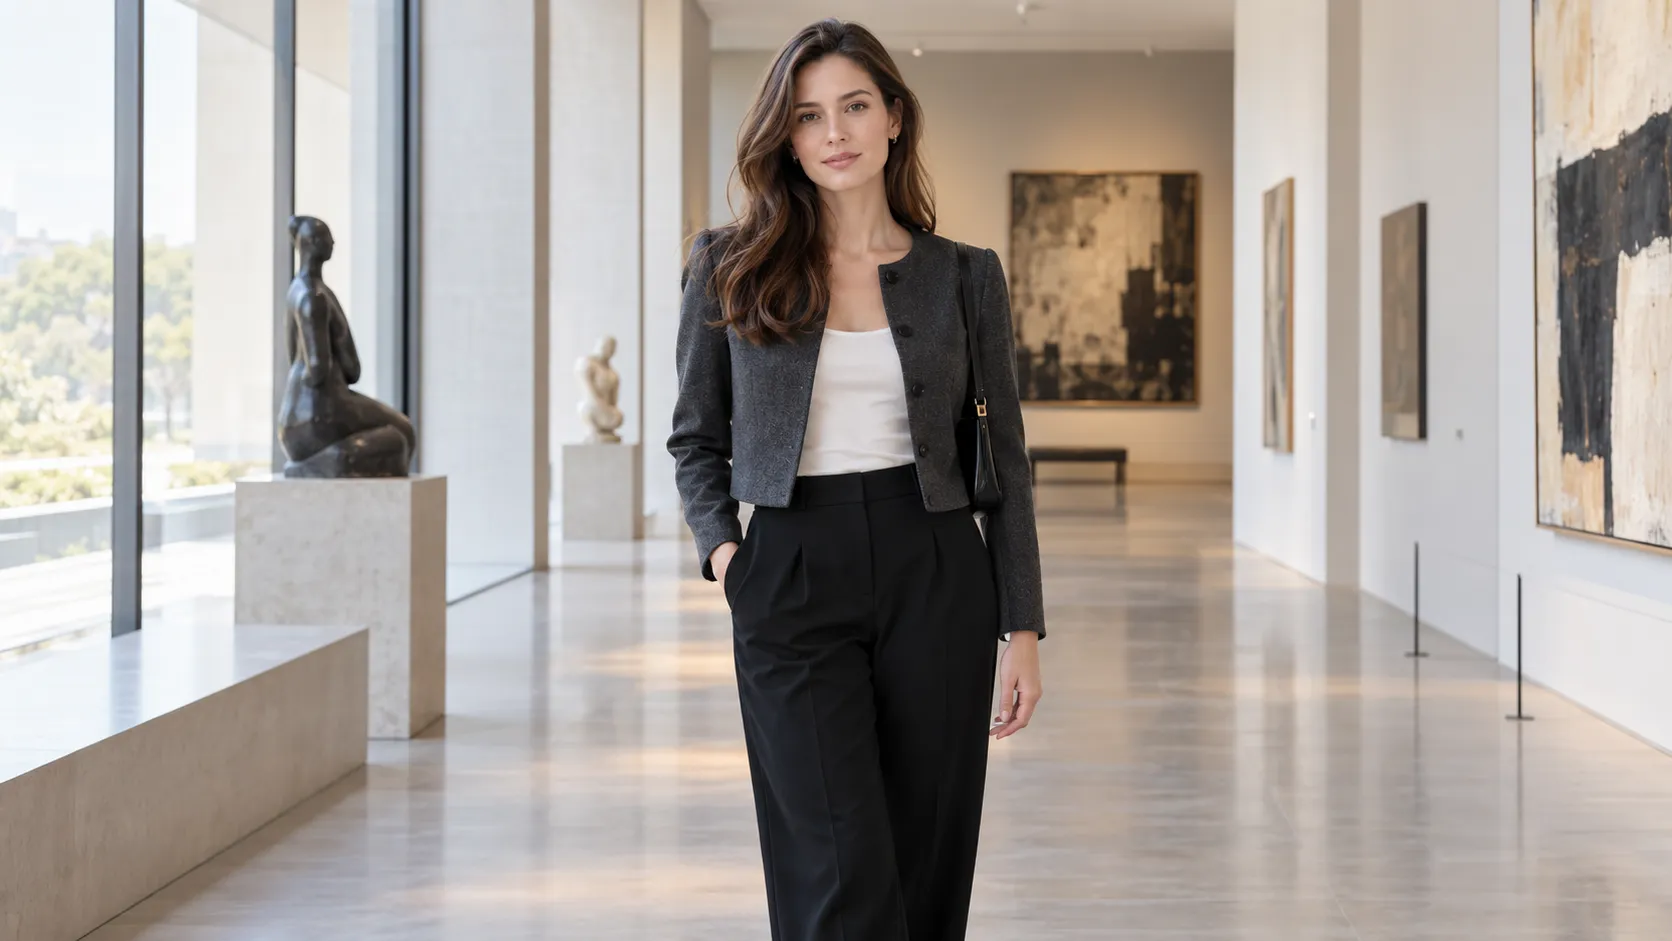
| 圖像提示詞 | |
|---|---|
| 16:9 橫向圖片,一位歐洲女性站在現代藝術畫廊的走廊中,身穿精緻的深灰色短夾克、白色上衣和黑色長褲,自然地準備向前行走,面部細節清晰,背景為現代建築線條,柔和的自然光線,寫實的高級時尚攝影風格,中景至全身構圖,無文字、無標誌、無浮水印。 |
 |
情境四:你有一張角色圖片,並想從另一段影片中複製動作
這已不再是普通的圖生影片。
你現在有兩個不同的參考素材,分別承擔不同的任務。
圖片負責回答:
誰來表演?
影片負責回答:
他們該如何動作?
例如,你可能有一張人物肖像,以及一段獨立的運動、舞蹈或表演影片。你希望圖片中的人物能執行影片中的動作。
嘗試 Kling、Seedance 或 Wan 的參考工作流程
此情境中最重要的規則是:
參考圖片 = 誰
參考影片 = 如何
不要只是告訴模型:
「做得像參考素材一樣。」
要明確告訴它每個參考素材各自控制什麼。
完整工作流程 2:將籃球動作轉移至另一個角色
假設您擁有:
圖片 A:一名成年男性角色
影片 B:一名運動員進行快速運球和轉身動作
目標並非重新生成影片 B 中的運動員。
目標是讓圖片 A 中的角色執行影片 B 中的動作。
影片提示詞
這是值得製作的影片示範之一,因為結果能立即說明單靠文字無法傳達的內容:
一個參考控制身份,另一個控制動作。
情境 5:您想要一個小故事,而不僅是單一動作
一旦您的請求開始聽起來像這樣:
角色做了 A,然後發生 B,接著他們注意到 C,最後做出反應。
您不再只是創建簡單的動作片段。
您正在創作一個故事。
試用 Seedance
針對這類內容,提示詞不應只是視覺形容詞的堆砌。
它應該描述一個序列:
首先發生什麼 → 接著產生什麼變化 → 鏡頭如何跟隨 → 場景在哪裡結束
完整工作流程 3:天文台中的意外發現
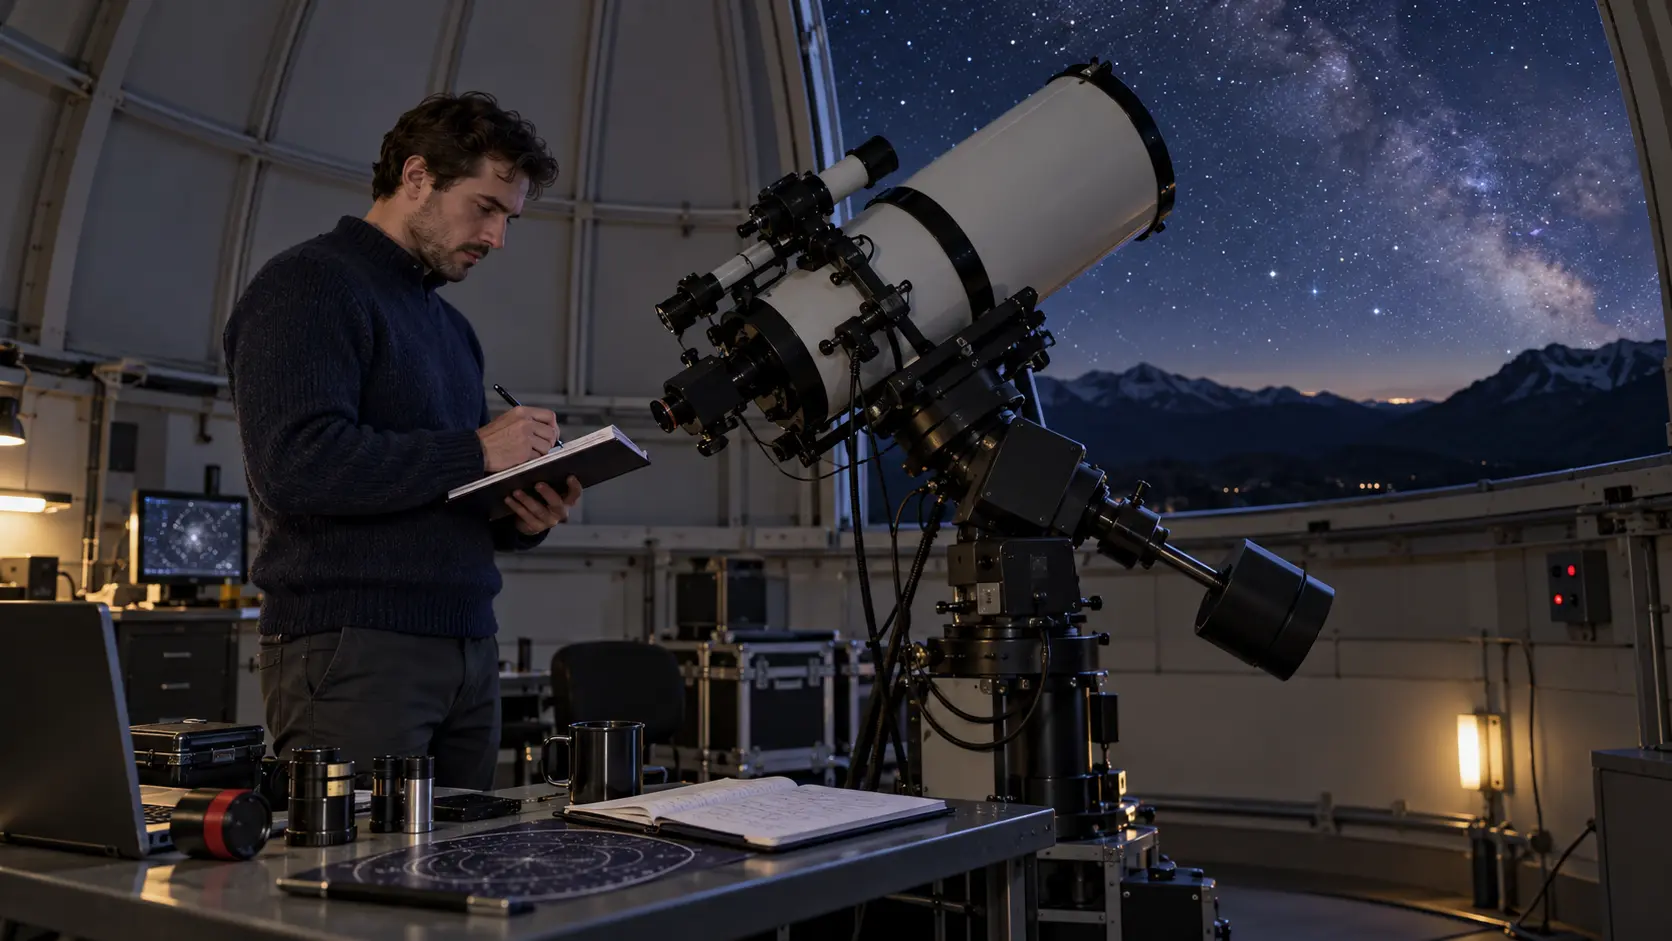
步驟 1:建立首幀
| 圖片提示詞 | 輸出結果 |
|---|---|
| 一位 35 歲的成年男性天文研究員,站在寧靜的山頂天文台內,身穿深藍色針織毛衣和深色長褲,在大型望遠鏡旁記錄觀測數據,桌上放著筆記本和簡易科學儀器,透過天文台圓頂開口可見清澈的夜空,寫實紀錄片攝影風格,中景鏡頭,平靜自然的室內光線,16:9 畫幅。 |
 |
步驟 2:選擇 Seedance
這次,我們需要的不僅僅是單一的動作。
我們需要一個事件。
影片提示詞
這裡的重點不在於提示詞本身。
而在於知道你的專案何時從「動作」轉變為「敘事」。
情境六:兩個或以上角色需要對話
一旦場景中出現對話,您的選擇標準就會再次改變。
現在,模型不僅需要呈現吸引人的視覺效果。
它還需要處理:
角色身份、說話順序、語音、時機以及口型動作
嘗試使用 Kling 或 Seedance
不要只寫:
兩名設計師討論一個專案。
這會讓幾乎所有細節都處於未定義狀態。
更好的結構是:
角色 A 先說話 → 角色 B 反應 → 角色 B 回答 → 鏡頭切換 → 環境保持穩定
當對話變得重要時,音訊就成為場景邏輯的一部分,而非可有可無的附加項。
除非對話是您希望在網站上展示的主要功能之一,否則您無需在此處創建單獨的示範影片。
情境七:複雜動作、運動、表演或多個人物
這些場景是對 AI 影片模型進行更嚴格測試的地方。
例如雙人運動、協調表演、多個角色同時移動、身體互動,或需要在多個主體之間移動的鏡頭。
試試 Seedance 或 Kling
這裡的主要教訓出乎意料地簡單:
不要試圖用一個更長的句子來解決複雜性。
將關係拆解開來。
與其這樣寫:
兩人執行激烈的動作,同時鏡頭以電影感的方式移動。
不如明確定義:
角色 A 從這裡開始。角色 B 從那裡開始。角色 A 先移動。角色 B 做出回應。他們在此時互動。鏡頭位於此處。
動作越複雜,解釋誰做了什麼就變得越重要。
這比添加「動態」、「史詩」或「高能量」等多餘詞彙要有用得多。
情境 8:你已經擁有圖片、影片、音訊和分鏡圖
有時候,問題不在於缺乏素材。
而在於素材太多。
你可能已經擁有:
- 角色圖片
- 環境參考資料
- 動作影片
- 音樂
- 音效
- 分鏡圖
此時,挑戰在於參考素材管理。
試試 Seedance
關鍵不在於盡可能上傳大量素材。
關鍵在於為每份參考素材賦予明確的任務。
例如:
圖片 A 控制角色。圖片 B 控制環境。影片 C 控制鏡頭運動。音訊 D 控制聲音風格。
如果你尚未決定每份參考素材負責什麼,模型就必須自行猜測。
而一旦模型開始猜測,增加更多參考素材反而會讓工作流程變得更不清晰,而非更具可控性。
那麼,你該使用哪款 AI 影片生成模型?
不要從以下問題開始:
「Wan、Seedance 或 Kling 哪個最強?」
改問三個更實用的問題。
我已經擁有什麼素材?
只有文字?一張圖片?還是包含圖片、參考影片和音訊?
這段影片最難處理的部分是什麼?
產品一致性?角色身份識別?動作表現?敘事?對話?多角色互動?
哪些部分絕對不能出錯?
臉部?產品結構?動作?場景連貫性?
這些問題通常比泛泛的AI 影片模型比較能提供更多的指引。
如果你只需要將產品圖片轉換為乾淨的商業廣告鏡頭,可能無需從複雜的多鏡頭故事開始。
如果你想讓一個角色執行另一段影片中的動作,一般的圖生影片工作流程已不再足夠。
當你的腳本開始充滿諸如:
「然後」、「接著」、「突然」和「最後」等詞彙時...
您可能不再只是製作簡單的短片。
您是在講述一個故事。
您的模型選擇應隨任務而調整。
最終法則:先確定影片,再選擇模型
在 Movmix 上擁有多種模型的價值,並非僅僅是多了幾個按鈕可點擊。
真正的價值在於不同的任務可以使用不同的工作流程。
使用圖像模型(例如 GPT Image 2.5、Nano Banana、Grok Image 或 Seedream)來準備您真正想要的視覺起點。
然後根據場景下一步需要呈現的效果,選擇 Wan、Seedance、Kling 或其他可用的影片模型。
圖像決定:
外觀長什麼樣子?
影片模型決定:
接下來發生什麼事?
而您的提示詞決定:
該如何發生?
因此,下次當您不確定該選擇哪種AI 影片模型時,請暫時忘記模型名稱。
先描述您真正想要製作的影片。
從那裡開始,通常會更容易選擇合適的模型。