Lorsqu'une plateforme de vidéo IA vous propose plusieurs modèles, la décision la plus difficile n'est souvent pas le prompt, mais le choix du modèle.
Wan 3.0, Seedance 2.5, Kling 4.0 et MiniMax H3 sont tous disponibles sur Movmix, et chacun peut transformer une image ou un prompt en vidéo. Ils ne sont cependant pas interchangeables. Chaque modèle excelle dans un aspect spécifique : préserver l'intégrité d'un produit, maintenir la stabilité d'un visage, reproduire les mouvements d'une vidéo de référence, raconter une courte histoire ou faire dialoguer deux personnages.
Ce guide répond à une question essentielle : quel modèle de vidéo IA utiliser pour la vidéo que vous créez actuellement ? Commencez par consulter le tableau récapitulatif, puis dirigez-vous vers le scénario correspondant à votre projet.
Une publicité pour un produit ne pose pas les mêmes défis qu'un Reel mode. Une scène narrative nécessite des contrôles différents d'un simple clip image-vers-vidéo. Dès lors que des dialogues, plusieurs personnages, des mouvements de référence ou des interactions complexes entrent en jeu, le choix du modèle devient encore plus crucial.
Ainsi, lorsque vous choisissez un modèle de vidéo IA pour différents cas d'usage, ne commencez pas par vous demander quel modèle est le plus puissant.
Posez-vous plutôt cette question :
Quelle est la partie la plus difficile de la vidéo que j'essaie de créer ?
Sur Movmix, vous pouvez d'abord préparer une image initiale de haute qualité avec des modèles d'image tels que GPT Image 2.5, Nano Banana, Grok Image ou Seedream, avant de passer à l'étape de génération vidéo.
Un flux de travail concret ressemble à ceci :
Préparer l'image → Choisir le modèle vidéo → Décrire les mouvements et la caméra → Générer → Résoudre le problème spécifique
Vous pouvez commencer par le Générateur de Vidéos IA Movmix et choisir le modèle en fonction du scénario plutôt que du nom du modèle.
Réponse rapide : Quel modèle de vidéo IA correspond à votre scénario ?
| Scénario vidéo | Modèles à essayer en premier | Ensuite, essayez | Ce qui compte le plus | Ouvrir sur Movmix |
|---|---|---|---|---|
| Animer naturellement une seule image | Wan 3.0 | Kling 4.0 | Mouvement simple, cohérence de la première image | Image vers Vidéo |
| Publicité produit | Wan 3.0 | MiniMax H3 (lorsque le texte ou les logos doivent rester lisibles) | Structure du produit, caméra, éclairage | Image vers Vidéo |
| Mode, Reels, clips de personnages | Kling 4.0 | Wan 3.0 | Visage, vêtements, mouvements corporels | Image vers Vidéo |
| Transférer le mouvement d'une vidéo de référence | Kling 4.0 | Seedance 2.5 / Wan 3.0 | Identité du personnage vs mouvement de référence | Référence vers Vidéo |
| Narration multi-plans | Seedance 2.5 | Kling 4.0 | Timing, progression des plans, continuité | Image vers Vidéo / Générateur d'histoires IA |
| Dialogue multi-personnages | Kling 3.0 ou 4.0 | Seedance 2.5 / MiniMax H3 | Ordre des intervenants, voix, timing | Image vers Vidéo |
| Action complexe ou plusieurs personnes | Seedance 2.5 | Kling 4.0 | Relations de mouvement, cohérence physique | Image vers Vidéo |
| Flux de travail créatif multi-références | Seedance 2.5 | Kling 4.0 | Rôles clairs pour les références d'image, de vidéo et d'audio | Référence vers Vidéo |
Il ne s'agit pas d'un classement absolu.
La même scène peut souvent être créée avec plus d'un modèle. La vraie question est de savoir quelle partie de la tâche vous avez besoin que le modèle gère au mieux.
À quoi sert chaque modèle vidéo sur Movmix
Avant de choisir un modèle par son nom, il est utile de connaître les limites dans lesquelles chacun opère. Les chiffres ci-dessous proviennent des pages de modèles de Movmix et ont été vérifiés en octobre 2026. Les fournisseurs de modèles mettent souvent à jour leurs outils, alors consultez la page du modèle avant de planifier un projet de longue haleine.
| Modèle | Durée maximale par génération | Résolution | Audio natif | Contrôles remarquables | Page du modèle |
|---|---|---|---|---|---|
| Wan 3.0 | Jusqu'à 30 s | Jusqu'à 1080p | Non conçu pour la conversion standard texte-vers-vidéo ou image-vers-vidéo | Texte, image et référence vidéo ; forte cohérence des scènes et des personnages | Wan 3.0 |
| Seedance 2.5 | Jusqu'à 30 s | Dépend des paramètres de la plateforme | Oui | Grands ensembles de références multimodales, extension multi-tours, réédition basée sur les prompts | Seedance 2.5 |
| Kling 4.0 | 30 s natifs | HDR 4K 10 bits | Oui, stéréo avec synchronisation labiale | Jusqu'à 15 références multimodales et 10 images clés sur la timeline | Kling 4.0 |
| Kling 3.0 | 3–15 s | 4K | Oui, voix native et dialogues multilingues | Génération multi-plans, images de début et de fin | Kling 3.0 |
| MiniMax H3 | Jusqu'à 15 s | Jusqu'à 2K | Oui, stéréo 32 kHz | Première image, dernière image ou les deux ; références d'image, de vidéo et audio ; textes et visuels adaptés à la marque | MiniMax H3 |
Aucun de ces chiffres ne détermine à lui seul le choix du modèle. Une limite de 30 secondes est inutile si votre produit change de forme dès la quatrième seconde. Utilisez le tableau pour éliminer certaines options, puis servez-vous des scénarios ci-dessous pour faire votre choix.
Scénario 1 : Vous avez une seule image et souhaitez simplement lui donner un mouvement naturel
Il s'agit du cas d'utilisation le plus courant pour la conversion d'image en vidéo.
Peut-être avez-vous un portrait et souhaitez-vous seulement que la personne se tourne vers la caméra. Ou peut-être voulez-vous qu'un animal lève la tête, ou qu'une photo de ville gagne en subtilité grâce au mouvement des passants, des arbres et de la lumière.
Vous n'avez pas besoin d'une histoire compliquée.
Essayez Wan ou Kling
Pour ce type de tâche, la structure importante est la suivante :
Un sujet + une action principale + un mouvement de caméra simple
Votre image de référence indique déjà au modèle à quoi ressemblent la personne, le produit ou l'environnement.
L'invite vidéo doit se concentrer sur :
Que se passe-t-il ensuite ?
Par exemple :
Le personnage lève lentement la tête et regarde naturellement vers la caméra. Une légère brise crée un mouvement subtil dans les cheveux tandis que la caméra reste stable et avance lentement. Maintenez la cohérence du visage, de la coiffure, des vêtements, des proportions corporelles et de l'arrière-plan du personnage tout au long de la vidéo.
Le principe importe plus que l'exemple :
Ne faites pas répéter à l'invite vidéo tout ce que l'image montre déjà.
Scénario 2 : Vous avez besoin d'une publicité produit et le produit ne doit pas changer
Parfum, écouteurs, soins de la peau, chaussures, appareils électroménagers, boissons — le principal problème n'est généralement pas de savoir comment faire bouger le produit.
Il s'agit plutôt d'empêcher le produit de se transformer.
Si le bouchon d'une bouteille change de forme après quatre secondes ou si une paire d'écouteurs est soudainement redessinée, la vidéo peut sembler attrayante, mais elle n'est plus utile en tant que publicité.
Essayez d'abord Wan
Pour ce type de flux de travail, une règle utile est :
Gardez le produit immobile. Laissez la caméra, l'éclairage et les reflets bouger.
Flux de travail complet 1 : Publicité pour un casque haut de gamme
Étape 1 : Préparez la première image
Si vous disposez déjà d'une bonne image du produit, utilisez-la directement.
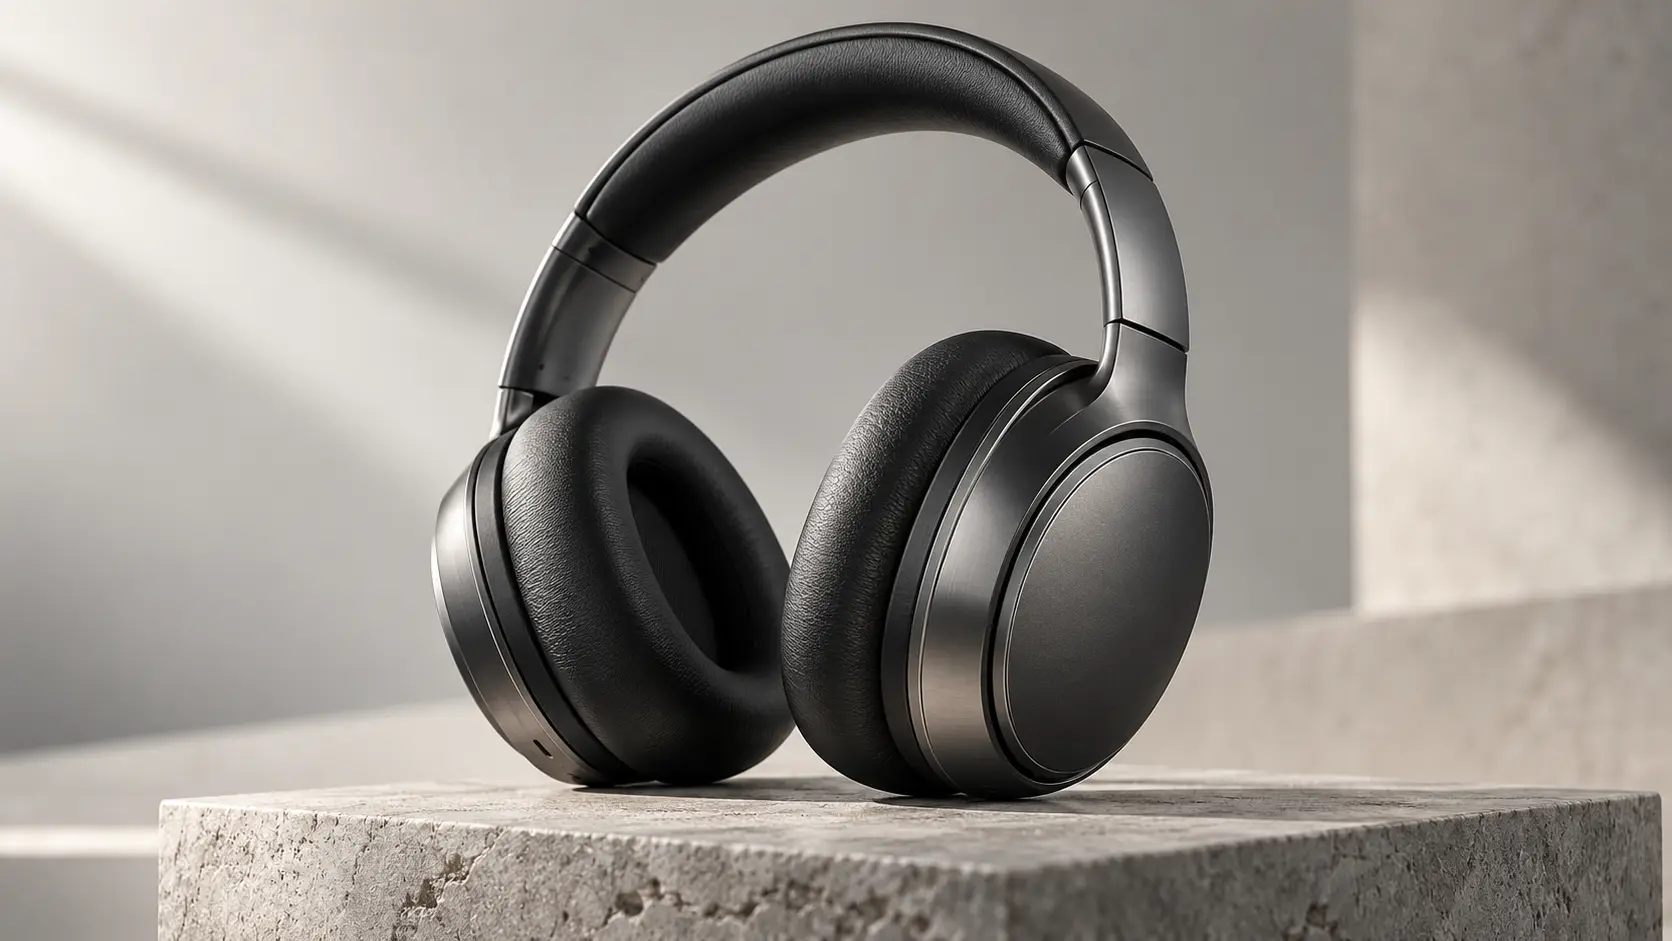
Sinon, commencez par créer une image percutante de style publicitaire avec l'un des modèles de génération d'images de Movmix.
| Prompt pour l'image initiale | Image générée |
|---|---|
| Une paire d'écouteurs sans fil supra-auriculaires haut de gamme placée au centre d'un socle d'exposition en pierre naturelle gris clair, cadre en métal gris foncé et coussinets d'oreille en cuir souple clairement visibles, arrière-plan de studio moderne et minimaliste, éclairage latéral doux mettant en valeur les matériaux, photographie de produit commerciale réaliste, gros plan en contre-plongée, composition épurée, format 16:9, sans texte, sans logo, sans filigrane. |
 |
Étape 2 : Téléchargez l'image et choisissez Wan
Ouvrez Movmix Image to Video, téléchargez l'image du produit et sélectionnez le modèle vidéo Wan disponible.
Étape 3 : Concevez uniquement le mouvement dont vous avez réellement besoin
Prompt vidéo :
Maintenez le casque parfaitement immobile. La caméra se rapproche lentement depuis un angle trois-quarts avant, tandis qu'un doux faisceau lumineux balaye progressivement les coussinets et le cadre métallique, révélant les textures du cuir et du métal. Gardez l'arrière-plan stable. Terminez par un gros plan sur les détails des coussinets. La forme, la couleur, les matériaux, la structure, les commandes et les proportions du casque doivent rester strictement identiques tout au long de la vidéo. Ne redessinez pas le produit.
Étape 4 : Corrigez le problème, pas l'intégralité du prompt
Si le produit change de forme, réduisez ses mouvements et transférez l'action vers la caméra ou l'éclairage.
Si la caméra est trop rapide, modifiez uniquement sa vitesse.
Si l'arrière-plan bouge constamment, indiquez explicitement au modèle de le maintenir parfaitement stable.
C'est plus utile que de réécrire entièrement le prompt après chaque génération échouée.
Lorsque le texte de l'emballage ou un logo doit rester lisible
Certaines vidéos de produits échouent pour une raison différente : la forme est préservée, mais l'étiquette devient illisible. Si votre plan dépend d'un nom de marque, d'un texte d'emballage ou d'un slogan court lisibles, MiniMax H3 vaut la peine d'être testé aux côtés de Wan 3.0, car la gestion du texte et des visuels respectueux de la marque fait partie de ses points forts.
Gardez l'instruction précise. Nommez le texte exact qui doit rester lisible, maintenez un mouvement de caméra lent et évitez de demander une rotation complète du produit, car c'est souvent à l'arrière de l'emballage que du texte inventé apparaît.
Exemple de prompt :
Le flacon de soin reste droit et immobile sur son piédestal en pierre. La caméra effectue un lent zoom avant depuis une vue de face, tandis qu'une lumière douce glisse sur le verre. Maintenez le texte de l'étiquette « AURA SERUM » net, correctement orthographié et lisible pendant toute la durée de la vidéo. Ne faites pas tourner le flacon. N'ajoutez aucun nouveau texte. Ambiance de studio calme.
Scénario 3 : Vous souhaitez créer des vidéos de mode, des Reels ou du contenu social centré sur un personnage
La vidéo mettant en scène un personnage présente un mode d'échec totalement différent.
Avec un produit, vous vous souciez de la forme.
Avec une personne, voici ce qui vous préoccupe :
La personne visible dans la première seconde ne ressemble plus à la même à la fin.
Essayez Kling ou Wan
Pour la mode, le lifestyle, les personnages virtuels et les clips pour les réseaux sociaux, concentrez-vous sur trois éléments :
Cohérence de l'identité + action simple + mouvement de caméra clair
Par exemple :
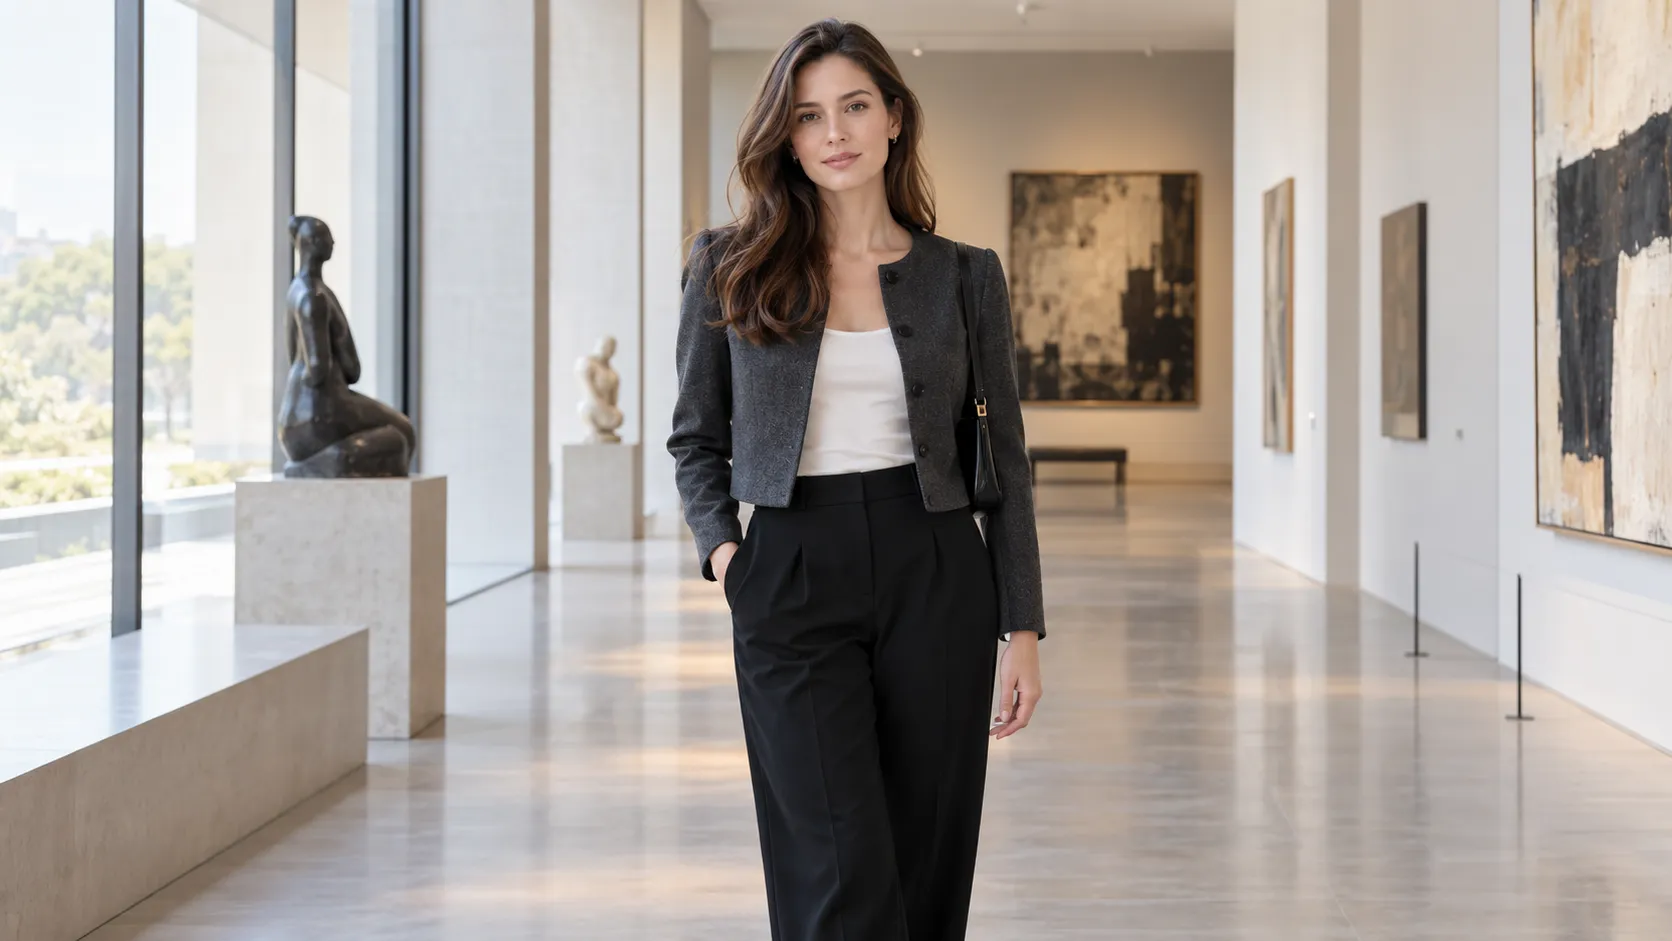
La femme marche lentement vers la caméra, ajuste doucement la manche de sa veste, puis regarde naturellement l'objectif. La caméra recule fluidement tout en maintenant un plan moyen. Conservez le même visage, la même coiffure, les mêmes vêtements, les mêmes proportions corporelles et la même identité tout au long de la vidéo.
Si l'action est simple, Wan et Kling sont tous deux des options raisonnables à tester.
Si la scène implique une performance corporelle plus complexe, un suivi de caméra ou plusieurs assets de référence, Kling devient plus pertinent à tester.
| Prompt d'image | |
|---|---|
| Image horizontale 16:9 d'une femme européenne debout dans un couloir de galerie d'art moderne, portant une veste courte gris foncé raffinée, un haut blanc et un pantalon noir, se préparant naturellement à avancer, détails faciaux nets, lignes architecturales modernes en arrière-plan, éclairage naturel doux, photographie de mode premium réaliste, composition mi-corps à pied entier, sans texte, sans logo, sans filigrane. |
 |
Tournage pour Reels et TikTok : Utilisez une première image verticale
Si le clip est destiné à Instagram Reels ou TikTok, générez la première image au format 9:16 plutôt que de recadrer ultérieurement un résultat 16:9. Le recadrage coupe les épaules et les pieds, essentiels pour maintenir la cohérence du corps, et place souvent le visage sur le bord du cadre.
Gardez toute la tenue dans le cadre, laissez un peu d'espace au-dessus de la tête et décrivez une action que le spectateur peut lire sur un petit écran : une rotation, un pas, un regard vers l'objectif. Pour les formats sociaux prêts à l'emploi, les modèles Reel Ready couvrent les clips en coulisses, les vlogs quotidiens et les transitions tapis rouge sans avoir à écrire de prompt.
Scénario 4 : Vous avez une image de personnage et souhaitez copier le mouvement d'une autre vidéo
Il ne s'agit plus d'une simple conversion image-vers-vidéo.
Vous disposez désormais de deux références distinctes remplissant deux fonctions différentes.
L'image répond à la question :
Qui doit jouer ?
La vidéo répond à la question :
Comment doit-il bouger ?
Par exemple, vous pouvez avoir le portrait d'une personne et une vidéo séparée de sport, de danse ou de performance. Vous souhaitez que la personne sur l'image exécute les mouvements de la vidéo.
Essayez les flux de travail avec référence de Kling, Seedance ou Wan
La règle la plus importante dans ce scénario est la suivante :
Image de référence = QuiVidéo de référence = Comment
Ne dites pas simplement au modèle :
« Fais-le comme la référence. »
Indiquez-lui exactement ce que chaque référence contrôle.
Flux de travail complet 2 : Transférer les mouvements de basket-ball vers un autre personnage
Supposons que vous ayez :
Image A : un personnage masculin adulte
Vidéo B : un athlète effectuant un dribble rapide et un mouvement de rotation
L'objectif n'est pas de régénérer l'athlète de la Vidéo B.
L'objectif est de faire exécuter au personnage de l'Image A les mouvements de la Vidéo B.
Prompt vidéo
Utilisez l'Image A comme référence pour l'identité et l'apparence du personnage. Conservez la cohérence des traits du visage, de la coiffure, des vêtements, des proportions corporelles et de l'identité du personnage. Utilisez la Vidéo B comme référence pour les mouvements, le rythme et la dynamique corporelle. Faites en sorte que le personnage de l'Image A suive le même rythme de dribble, les mêmes mouvements de rotation et les mêmes transferts de poids que ceux montrés dans la Vidéo B. Préservez une physique humaine naturelle. Ne copiez pas le visage ni l'identité de la personne dans la Vidéo B. Suivez le mouvement de caméra de la Vidéo B tout en maintenant la stabilité de l'environnement.
Le résultat illustre l'idée plus clairement que toute explication : Une référence contrôle l'identité. L'autre contrôle le mouvement.
Référence vers Vidéo, Vidéo vers Vidéo ou AI Recast ?
Movmix propose trois outils qui combinent tous un personnage avec des mouvements existants. Ils résolvent des problèmes différents, il est donc important de choisir judicieusement.
- Référence vers Vidéo : partez d'une image de personnage et d'un clip de mouvement pour générer une toute nouvelle vidéo dans laquelle votre personnage exécute ce mouvement. À utiliser lorsque vous souhaitez créer une nouvelle scène.
- Vidéo vers Vidéo : partez d'une vidéo existante et transférez ses mouvements vers un nouveau look ou style. À utiliser lorsque la séquence originale sert de base et que vous souhaitez la restyliser.
- AI Recast : partez d'une vidéo existante et remplacez la personne qui s'y trouve par un autre personnage, tout en conservant le mouvement original. À utiliser lorsque la séquence est correcte et que seul l'interprète doit changer.
Si vous hésitez, demandez-vous ce que vous souhaitez conserver. Conserver le mouvement et créer une nouvelle scène : Référence vers Vidéo. Conserver la séquence et changer le style : Vidéo vers Vidéo. Conserver la séquence et changer la personne : AI Recast.
Scénario 5 : Vous souhaitez une petite histoire, pas seulement une action isolée
Une fois que votre demande commence à ressembler à ceci :
Le personnage fait A, puis B se produit, ensuite il remarque C, et enfin il réagit.
Vous ne créez plus un simple clip de mouvement.
Vous créez une histoire.
Essayez Seedance
Pour ce type de contenu, le prompt ne doit plus se comporter comme une collection d'adjectifs visuels.
Il doit décrire une séquence :
Ce qui se passe en premier → ce qui change → comment la caméra suit l'action → où la scène se termine
Flux de travail complet 3 : Une découverte inattendue dans un observatoire
Étape 1 : Créez la première image
| Prompt d'image | Résultat |
|---|---|
| Un homme adulte de 35 ans, chercheur en astronomie, debout dans un observatoire calme au sommet d'une montagne, portant un pull en tricot bleu foncé et un pantalon sombre, enregistrant des données d'observation à côté d'un grand télescope, un carnet et du matériel scientifique simple sur le bureau, ciel nocturne clair visible à travers l'ouverture du dôme de l'observatoire, photographie documentaire réaliste, plan moyen, éclairage intérieur naturel et calme, format 16:9. |
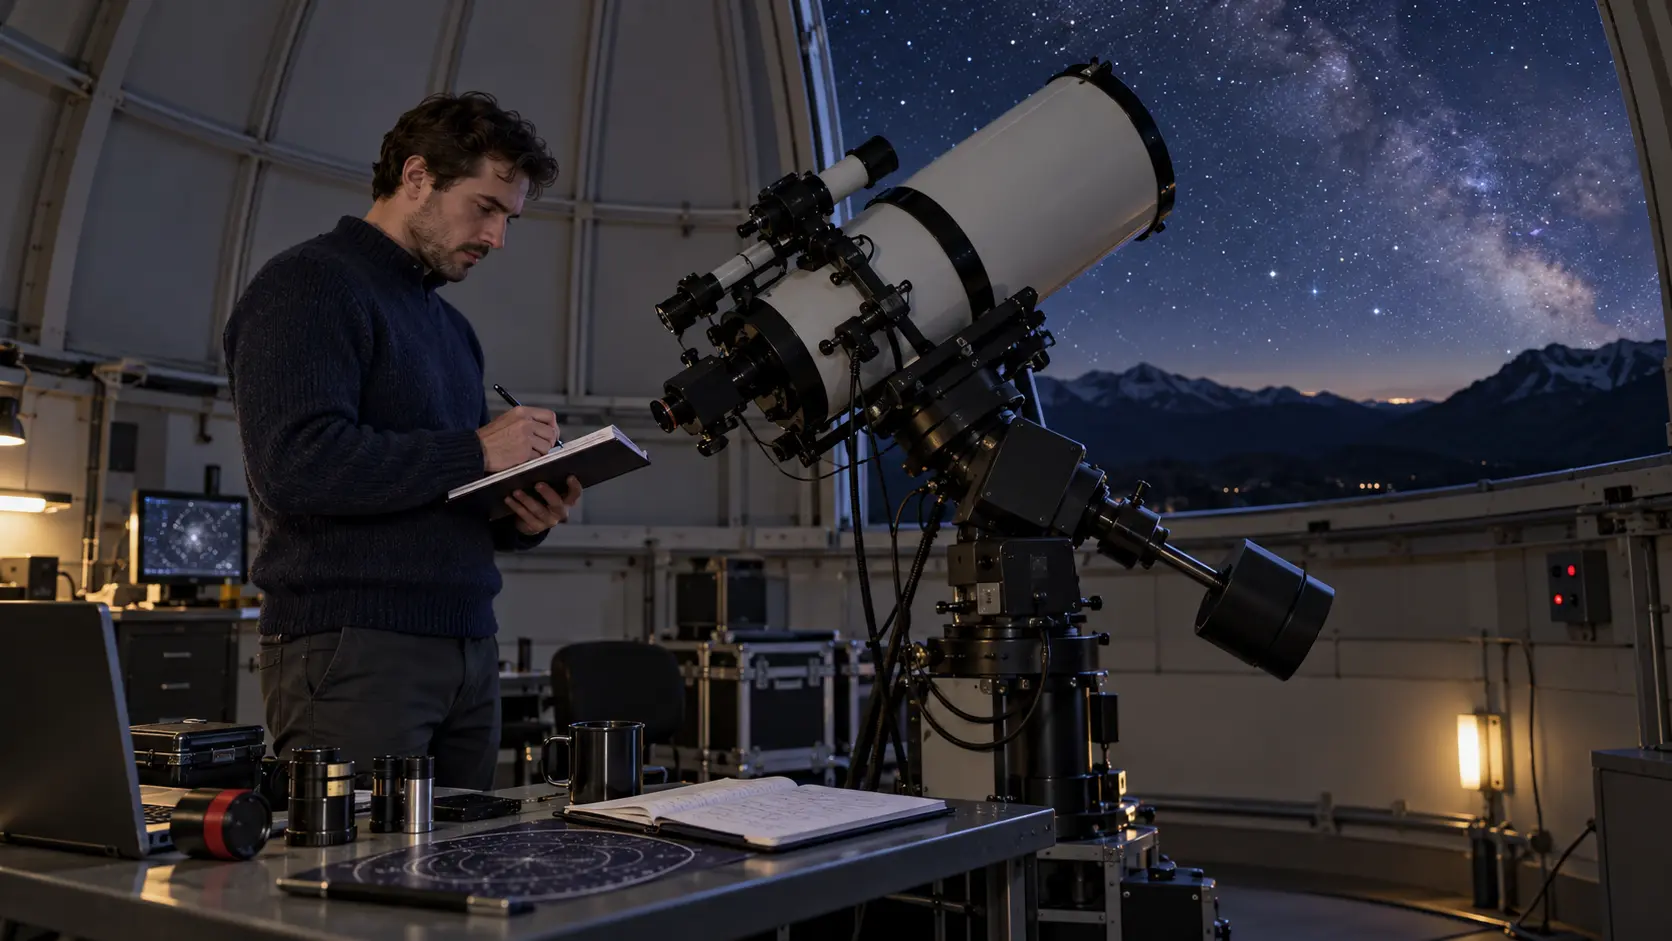 |
Étape 2 : Choisissez Seedance
Cette fois, nous avons besoin de plus qu'un simple mouvement.
Nous avons besoin d'un événement.
Prompt vidéo
Le chercheur baisse les yeux et note des données dans son carnet. Un bref signal sonore émane de l'équipement voisin. Il cesse d'écrire, lève la tête, regarde vers le dispositif de surveillance, puis se dirige rapidement vers le télescope pour observer le ciel. La caméra le suit de côté, puis passe à son point de vue alors qu'une comète lumineuse traverse lentement le ciel nocturne lointain. Terminez par un plan montrant à la fois le chercheur et la comète à travers la fenêtre de l'observatoire. Maintenez la cohérence de l'identité du chercheur, de la structure de l'observatoire et de l'environnement nocturne. Ajoutez un signal d'alerte subtil de l'équipement, des bruits légers d'écriture et une ambiance intérieure calme.
La leçon importante ici n'est pas le prompt lui-même.
C'est savoir quand votre projet est passé du simple « mouvement » à la « narration ».
Quand l'histoire nécessite plus d'un clip
Une seule génération a ses limites, même à 30 secondes. Lorsque votre plan contient plus de séquences qu'un seul clip ne peut en contenir, structurez l'histoire comme une suite plutôt que de la forcer dans un seul prompt.
Rédigez d'abord le plan, verrouillez le personnage principal avec une image de référence, puis générez scène par scène. Si un clip se termine au bon moment mais trop tôt, prolongez-le avec Video Extend au lieu de tout recommencer. Pour une version guidée de ce flux de travail, l'AI Story Generator transforme une idée en intrigue, visuels et voix off.
Dès que le dialogue entre en scène, vos critères de sélection changent à nouveau.
Désormais, le modèle doit gérer bien plus que de simples visuels attrayants.
Il doit également gérer :
L'identité des personnages, l'ordre des intervenants, la voix, le timing et les mouvements des lèvres
Essayez Kling ou Seedance
Ne vous contentez pas d'écrire :
Deux designers discutent d'un projet.
Cela laisse presque tout indéfini.
Une meilleure structure serait :
Le personnage A parle en premier → Le personnage B réagit → Le personnage B répond → Changement de caméra → L'environnement reste stable
Lorsque le dialogue devient important, l'audio fait partie intégrante de la logique de la scène plutôt que d'être un ajout optionnel.
Exemple d'invite de dialogue
Deux designers sont assis de part et d'autre d'une petite table dans un studio lumineux, une affiche imprimée entre eux. La femme à gauche tape sur l'affiche et dit : « Le titre est trop petit. » L'homme à droite se renverse en arrière, l'étudie une seconde, puis répond : « Alors faisons de toute l'affiche le sujet principal. » Elle rit. La caméra commence par un plan d'ensemble des deux personnages, coupe sur un gros plan de l'homme pendant sa réponse, puis revient au plan d'ensemble. Gardez les visages, les tenues et le studio inchangés. Ambiance naturelle de la pièce, légers bruits de papier, pas de musique.
Notice what the prompt fixes in place: who speaks first, the exact words, who reacts, and where the camera is for each line. Kling 3.0 and Kling 4.0 both generate voice with the picture, and MiniMax H3 and Seedance 2.5 also produce native audio, so it is worth running this prompt on two of them and comparing lip-sync before you commit.
Scénario 7 : Action complexe, sport, performance ou plusieurs personnes
Ces scènes constituent un test beaucoup plus exigeant pour les modèles de vidéo IA.
Parmi les exemples, citons les sports à deux, les performances coordonnées, plusieurs personnages se déplaçant simultanément, les interactions physiques ou une caméra qui doit se déplacer autour de plusieurs sujets.
Essayez Seedance ou Kling
La principale leçon ici est étonnamment simple :
Ne cherchez pas à résoudre la complexité en écrivant une phrase plus longue.
Décomposez la relation.
Au lieu de :
Deux personnes exécutent une action intense tandis que la caméra effectue un mouvement cinématographique.
Définissez :
Le personnage A commence ici. Le personnage B commence là. Le personnage A bouge en premier. Le personnage B répond. Ils interagissent à ce moment-là. La caméra est positionnée ici.
Plus le mouvement est compliqué, plus il devient important d'expliquer qui fait quoi.
C'est bien plus utile que d'ajouter des mots supplémentaires comme « dynamique », « épique » ou « haute énergie ».
Exemple : Deux danseurs, une orbite de caméra
Deux danseurs se font face sur un toit vide au coucher du soleil. Le danseur en veste rouge commence avec trois mouvements de bras nets tandis que le danseur en blanc reste immobile. Au quatrième temps, le danseur en blanc répond avec les mêmes trois mouvements, en miroir. Tous deux s'approchent ensuite l'un de l'autre et se figent dos à dos. La caméra tourne lentement autour d'eux à hauteur de taille pendant toute la séquence et se termine sur une vue de face de la pose finale. Maintenez la cohérence des visages, des tenues et des proportions corporelles des deux danseurs. Vent léger et ambiance urbaine.
Scénario 8 : Vous avez déjà des images, des vidéos, de l'audio et des storyboards
Parfois, le problème ne vient pas d'un manque de matériel.
Il vient d'un excès de matériel.
Vous avez peut-être déjà :
- Images de personnages
- Références d'environnement
- Vidéos de mouvement
- Musique
- Effets sonores
- Images de storyboard
À ce stade, le défi devient la gestion des références.
Essayer Seedance
L'essentiel n'est pas de télécharger autant de matériel que possible.
La clé est d'attribuer un rôle précis à chaque référence.
Par exemple :
L'image A contrôle le personnage. L'image B contrôle l'environnement. La vidéo C contrôle les mouvements de caméra. L'audio D contrôle le style sonore.
Si vous n'avez pas défini la responsabilité de chaque référence, le modèle doit deviner.
Et une fois que le modèle commence à deviner, ajouter plus de références peut rendre le flux de travail moins clair plutôt que plus contrôlé.
Seedance 2.5 est le premier modèle à essayer ici, car il est conçu pour fonctionner avec de grands ensembles de références, et Kling 4.0 est l'option suivante lorsque vous avez également besoin d'images clés temporelles. Dans tous les cas, téléchargez dans Reference to Video, étiquetez chaque fichier dans l'invite selon son rôle, et excluez tout fichier qui n'en a pas.
Le premier clip est proche mais pas parfait : étendre, modifier ou régénérer ?
Choisir le bon modèle vous rapproche du résultat, mais le premier rendu est rarement définitif. Avant de changer de modèle, identifiez le type de problème auquel vous faites face.
- Le clip est bon mais se termine trop tôt : étendez-le. Video Extend prolonge le clip existant afin de conserver tout ce qui fonctionne déjà.
- Le clip est bon sauf pour un élément, comme une tenue ou un arrière-plan : modifiez-le. L'AI Video Editor retravaille une vidéo existante à partir d'une instruction textuelle.
- Le mouvement, l'identité ou le produit est incorrect dès le départ : régénérez, en changeant un seul élément de l'invite à la fois.
- Le même problème apparaît après deux ou trois tentatives ciblées : essayez maintenant le modèle suivant dans le tableau de réponse rapide.
Changer de modèle devrait être la dernière étape, pas la première réaction.
Alors, quel modèle de vidéo IA devriez-vous utiliser ?
Ne commencez pas par :
« Wan, Seedance ou Kling : lequel est le plus puissant ? »
Posez plutôt trois questions plus utiles.
Quels éléments ai-je déjà à ma disposition ?
Uniquement du texte ? Une seule image ? Ou des images, des vidéos de référence et de l'audio ?
Quelle est la partie la plus difficile de cette vidéo ?
La cohérence du produit ? L'identité du personnage ? Le mouvement ? La narration ? Les dialogues ? L'interaction entre plusieurs personnages ?
Que ne doit-on absolument pas rater ?
Le visage ? La structure du produit ? Le mouvement ? La continuité de la scène ?
Ces questions vous en apprennent généralement bien plus qu'une comparaison générique des modèles de vidéo IA.
Si vous avez simplement besoin de transformer une image de produit en un plan publicitaire propre, il est probablement inutile de commencer par une histoire complexe avec plusieurs plans.
Si vous souhaitez qu'un personnage reproduise le mouvement d'une autre vidéo, un flux de travail classique image-vers-vidéo ne suffit plus.
Et lorsque votre scénario commence à se remplir de mots comme :
« ensuite », « après cela », « soudainement » et « enfin »...
vous ne créez probablement plus un simple clip.
Vous racontez une histoire.
Le choix de votre modèle doit s'adapter à la tâche. Si vous souhaitez comparer ces modèles côte à côte avec le même prompt, commencez par le Générateur de Vidéo IA et changez de modèle sans quitter la page.
Règle finale : Choisissez d'abord la vidéo, puis le modèle
L'intérêt de disposer de plusieurs modèles sur Movmix ne se résume pas à avoir plus de boutons sur lesquels cliquer.
La véritable valeur réside dans le fait que différentes tâches peuvent utiliser différents flux de travail.
Utilisez des modèles d'image tels que GPT Image 2.5, Nano Banana, Grok Image ou Seedream pour préparer le point de départ visuel que vous souhaitez réellement.
Ensuite, choisissez Wan, Seedance, Kling ou un autre modèle vidéo disponible en fonction de ce que la scène doit faire ensuite.
L'image détermine :
À quoi cela ressemble-t-il ?
Le modèle vidéo détermine :
Que se passe-t-il ensuite ?
Et votre prompt détermine :
Comment cela doit-il se produire ?
Ainsi, la prochaine fois que vous hésitez sur le choix du modèle vidéo IA, oubliez un instant les noms des modèles.
Décrivez d'abord la vidéo que vous souhaitez réellement créer.
Le bon modèle devient généralement beaucoup plus facile à choisir à partir de là.
FAQ : Choisir un modèle de vidéo IA
Q : Quel est le meilleur modèle de vidéo IA au global ?
R : Il n’existe pas de modèle unique supérieur aux autres. Wan 3.0 est un excellent premier choix pour des plans produits stables et l’animation simple d’images, Seedance 2.5 pour les courtes histoires et les grands ensembles de références, Kling pour les performances de personnages, le mouvement et les dialogues, et MiniMax H3 pour les courts clips de marque où le texte doit rester lisible. Choisissez en fonction de l’aspect le plus difficile de votre vidéo.
Q : Quel modèle de vidéo IA utiliser pour les publicités produits ?
R : Commencez avec Wan 3.0 en maintenant le produit immobile tandis que la caméra et la lumière bougent. Si l’étiquette, le logo ou le texte sur l’emballage doivent rester lisibles, testez également MiniMax H3. Téléchargez votre photo de produit dans la fonction Image vers Vidéo et verrouillez la forme, la couleur et les matériaux du produit dans votre prompt.
Q : Quel modèle est le mieux adapté pour copier le mouvement d’une autre vidéo ?
R : Utilisez un flux de travail basé sur une référence plutôt qu’une simple conversion image-vers-vidéo. Kling est le premier modèle à essayer, avec Seedance 2.5 et Wan 3.0 en alternatives. Téléchargez l’image du personnage et le clip de mouvement dans la fonction Référence vers Vidéo, et précisez quel fichier contrôle l’identité et lequel contrôle le mouvement.
Q : Puis-je utiliser plusieurs modèles de vidéo IA dans le même projet ?
R : Oui. De nombreux projets fonctionnent mieux ainsi : créez la première image avec un modèle de génération d’images comme GPT Image 2.5 ou Nano Banana, animez les plans produits avec un modèle vidéo, et générez la scène de dialogue avec un autre. Sur Movmix, tous ces modèles sont accessibles depuis un même compte.
Q : Quelle peut être la durée d’une vidéo IA sur Movmix ?
R : Cela dépend du modèle. Wan 3.0, Seedance 2.5 et Kling 4.0 génèrent jusqu’à 30 secondes en une seule fois, tandis que Kling 3.0 et MiniMax H3 vont jusqu’à 15 secondes. Pour des vidéos plus longues, prolongez un clip avec Video Extend ou planifiez l’histoire scène par scène.
Q : Dois-je changer de modèle lorsqu’une génération échoue ?
R : Pas immédiatement. Modifiez d’abord un élément dans le prompt, comme la vitesse de la caméra ou une instruction de cohérence. Si le même problème persiste après deux ou trois nouvelles tentatives ciblées, essayez le modèle suivant adapté à ce scénario.