O Google lançou vários modelos de IA impressionantes recentemente, mas a parte mais interessante da sua última atualização do Gemini pode não ser um único modelo.
É o fluxo de trabalho.
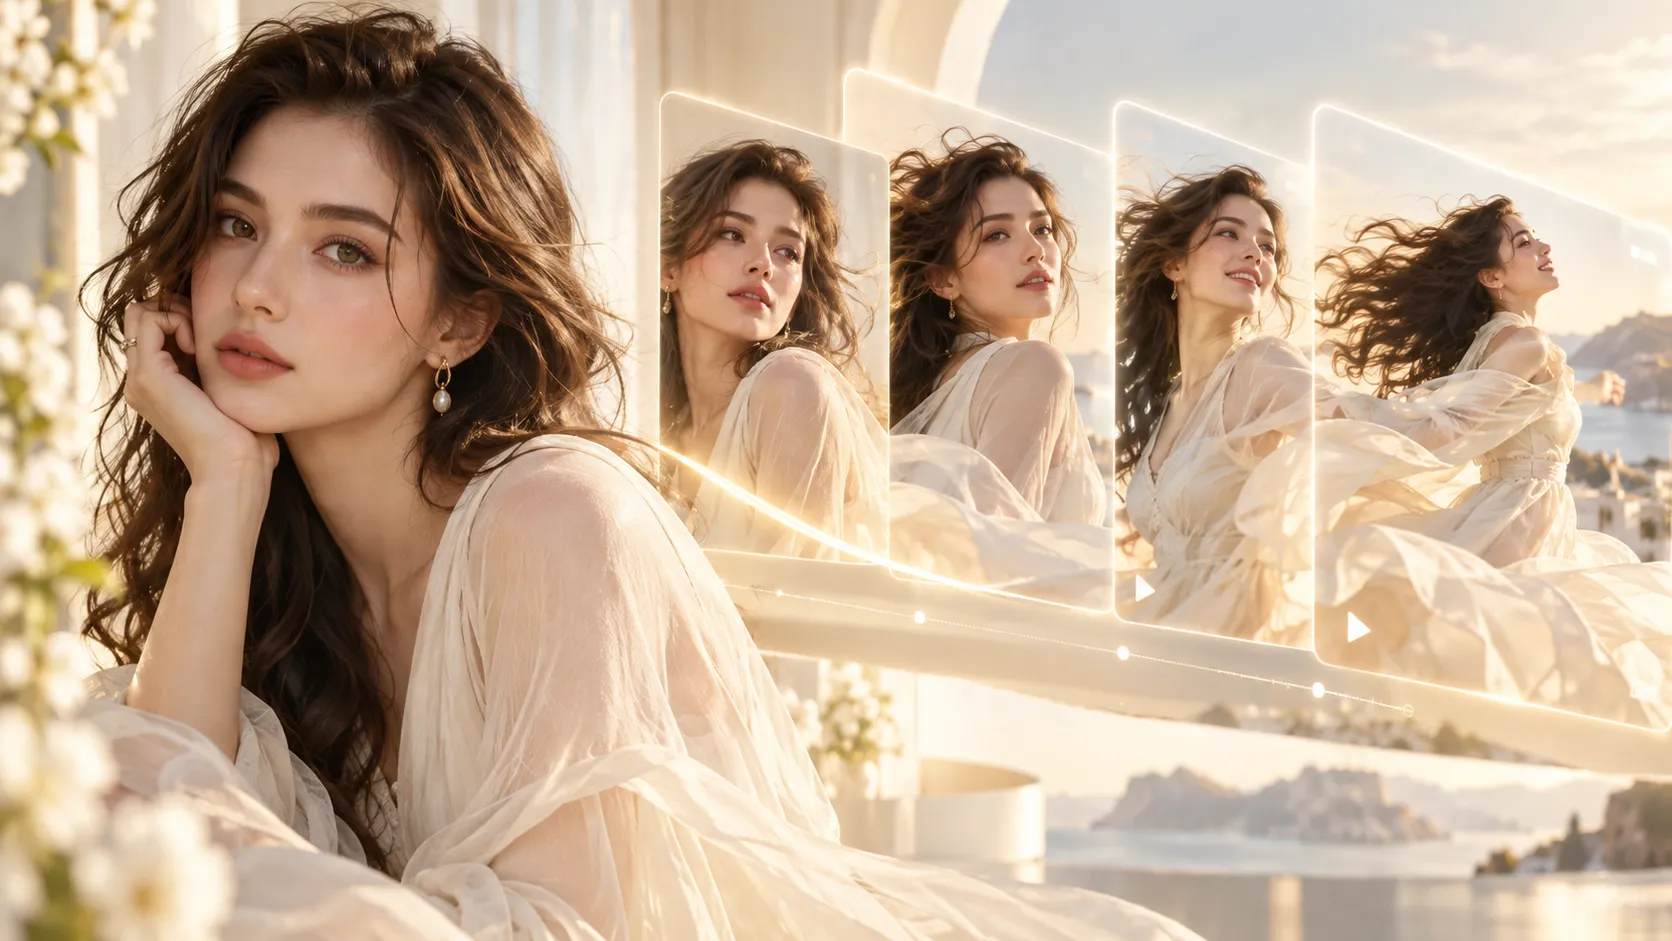
O Google agora mostra explicitamente aos criadores como combinar o Nano Banana 2 Lite com o Gemini Omni Flash: gere ou refine a imagem primeiro e, em seguida, passe essa imagem para o Omni para transformá-la em vídeo.
Em outras palavras:
Acerte o primeiro quadro. Depois, faça-o mover.
Isso pode parecer óbvio, mas resolve um dos maiores problemas dos vídeos gerados por IA: pedir que um único modelo invente o personagem, a composição, o ambiente, o movimento, a câmera e o take final tudo ao mesmo tempo.
O Google descreve o Nano Banana 2 Lite como seu modelo de imagem Nano Banana mais rápido e com melhor custo-benefício, enquanto o Gemini Omni Flash foi projetado para geração de vídeos e edição conversacional usando combinações de entradas de texto, imagens e vídeo. O Google recomenda especificamente encadear os dois modelos para fluxos de trabalho de mídia de ponta a ponta.
E como ambos os fluxos de trabalho estão disponíveis no Movmix, você pode seguir a mesma ideia sem precisar baixar arquivos constantemente e alternar entre ferramentas desconexas.
Primeiro, o que o Google realmente lançou?
Há duas partes nesta atualização.
O Nano Banana 2 Lite foi criado para geração e edição rápida de imagens. O Google afirma que ele pode produzir um resultado de texto para imagem em 1K em cerca de quatro segundos e é otimizado para fluxos de trabalho de alto volume e baixa latência.
Se você estiver começando do zero, pode usar o Nano Banana 2 Lite Text to Image para criar o primeiro quadro.
Já tem uma foto ou imagem de produto? Use o Nano Banana 2 Lite Image to Image para alterar a cena, o estilo ou a composição sem precisar reconstruir tudo desde o início.
Em seguida, vem o Gemini Omni Flash.
O Google posiciona o Omni Flash como um modelo multimodal de geração e edição de vídeo. Ele suporta edição conversacional, referências multimodais, conhecimento do mundo real e sincronização entre texto, gráficos e ações.
Mas a parte mais útil para os criadores do dia a dia é mais simples:
você pode fornecer a imagem que já gosta e focar o prompt de vídeo no que deve acontecer em seguida.
A Mudança Real: Pare de Pedir que o Modelo de Vídeo Faça Tudo
Muitos vídeos de IA ruins começam com um primeiro quadro ruim.
Talvez o rosto esteja ligeiramente errado.
Talvez o produto esteja no ângulo errado.
Talvez a sala não se pareça em nada com o que você imaginou.
Então, escrevemos um prompt de vídeo ainda mais longo e esperamos que o modelo de vídeo conserte tudo magicamente enquanto também anima a cena.
Isso é pedir muito.
Um fluxo de trabalho do primeiro quadro para vídeo melhor separa as tarefas.
O modelo de imagem responde:
Como esta cena deve parecer?
O modelo de vídeo responde:
O que deve acontecer a seguir?
Quando você pensa dessa forma, os prompts se tornam muito mais fáceis de escrever.
Em vez de gastar metade do seu prompt de vídeo descrevendo uma garrafa, um modelo, uma sala ou um outfit que já está visível, você pode usar essas palavras para descrever movimento, timing e comportamento da câmera.
É exatamente por isso que a decisão do Google de conectar o Nano Banana 2 Lite e o Gemini Omni Flash importa mais do que outro gráfico de benchmark.
Como recriar o fluxo de trabalho no Movmix
Vamos usar um anúncio de produto simples.
Você quer transformar uma imagem de cuidados com a pele em um curto vídeo promocional.
Passo 1: Crie o primeiro quadro com Nano Banana 2 Lite
Comece com a imagem.
Por exemplo:
| Prompt | Imagem |
|---|---|
| Frasco premium de cuidados com a pele sobre uma plataforma de pedra lisa, ao lado de folhas verdes frescas, luz suave da manhã, gotas de água sutis, fundo natural limpo, fotografia elegante de produto, 16:9, sem texto, sem logotipo. | 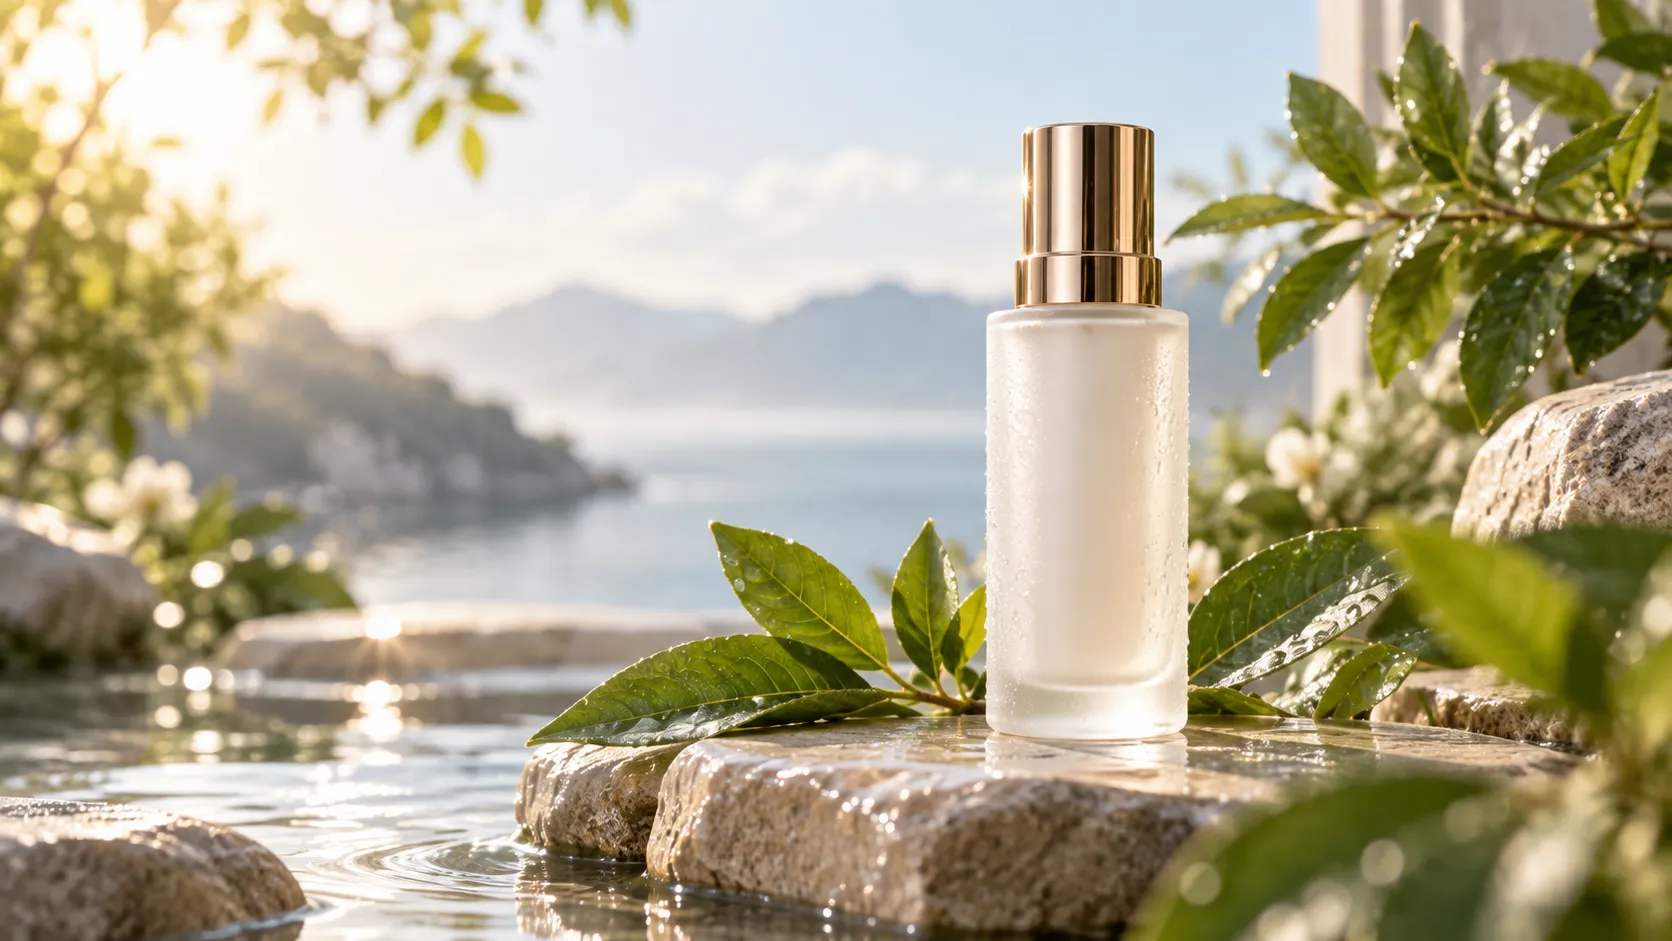 |
Nesta etapa, esqueça completamente o movimento.
Observe o resultado e pergunte: O formato do frasco está correto? A composição está boa? Gosto da iluminação? O fundo está limpo o suficiente?
Se não, corrija a imagem agora.
Isso é muito mais fácil do que descobrir o problema depois que você já gerou o vídeo.
Passo 2: Transforme a imagem em vídeo com o Gemini Omni
Quando o primeiro quadro estiver adequado, faça o upload dele no Gemini Omni Image to Video.
Agora, o prompt pode permanecer focado:
Empurre a câmera lentamente em direção ao produto. Pequenas gotas de água escorrem naturalmente pela garrafa enquanto as folhas se movem suavemente com uma brisa leve. Mantenha a forma da garrafa, a plataforma de pedra, a iluminação e o fundo consistentes. Termine com um close-up limpo e impactante do produto.
Percebe o que está faltando?
Não estamos descrevendo a garrafa novamente.
A imagem já cumpriu esse papel.
O prompt de vídeo controla principalmente:
movimento → câmera → consistência → finalização
Essa é uma divisão de tarefas muito mais clara.
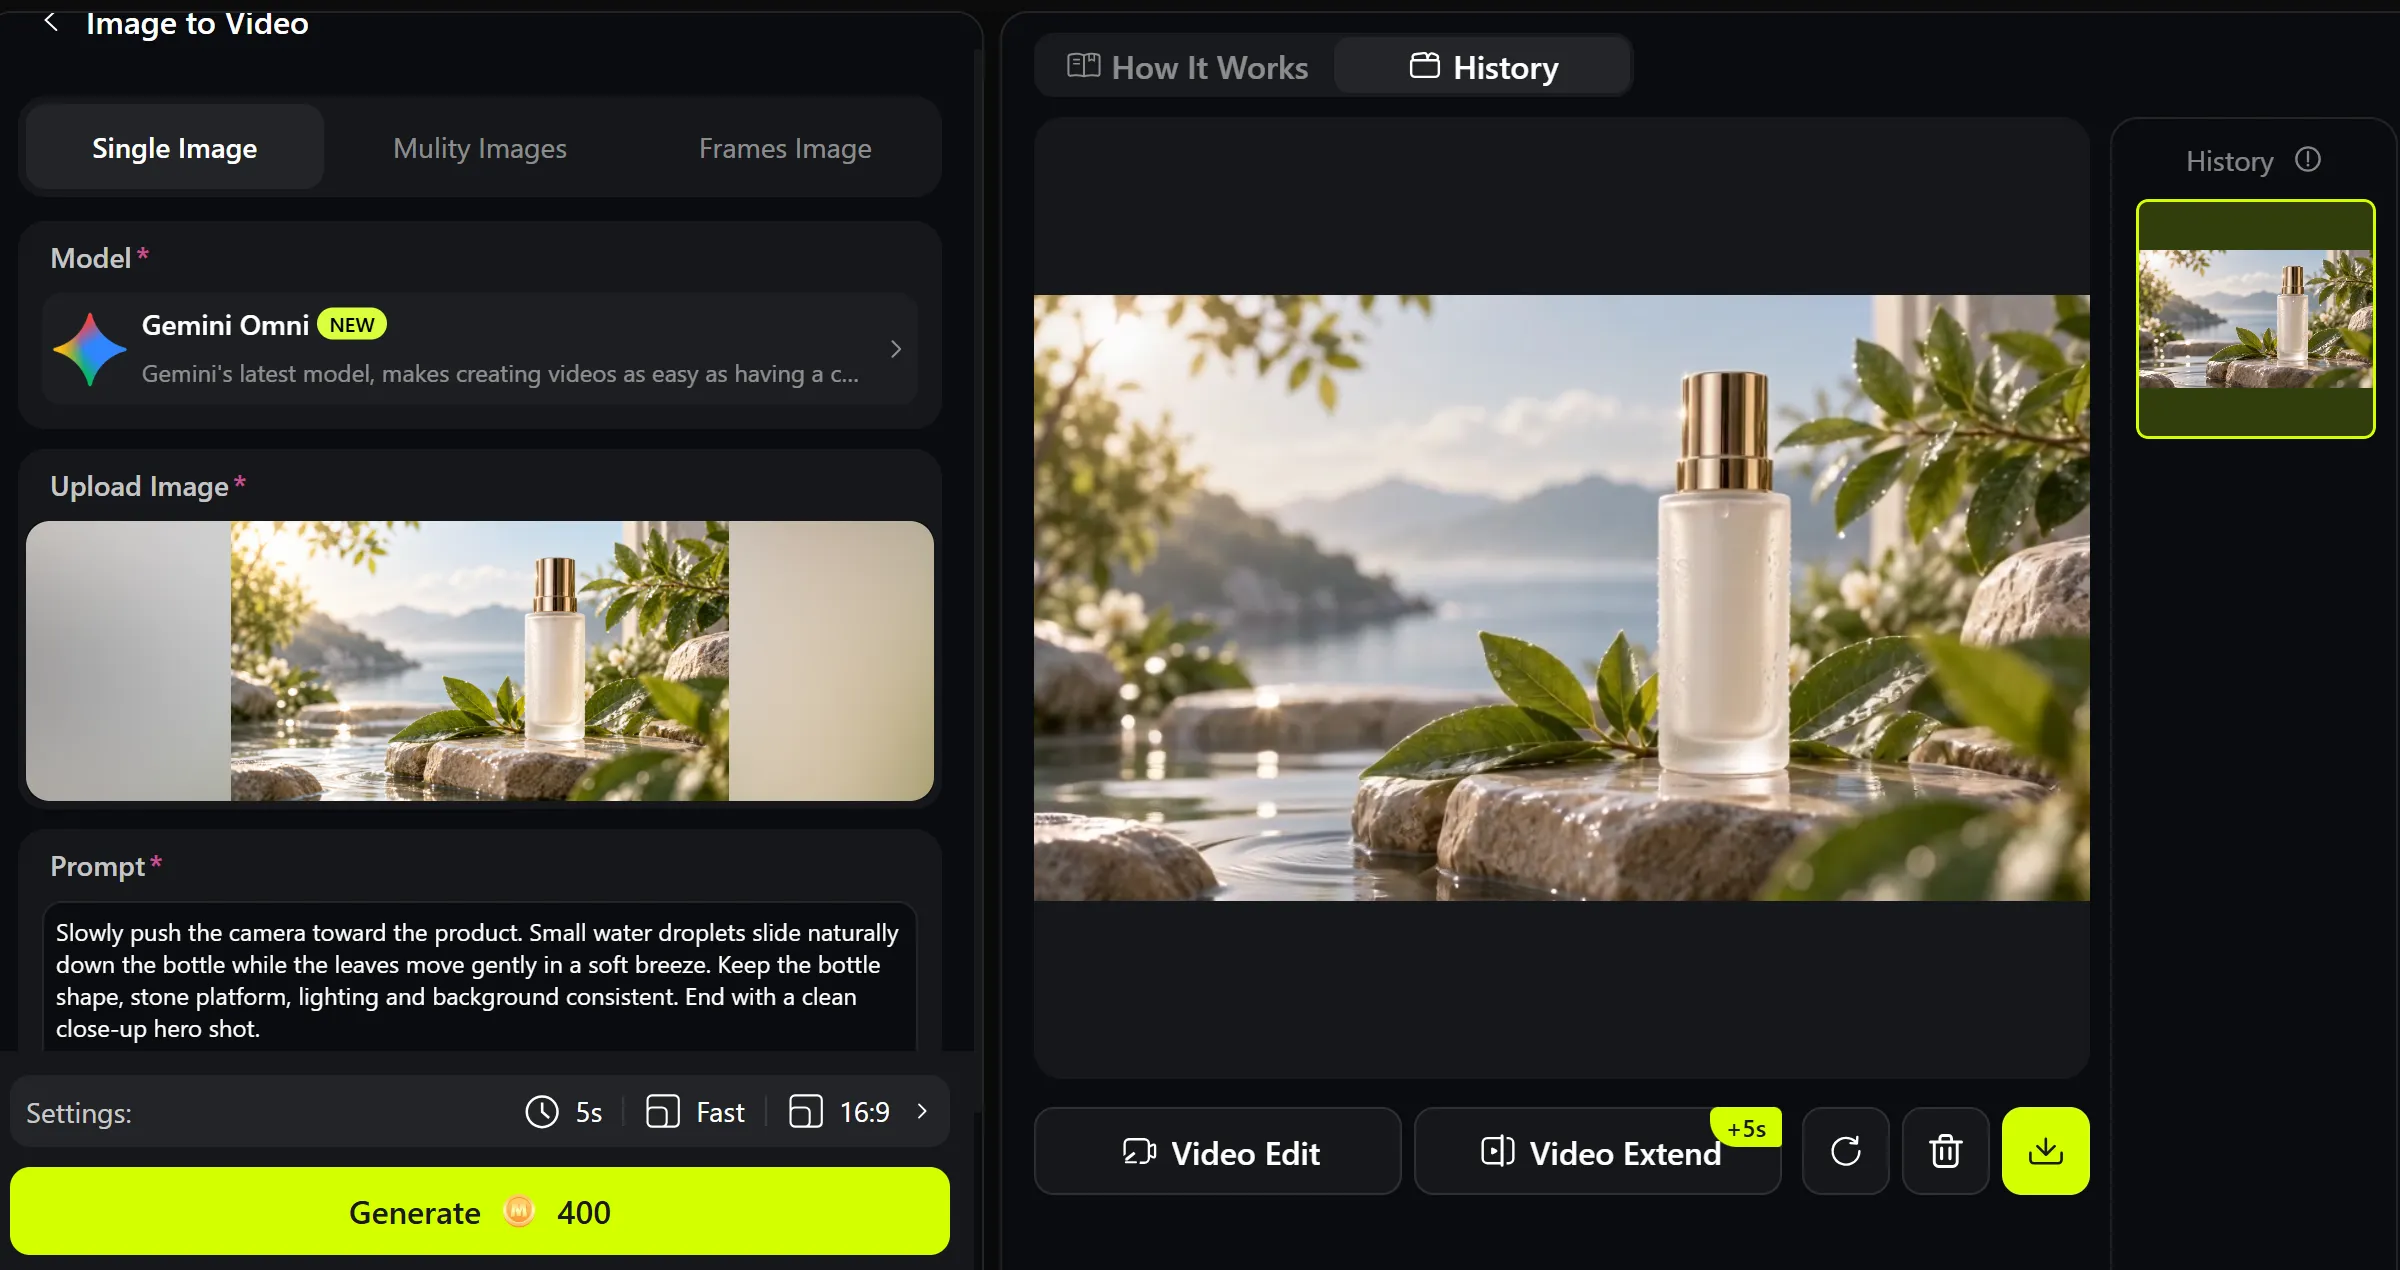
Passo 3: Refine o movimento, não todo o projeto
Suponha que o primeiro vídeo esteja bom, mas você não goste do movimento da câmera.
Não regenere a imagem.
Apenas altere:
Movimento lento de aproximação da câmera
para algo como:
Órbita lenta da câmera no sentido horário ao redor do produto
Ou talvez você queira manter a composição completamente fixa:
Mantenha a câmera fixa. Apenas as folhas e as gotas de água se movem.
Isso parece simples, mas muda a forma como você trabalha.
Em vez de reiniciar todo o projeto sempre que algo dá errado, você corrige apenas a etapa que realmente apresenta o problema.
Se o clipe gerado já estiver próximo do resultado desejado e precisar apenas de um ajuste visual, você também pode continuar com o Editor de Vídeo AI Gemini Omni, em vez de recriar tudo do zero.
O Google Já Está Mostrando Onde Esse Fluxo de Trabalho Faz Sentido
O Google criou várias demonstrações especificamente para mostrar como o Nano Banana 2 Lite e o Gemini Omni funcionam juntos.
Uma delas é o Anywhere. Você faz upload de uma selfie ou foto, o Nano Banana 2 Lite move a pessoa para diferentes locais e, depois de escolher uma imagem, o Gemini Omni a anima em um vídeo.
O fluxo de trabalho é basicamente:
Foto → Nova Cena → Clipe Animado
Essa é uma maneira muito prática de animar imagens geradas por IA, pois a decisão criativa acontece antes do início da animação.
Outra demonstração é o Space Lift. O Nano Banana 2 Lite primeiro redesenha um cômodo enviado por upload, e então o Gemini Omni transforma o conceito de interior escolhido em uma apresentação cinematográfica em movimento.
Em vez de pedir ao modelo de vídeo que redesenhe o cômodo enquanto simultaneamente move a câmera, você primeiro decide qual deve ser o novo aspecto do ambiente.
Depois, você o anima.
O terceiro exemplo do Google pode ser o mais útil comercialmente: o Omni Product Studio converte imagens estáticas de produtos do Nano Banana 2 Lite em vídeos para e-commerce usando o Gemini Omni.
Isso é essencialmente um fluxo de trabalho de vídeo de produto com IA:
Gerar imagem do produto → aprovar imagem do produto → animar imagem do produto → refinar o vídeo
Para profissionais de marketing e lojas online, isso é muito mais útil do que gerar cegamente uma tomada de produto completamente diferente a cada vez.
Vai Além da Conversão Básica de Imagem para Vídeo
O aspecto interessante do Omni é que este fluxo de trabalho não precisa parar em uma única imagem estática.
Se o seu projeto depende de referências visuais adicionais ou orientação de movimento, o Movmix também oferece um fluxo de trabalho Gemini Omni Referência para Vídeo.
Isso abre portas para um tipo diferente de criação:
um recurso pode mostrar ao modelo a aparência do sujeito, enquanto outro ajuda a comunicar como a cena deve se mover.
É aqui que o vídeo multimodal começa a se tornar muito mais útil do que a tradicional conversão de "faça upload de uma imagem e torça pelo melhor".
O Gemini Omni Flash Ainda Tem Limitações
Este ainda é um modelo novo, e o Google é bastante claro sobre as limitações atuais.
Gemini Omni Flash currently generates 10-second videos. Google also says uploaded audio references and scene extension are not yet supported through the Gemini API. Video references up to three seconds may be accepted by the API schema, but are not yet correctly processed by the model, and character consistency can still weaken during scene changes or larger panning movements.
Portanto, ainda não é possível:
“Fazer upload de qualquer coisa, criar um filme perfeito de dois minutos e ir para casa.”
Por enquanto, o caso de uso mais forte é muito mais focado:
build a strong first frame, give it a clear movement, generate a short clip, then refine.
E, honestamente, isso já é útil.
Por que isso é mais importante do que outro novo modelo de IA
A maior mudança aqui não é o fato de o Google ter mais um modelo de imagem e outro de vídeo.
É que a fronteira entre eles está desaparecendo.
A geração de imagens torna-se parte da geração de vídeos.
A edição de vídeo torna-se parte da geração.
As referências tornam-se parte dos prompts.
E, em vez de buscar um modelo mítico que faça absolutamente tudo com perfeição, os criadores podem usar diferentes ferramentas para cada etapa da mesma ideia.
Para um fluxo de trabalho prático, isso faz muito mais sentido.
Precisa de uma imagem totalmente nova? Comece com o Nano Banana 2 Lite Text to Image.
Já tem uma imagem que vale a pena manter? Refine-a.
Quando o primeiro quadro estiver pronto, envie-o para o Gemini Omni e diga à cena o que fazer a seguir.
O novo fluxo de trabalho do Google pode ser resumido em uma frase:
Crie primeiro o quadro que você realmente deseja. Depois, faça-o se mover.
Para a criação de vídeos com IA em 2026, essa pode ser uma mudança muito maior do que parece.