Google 最近發布了許多令人印象深刻的 AI 模型,但其最新 Gemini 更新中最有趣的部分可能並非單一模型。
而是工作流程。
Google 現在明確向創作者展示如何將 Nano Banana 2 Lite 與 Gemini Omni Flash 搭配使用:先生成或優化圖片,然後將該圖片輸入 Omni 並將其轉換為影片。
換句話說:
先搞定第一幀,再讓它動起來。
這聽起來似乎顯而易見,但它解決了 AI 影片製作中最大的問題之一:要求單一模型同時構思角色、構圖、環境、動作、攝影機運鏡以及最終鏡頭。
Google 將 Nano Banana 2 Lite 描述為其速度最快且最具成本效益的 Nano Banana 圖像模型,而 Gemini Omni Flash 則專為影片生成和對話式編輯而設計,支援結合文字、圖片和影片輸入。Google 特別建議將這兩個模型串接起來,以實現端到端的媒體工作流程。
而且由於 Movmix 上提供這兩種工作流程,您可以遵循相同的思路,無需不斷下載檔案或在不相干的工具之間來回切換。
首先,Google 到底發布了什麼?
這次更新包含兩個部分。
Nano Banana 2 Lite 專為快速圖片生成和編輯而打造。Google 表示,它可以在約四秒內產生 1K 解析度的文生圖結果,並針對高吞吐量、低延遲的工作流程進行了優化。
如果您從零開始,可以使用 Nano Banana 2 Lite 文生圖 來建立第一幀。
已經有照片或產品圖片了嗎?使用 Nano Banana 2 Lite 圖生圖 來更改場景、風格或構圖,無需從頭重建一切。
接下來是 Gemini Omni Flash。
Google 將 Omni Flash 定位為多模態影片生成和編輯模型。它支援對話式編輯、多模態參考、現實世界知識,以及文字、圖形和動作之間的同步。
但對日常創作者來說,最有用的部分更為簡單:
您可以提供已經喜歡的圖片,並將影片提示詞專注於接下來應該發生的事情。
真正的轉變:停止要求影片模型包辦一切
許多品質不佳的 AI 影片,問題往往始於糟糕的首幀畫面。
也許臉部細節有些微錯誤。
也許產品的角度不對。
也許房間的樣子與你想像的完全不同。
接著,我們撰寫更長的影片提示詞,指望影片模型在生成動畫的同時,能奇蹟般地修正所有問題。
這要求未免太高了。
更好的首幀轉影片工作流程會將任務分開處理。
圖像模型負責回答:
這個場景應該是什麼樣子?
影片模型負責回答:
接下來會發生什麼事?
一旦你採用這種思維方式,撰寫提示詞就會變得容易許多。
與其花費一半的影片提示詞篇幅,去描述已經清晰可見的瓶子、模特兒、房間或服裝,不如將這些字數用在描繪動作、時機點與鏡頭行為上。
這正是為什麼 Google 決定將 Nano Banana 2 Lite 與 Gemini Omni Flash 串接起來,其重要性遠勝過另一張基準測試圖表。
如何在 Movmix 上重現工作流程
讓我們以一個簡單的產品廣告為例。
您希望將一張護膚品圖片轉換成簡短的宣傳影片。
步驟 1:使用 Nano Banana 2 Lite 建立第一幀畫面
從圖片開始著手。
例如:
| 提示詞 | 圖片 |
|---|---|
| 高級護膚品瓶身置於光滑的石質平台上,旁邊有新鮮的綠葉,柔和的晨光,細微的水珠,乾淨自然的背景,優雅的產品攝影風格,16:9 比例,無文字,無標誌。 | 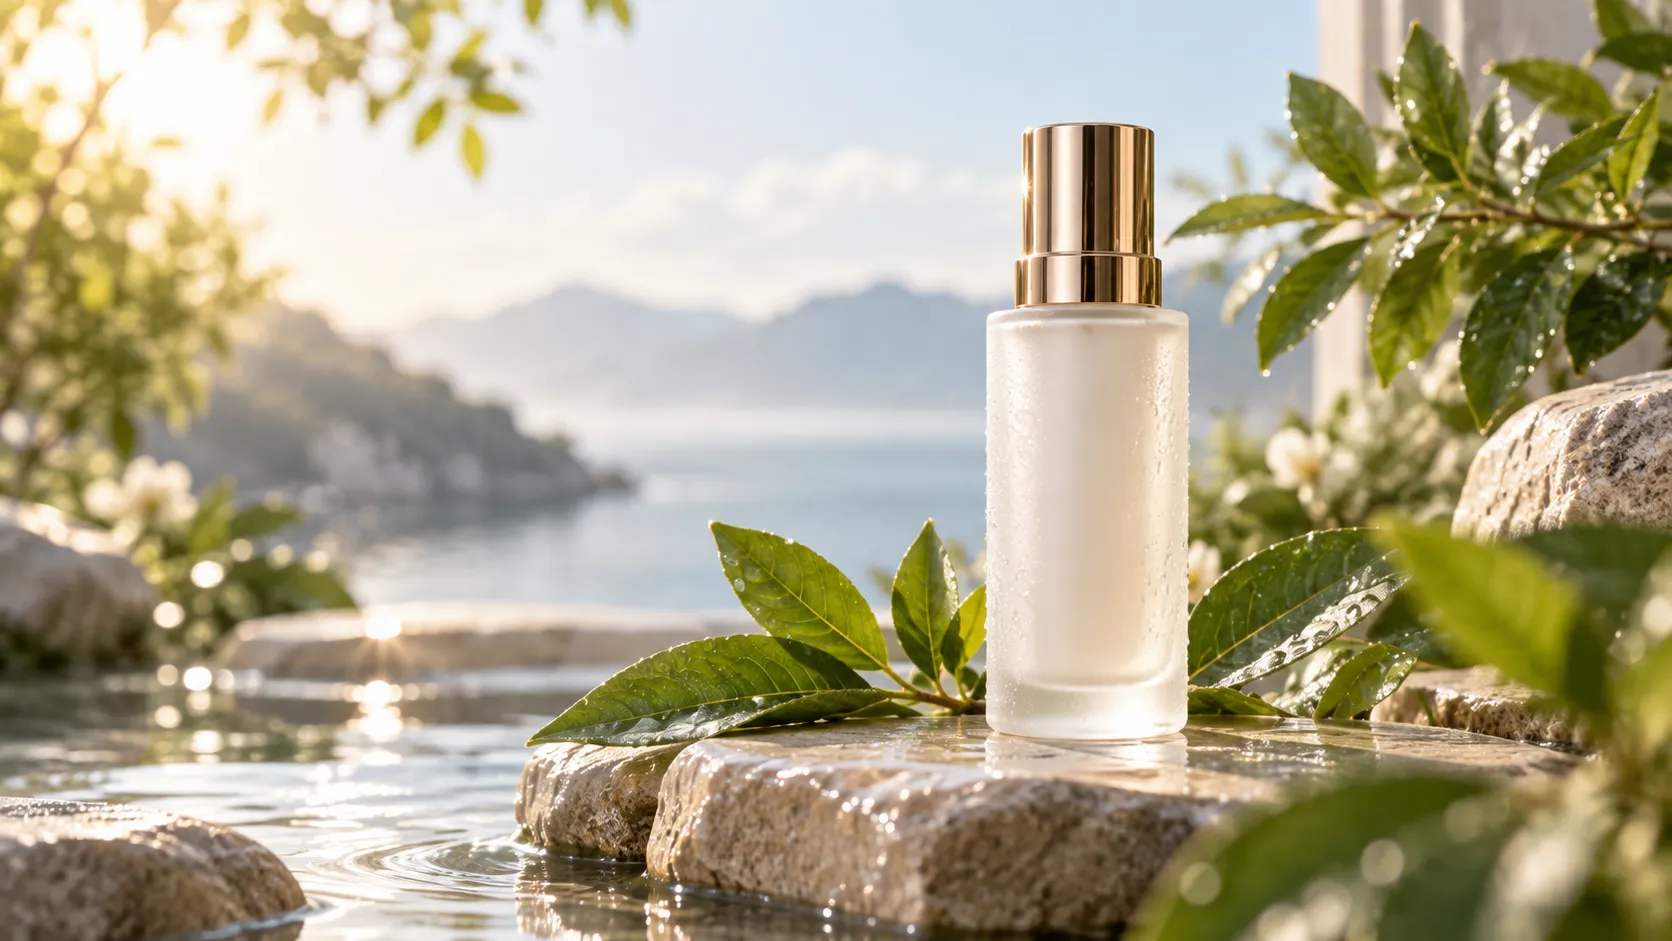 |
在這個階段,完全不需要考慮動態效果。
檢視結果並自問:瓶身形狀正確嗎?構圖良好嗎?我喜歡這樣的光線嗎?背景足夠乾淨嗎?
如果答案是否定的,請立即修正圖片。
這比在生成影片後才發現問題要容易得多。
步驟 2:使用 Gemini Omni 將圖片轉為影片
當首幀畫面符合要求後,將其上傳至 Gemini Omni 圖片轉影片工具。
現在,提示詞可以更加專注於:
注意到缺少了什麼嗎?
我們無需再次描述瓶子的外觀。
圖片已經完成了這項工作。
影片提示詞主要控制:
動作 → 鏡頭 → 一致性 → 結尾
這是一種更清晰的分工方式。
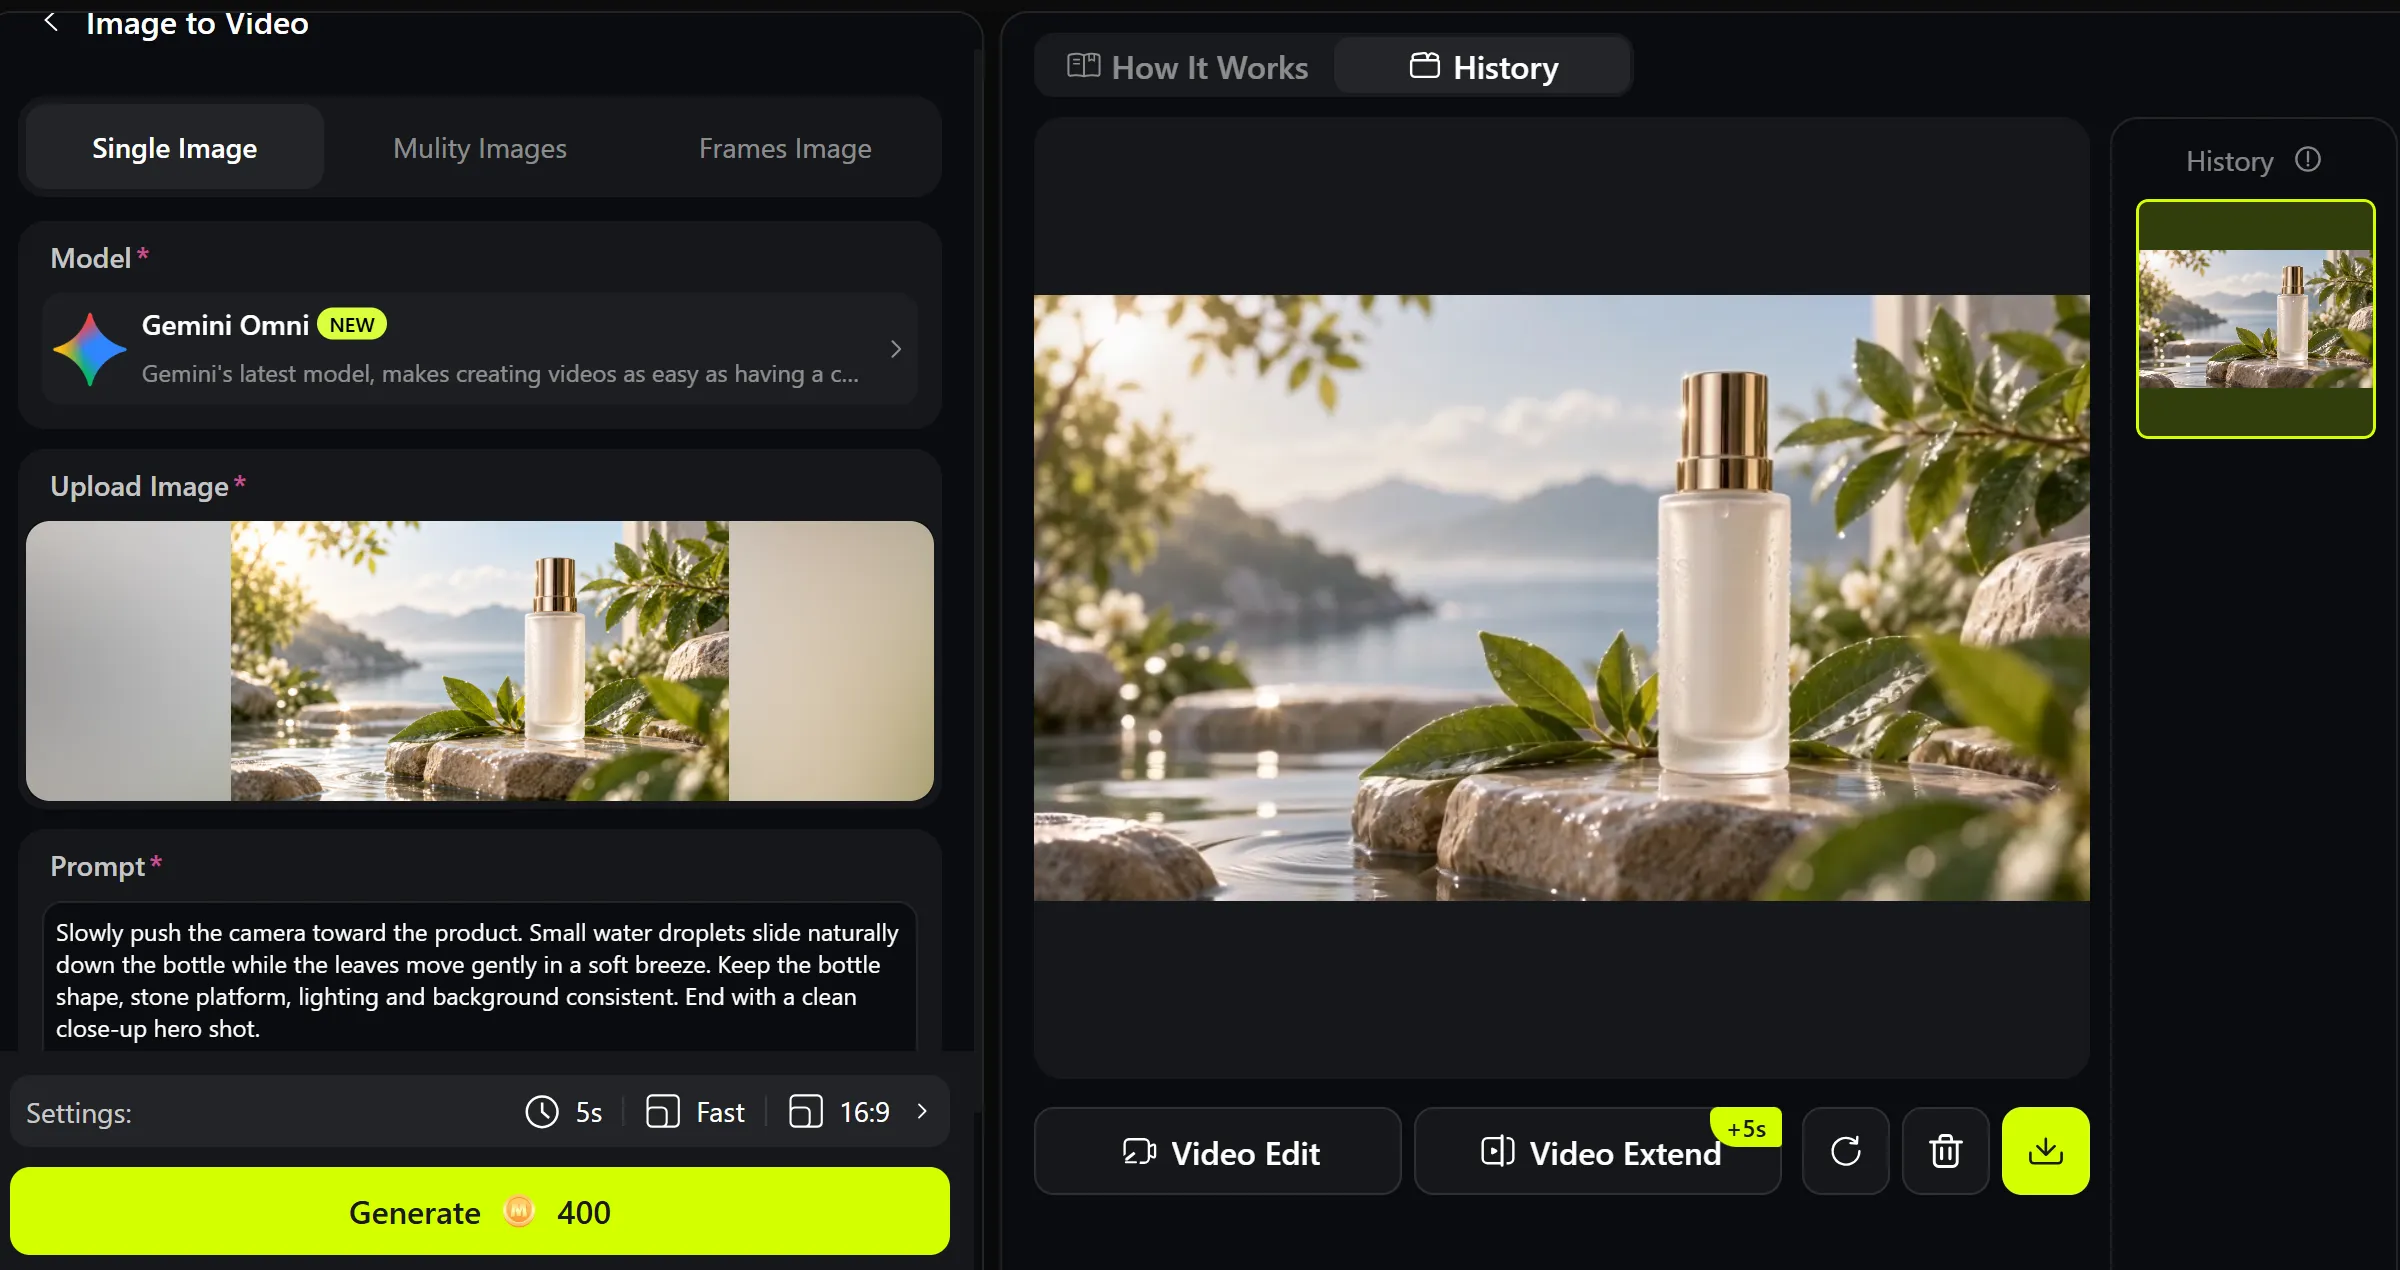
步驟 3:優化動作,而非重新製作整個專案
假設第一段影片看起來不錯,但你不喜歡鏡頭的移動方式。
不要重新生成圖片。
只需修改:
鏡頭緩慢推進
改為類似:
鏡頭圍繞產品緩慢順時針環繞
或者,你可能希望完全鎖定構圖:
保持攝影機固定。只有樹葉和水滴在移動。
這聽起來很簡單,但它會改變你的工作方式。
與其在出錯時重新開始整個專案,不如直接修復實際出現問題的階段。
如果生成的影片片段已經很接近成品,只需進行視覺調整,你可以继续使用 Gemini Omni AI 影片編輯器,而不必重新生成所有内容。
Google 已明確展示此工作流程的適用場景
Google 製作了多個示範案例,專門展示 Nano Banana 2 Lite 與 Gemini Omni 如何協同運作。
其中一個是 Anywhere。你上傳一張自拍或照片,Nano Banana 2 Lite 將人物移至不同場景,當你選擇一張圖片後,Gemini Omni 會將其動畫化為影片。
工作流程基本上是:
照片 → 新場景 → 動畫片段
這是一種非常實用的 AI 生成圖像動畫化 方法,因為創意決策是在動畫製作開始前完成的。
另一個示範案例是 Space Lift。Nano Banana 2 Lite 首先重新設計上傳的房間,然後 Gemini Omni 將選定的室內設計概念轉化為電影級的動態展示。
與其要求影片模型在移動攝影機的同時重新設計房間,不如先決定房間應該變成什麼樣子。
然後再將其動畫化。
Google 的第三個範例可能是最具商業價值的:Omni Product Studio 使用 Gemini Omni 將 Nano Banana 2 Lite 產生的靜態產品圖像轉換為電子商務影片。
這本質上是一個 AI 產品影片工作流程:
生成產品圖像 → 確認產品圖像 → 將產品圖像動畫化 → 優化影片
對於行銷人員和網路商店來說,這比每次都盲目生成完全不同的產品拍攝畫面要有用得多。
它不僅僅是基本的圖生視頻
Omni 的有趣之處在於,這個工作流程不必停留在單張靜態圖片上。
如果您的專案依賴額外的視覺參考或動作引導,Movmix 還提供 Gemini Omni 參考轉視頻 工作流程。
這為不同類型的創作打開了大門:
一個素材可以用來告訴模型主體的外觀,而另一個則有助於傳達鏡頭應如何移動。
這正是多模態視頻開始變得比傳統「上傳一張圖片並祈禱好結果」的圖生視頻更有用的地方。
Gemini Omni Flash 仍有其限制
這仍然是一個新模型,Google 也明確指出了當前的限制。
Gemini Omni Flash 目前生成 10 秒長的視頻。Google 也表示,Gemini API 尚不支持上傳音頻參考和場景擴展。API 架構可能接受長達三秒的視頻參考,但模型尚未能正確處理它們,且在場景切換或較大平移運動期間,角色一致性仍可能減弱。
所以這還不是:
「上傳任何內容,製作一部完美的兩分鐘電影,然後回家。」
目前,最強大的用例更加專注於:
構建一個強有力的首幀,賦予其清晰的動作,生成短片段,然後進行精修。
老實說,這已經很有用了。
為何這比推出新的 AI 模型更重要
這裡最大的變化,並非 Google 又推出了另一個圖像或影片模型。
而是兩者之間的界線正在逐漸消失。
圖像生成已成為影片生成的一部分。
影片剪輯也融入了生成過程之中。
參考素材成為提示詞的一部分。
創作者不再需要尋找一個能完美處理所有任務的萬能模型,而是可以針對同一個構想的不同階段,使用不同的工具。
就實際工作流程而言,這種方式更為合理。
需要全新的圖像?從 Nano Banana 2 Lite 文字轉圖像 開始。
如果已經有值得保留的圖像,那就進一步優化它。
當第一幀準備就緒後,將其輸入 Gemini Omni,並指示場景後續的發展。
Google 的新工作流程可以簡化為一句話:
先創造出你真正想要的畫面,再讓它動起來。
對於 2026 年的 AI 影片創作而言,這可能是一個比聽起來更為重大的轉變。