複数のモデルを搭載したAI動画プラットフォームを開く際、最も難しいのはプロンプトの作成ではありません。
重要なのは、次の判断を下すことです。
「この動画には実際にどのモデルを使えばよいのか?」
Wan、Seedance、Klingはすべて動画を生成できますが、それらが全く同じ方法で使用されるべきだという意味ではありません。
製品のコマーシャルとファッション系のReelでは、直面する課題が異なります。ストーリー重視のシーンでは、シンプルな画像から動画への変換クリップとは異なる制御が必要です。会話、複数のキャラクター、参照モーション、複雑な相互作用などが登場すると、モデルの選択がさらに重要になります。
したがって、さまざまなユースケースに適したAI動画モデルを選ぶ際には、どのモデルが最も強力かという点から始めないでください。
より適切な質問から始めましょう。
作成しようとしている動画で、最も難しい部分はどこか?
Movmixでは、GPT Image 2.5、Nano Banana、Grok Image、Seedreamなどの画像モデルを使用して強力な最初のフレームを事前に準備し、その後、動画生成ステージに進むことができます。
実用的なワークフローは以下のようになります。
画像の準備 → 動画モデルの選択 → モーションとカメラワークの指示 → 生成 → 実際の問題を修正
Movmix AI Video Generatorから始め、モデル名ではなくシナリオに基づいてモデルを選択しましょう。
クイックガイド:あなたのシナリオに最適なAI動画モデルは?
| 動画のシナリオ | 最初に試すべきモデル | 最も重要なポイント |
|---|---|---|
| 単一の画像を自然にアニメーション化 | Wan / Kling | シンプルなモーション、最初のフレームの一貫性 |
| 製品広告 | Wan | 製品構造、カメラ、ライティング |
| ファッション、リール、キャラクター映像 | Kling / Wan | 顔、服装、身体の動き |
| 参照動画からのモーション転送 | Kling / Seedance / Wan | キャラクターのアイデンティティと参照モーション |
| マルチショットによるストーリーテリング | Seedance | タイミング、ショット展開、一貫性 |
| 複数キャラクターの対話 | Kling / Seedance | 話者の順序、音声、タイミング |
| 複雑なアクションまたは複数名の登場 | Seedance / Kling | 動作の関係性、物理的な整合性 |
| 複数参照を活用したクリエイティブワークフロー | Seedance | 画像、動画、音声参照の明確な役割分担 |
これは絶対的なランキングではありません。
同じシーンは、複数のモデルで作成できることがよくあります。重要な問題は、タスクのどの部分をモデルに最も上手に処理させるかです。
シナリオ1:画像が1枚あり、それを自然に動かしたい場合
これは最も一般的な画像から動画へのユースケースです。
たとえば、ポートレート写真で人物をカメラの方に向かせたいだけの場合や、ペットに頭を持ち上げさせたい場合、あるいは都市の写真に人々、木々、光の微妙な動きを加えたい場合などが考えられます。
複雑なストーリーは必要ありません。
WanまたはKlingを試す
この種のタスクにおいて、重要な構成要素は以下の通りです:
1つの被写体 + 1つの主要アクション + 1つのシンプルなカメラ移動
参照画像は、人物、製品、または環境の外観をすでにモデルに伝えています。
動画のプロンプトは、以下に焦点を当てるべきです:
次に何が起こるか?
例:
このセクションでは完全なデモ動画を作成する必要はありません。原則そのもののほうが役立ちます:
動画プロンプトで、画像にすでに示されている内容をすべて繰り返さないようにしてください。
シナリオ2:商品広告が必要で、商品の外観を変えてはいけない場合
香水、ヘッドフォン、スキンケア製品、靴、家電、飲料など。主な課題は通常、商品をどう動かすかではありません。
重要なのは、商品の変化を防ぐことです。
4秒後にボトルのキャップの形状が変わったり、ヘッドフォンが突然デザイン変更されたりすると、動画は見栄えがよくても、広告としては役立ちません。
まずWanを試す
この種のワークフローでは、以下のルールが役立ちます。
商品は静止させ、カメラ、照明、反射を動かす。
完全ワークフロー1:プレミアムヘッドフォンのCM
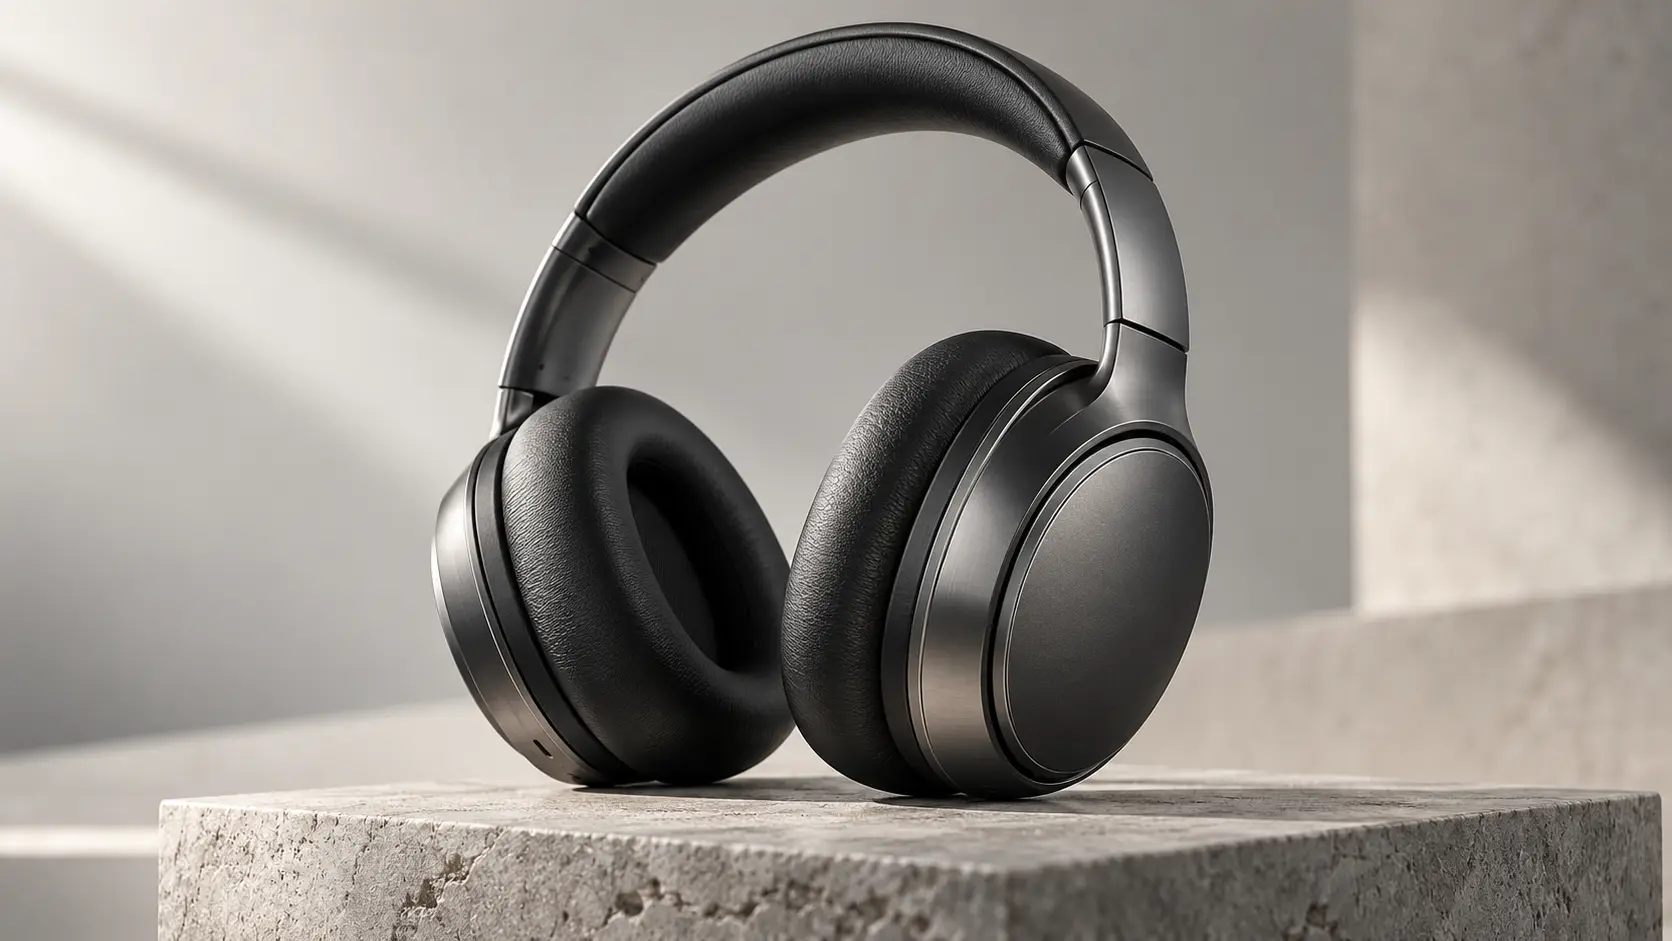
ステップ1:最初のフレームを準備する
すでに優れた商品画像がある場合は、それを直接使用してください。
ない場合は、まずMovmixの画像生成モデルのいずれかを使用して、インパクトのある商業スタイルの画像を作成します。
| 初期フレーム画像のプロンプト | 出力画像 |
|---|---|
| 淡いグレーの天然石のディスプレイ台の中央に置かれた高級オーバーイヤーワイヤレスヘッドフォン。ダークグレーのメタルフレームと柔らかいレザーのイヤーパッドがはっきりと見え、ミニマルでモダンなスタジオ背景、素材感を強調する柔らかなサイドライト、リアルな商業製品写真、ローアングルのクローズアップ、クリーンな構図、16:9、テキストなし、ロゴなし、ウォーターマークなし。 |
 |
ステップ2:画像をアップロードし、Wanを選択する
Movmix Image to Videoを開き、商品画像をアップロードして、利用可能なWan動画モデルを選択します。
ステップ3:実際に必要な動きのみを設計する
動画プロンプト:
ステップ4:プロンプト全体ではなく、問題点のみを修正する
製品の形状が変化してしまう場合は、製品の動きを減らし、カメラや照明の方に動きを持たせてください。
カメラの動きが速すぎる場合は、カメラスピードのみを変更してください。
背景が絶えず動いてしまう場合は、モデルに対して背景を完全に安定させるよう明示的に指示してください。
これは、生成が失敗するたびにプロンプト全体を書き直すよりも有用です。
シナリオ3:ファッション、リール、またはキャラクター重視のソーシャルメディア動画を作成したい場合
キャラクター動画では、全く異なる失敗モードが発生します。
製品の場合、形状の変化を懸念します。
人物の場合、以下のような点を懸念します。
最初の数秒に登場した人物が、動画の終わりには別人のように見えてしまう。
Kling または Wan を試す
ファッション、ライフスタイル、仮想キャラクター、ソーシャルメディア向けクリップの場合は、次の3点に焦点を当ててください。
アイデンティティの一貫性 + シンプルなアクション + 明確なカメラ移動
例:
アクションがシンプルであれば、Wan と Kling の両方がテストに適した選択肢となります。
ショットに複雑な身体表現、カメラ追従、または複数の参照アセットが含まれるようになる場合は、Kling のテスト検討価値が高まります。
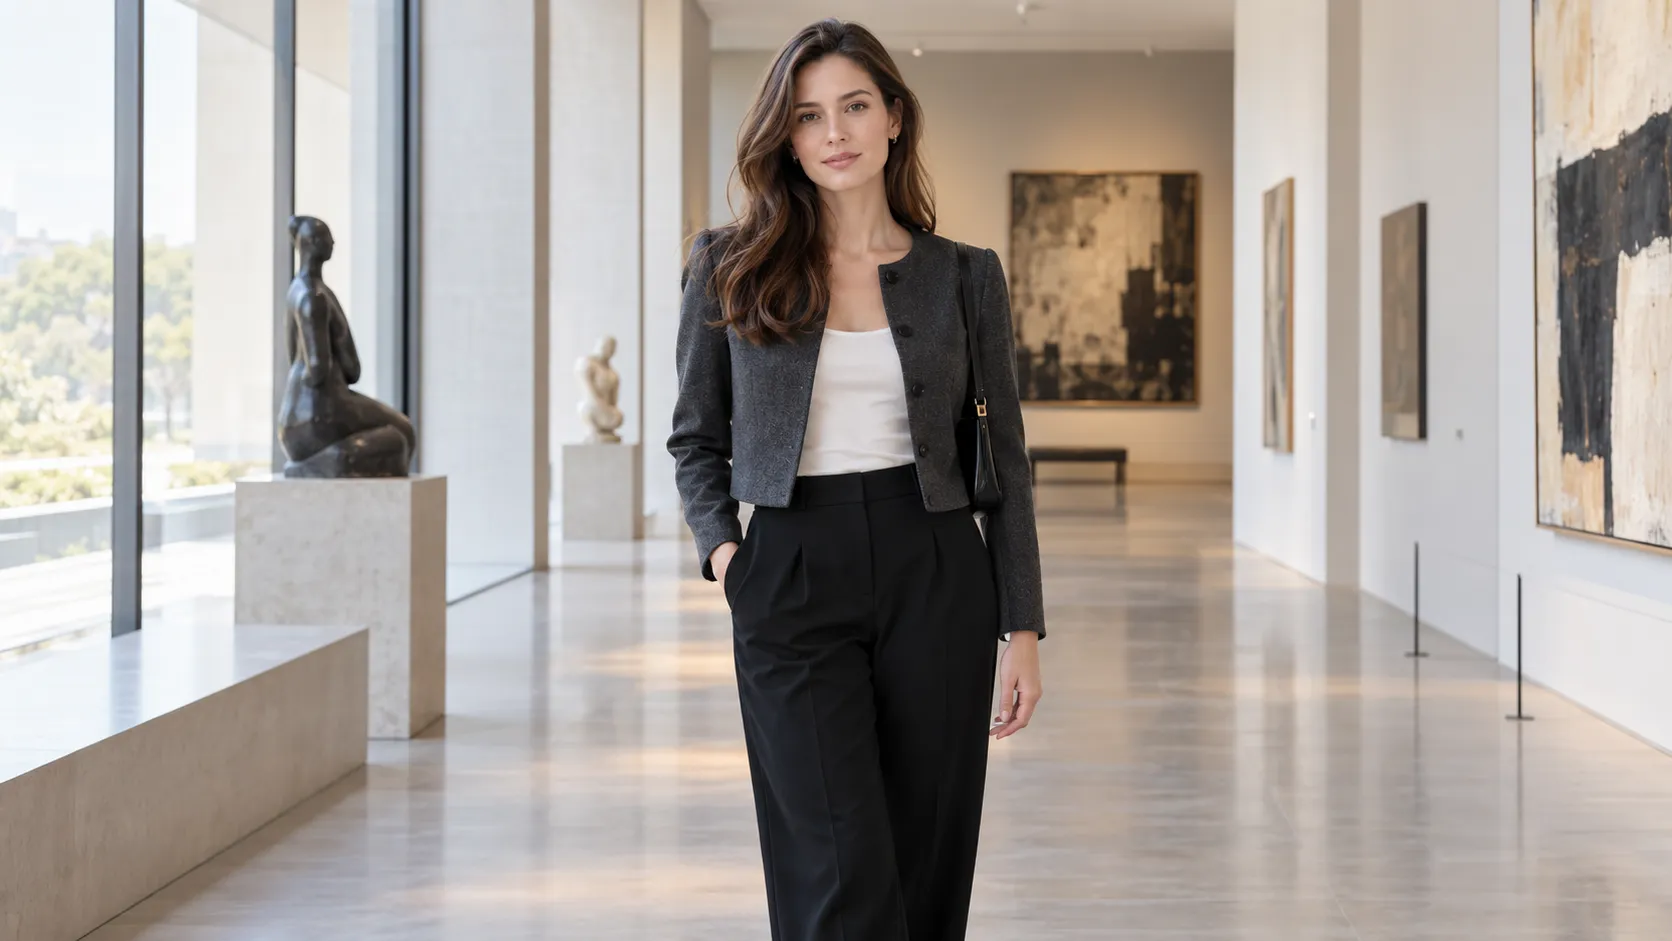
| 画像プロンプト | |
|---|---|
| モダンなアートギャラリーの廊下に立つヨーロッパ人女性の16:9横長画像。洗練されたダークグレーのショートジャケット、白いトップス、黒いパンツを着用し、自然に前へ歩き出す準備をしている様子。顔のディテールは鮮明で、背景には現代的な建築のラインが見え、柔らかな自然光が差し込む。リアルで高級感のあるファッション写真、ミディアム〜フルボディの構図。テキスト、ロゴ、ウォーターマークなし。 |
 |
シナリオ4:キャラクター画像があり、別の動画からモーションをコピーしたい場合
これは単なる一般的な画像から動画への生成ではありません。
You now have two different references doing two different jobs.
画像が答えるのは:
「誰」が演じるか?
動画が答えるのは:
「どのように」動くか?
例えば、ある人物のポートレート写真と、スポーツ、ダンス、またはパフォーマンスの別動画があるとします。画像内の人物に、その動画のモーションを演じさせたい場合です。
Kling、Seedance、またはWanの参照ワークフローを試す
このシナリオにおける最も重要なルールは以下の通りです:
参照画像 = 「誰」参照動画 = 「どのように」
モデルに対して、ただ漠然とこう指示してはいけません:
「参照と同じようにして」
各参照素材が何を制御するのかを、正確に指示してください。
ワークフロー全体2:バスケットボールの動きを別のキャラクターに転送
次のような状況があるとします。
画像A:成人男性キャラクター
動画B:速いドリブルとターン動作を行うアスリート
目標は、動画Bのアスリートを再生成することではありません。
目標は、画像Aのキャラクターに動画Bの動きを行わせることです。
動画プロンプト
これは作成する価値のある動画デモの一つです。その結果は、テキストだけでは説明できないことを即座に示してくれます。
一つの参照がアイデンティティを制御し、もう一つが動きを制御します。
シナリオ5:単一のアクションではなく、小さなストーリーを求めている場合
あなたのリクエストが以下のように聞こえ始めたら:
キャラクターがAを行い、次にBが起こり、その後Cに気づき、最後に反応する。
あなたはもはや単純な動きのクリップを作成しているわけではありません。
あなたはストーリーを作成しています。
Seedance を試す
この種のコンテンツでは、プロンプトは単なる視覚的形容詞の羅列にならないようにする必要があります。
一連の流れを記述すべきです:
最初に何が起こるか → 何が変化するか → カメラがどう追従するか → シーンがどこで終わるか
完全ワークフロー 3: 天文台での予期せぬ発見
ステップ 1: 最初のフレームを作成
| 画像プロンプト | 出力 |
|---|---|
| 静かな山頂の天文台内に立つ35歳の男性天文学研究者。濃紺のニットセーターとダークカラーのズボンを着用し、大型望遠鏡の傍らで観測データを記録している。机にはノートとシンプルな科学機器が置かれ、天文台ドームの開口部からは晴れた夜空が見える。リアルなドキュメンタリー写真風、ミディアムショット、落ち着いた自然な室内照明、アスペクト比16:9。 |
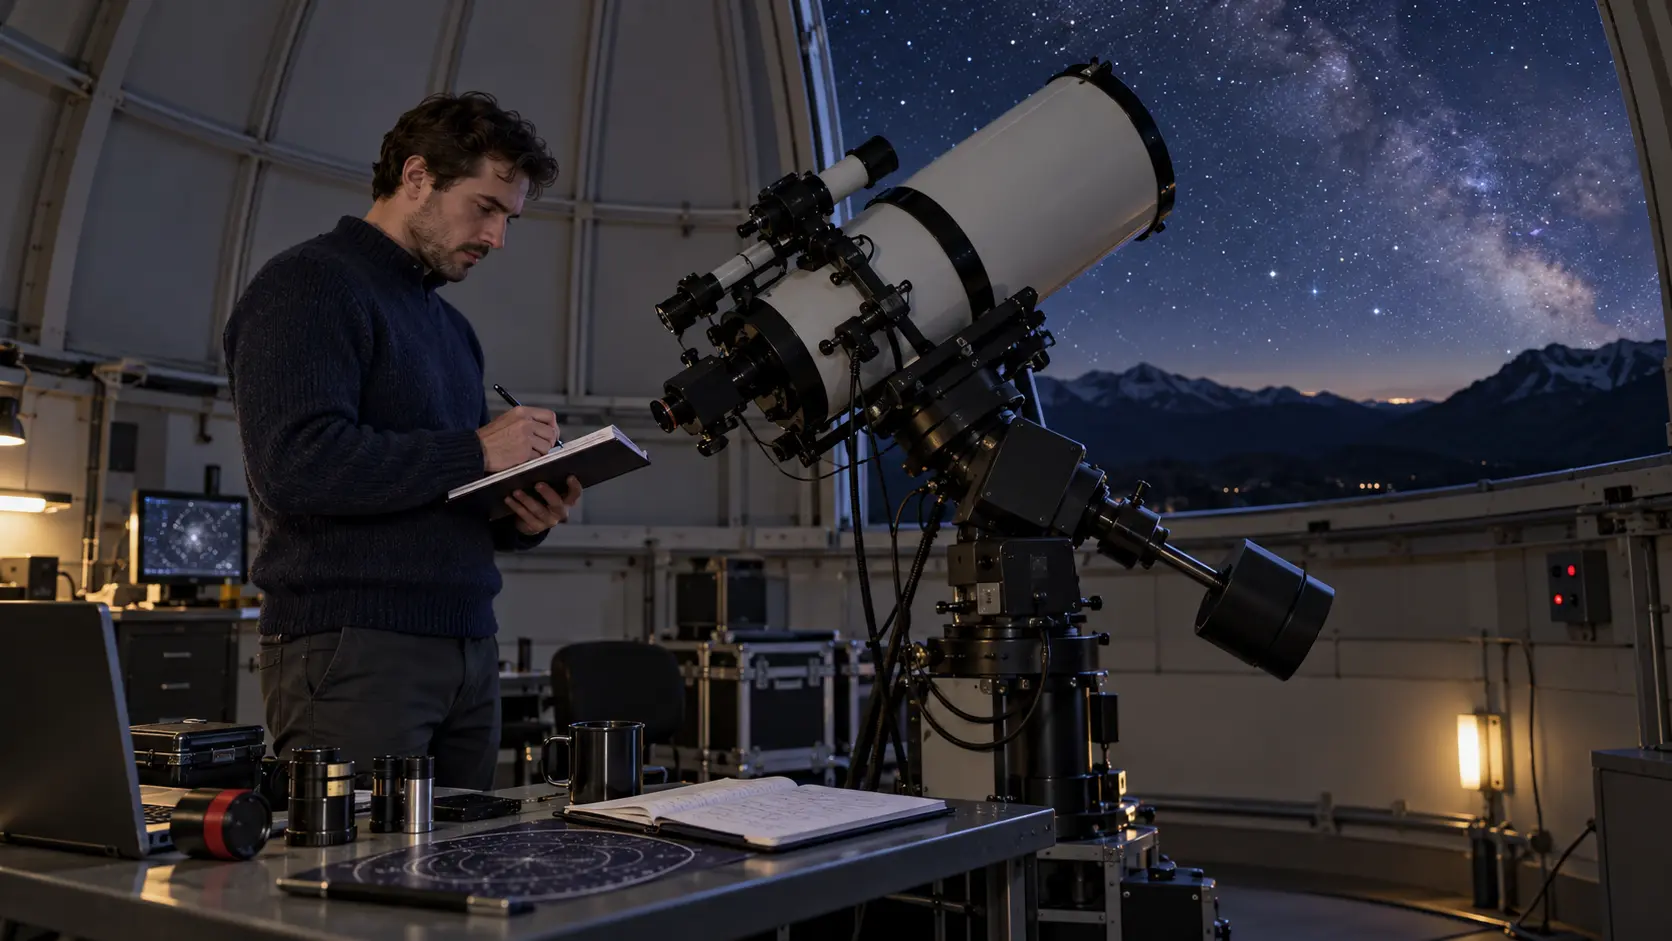 |
ステップ 2: Seedance を選択
今回は、単一の動きだけでなく、より多くの要素が必要です。
「出来事」が必要です。
動画プロンプト
ここで重要な教訓は、プロンプトそのものではありません。
プロジェクトが「モーション(動き)」から「ストーリーテリング(物語性)」へ移行した瞬間を見極めることです。
シナリオ6:2人以上のキャラクターが会話する
セリフがシーンに加わると、選択基準は再び変化します。
ここでモデルは、魅力的なビジュアル以上の要素を管理する必要があります。
具体的には以下の要素も管理します:
キャラクターの識別、発言順、音声、タイミング、口パクの動き
Kling または Seedance を試してみてください
単に以下のように書かないでください:
2人のデザイナーがプロジェクトについて話し合う。
これでは、ほとんどすべての要素が未定義のままです。
より良い構成例は以下の通りです:
キャラクターAが発言 → キャラクターBが反応 → キャラクターBが返答 → カメラアングル変更 → 環境は安定したまま
セリフが重要になると、音声はオプションではなく、シーンのロジックの一部となります。
サイトで紹介したい主な機能の一つがセリフでない限り、ここで別途デモ動画を作成する必要はありません。
Scenario 7: Complex Action, Sports, Performance, or Multiple People
これらのシーンでは、AI動画モデルは通常、より厳しいテストに直面します。
例としては、2人で行うスポーツ、協調されたパフォーマンス、複数のキャラクターが同時に動く場面、物理的な相互作用、あるいは複数の被写体の周りを移動するカメラなどがあります。
SeedanceまたはKlingを試す
ここで得られる主な教訓は驚くほどシンプルです。
複雑さを解決するために、長い文章を1つ書くのはやめましょう。
関係性を分解しましょう。
代わりに:
カメラが映画的に動く中、2人が激しいアクションを行います。
定義する:
キャラクターAはここから開始。キャラクターBはそこから開始。キャラクターAが先に動く。キャラクターBが反応する。この時点で両者が相互作用。カメラはこの位置に配置。
動きが複雑になればなるほど、誰が何をするかを説明することが重要になります。
これは、「ダイナミック」「壮大」「ハイエネルギー」などの余計な言葉を加えるよりも、はるかに有用です。
シナリオ8:すでに画像、動画、音声、ストーリーボードを持っている場合
有时问题不在于缺乏素材。
問題なのは、素材が多すぎることです。
すでに以下を持っているかもしれません。
- キャラクター画像
- 環境参照資料
- モーション動画
- 音楽
- 効果音
- ストーリーボード画像
ここで重要になるのは参照素材の管理です。
Seedance を試す
重要なのは、できるだけ多くの素材をアップロードすることではありません。
重要なのは、各参照素材に明確な役割を与えることです。
例えば:
画像Aはキャラクターを制御します。画像Bは環境を制御します。動画Cはカメラの動きを制御します。音声Dはサウンドスタイルを制御します。
各参照素材の役割を明確に決めていないと、モデルは推測せざるを得なくなります。
モデルが推測を始めると、参照素材を増やしても制御性が向上するどころか、ワークフローがかえって不明確になってしまう可能性があります。
では、どのAI動画モデルを選ぶべきでしょうか?
次のような問いから始めるのは避けましょう:
「Wan、Seedance、Kling の中でどれが最強か?」
代わりに、より実用的な3つの質問を投げかけてみましょう。
すでに持っている素材は何ですか?
テキストのみですか? 画像1枚ですか? それとも画像、参照動画、音声もありますか?
この動画制作で最も難しい部分はどこですか?
製品の一貫性? キャラクターの同一性? 動き? ストーリーテリング? 対話? 複数キャラクターの相互作用?
絶対に失敗してはいけない部分はどこですか?
顔? 製品の構造? 動き? シーンの連続性?
これらの質問は、一般的なAI動画モデルの比較よりもはるかに多くの示唆を与えてくれます。
製品画像をクリーンなCM風のショットに変換するだけであれば、複雑なマルチショットのストーリーから始める必要はおそらくありません。
あるキャラクターに別の動画の動きをさせたい場合、通常の画像から動画へのワークフローでは不十分です。
そして、スクリプトが以下のような言葉で埋め尽くされ始めたら:
「その後」、「次に」、「突然」、「最後に」…
もはや、あなたは単なる短いクリップを作っているだけではないでしょう。
あなたが作っているのは、ストーリーです。
モデルの選択は、タスクに応じて変えるべきです。
最終ルール:まず動画を選び、その後でモデルを選ぶ
Movmixで複数のモデルを利用できる価値は、単にクリックできるボタンが増えたことではありません。
真の価値は、異なるタスクに対して異なるワークフローを活用できる点にあります。
GPT Image 2.5、Nano Banana、Grok Image、Seedreamなどの画像生成モデルを使用して、実際に目指すビジュアルの起点を用意しましょう。
次に、そのシーンで次に何を起こす必要があるかに基づいて、Wan、Seedance、Kling、または他の利用可能な動画モデルを選択します。
画像が決定するのは:
どのような見た目か?
動画モデルが決定するのは:
次に何が起こるか?
そして、あなたのプロンプトが決定するのは:
どのようにしてそれを実現するか?
したがって、次にどのAI動画モデルを選べばよいかわからないときは、いったんモデル名を忘れてください。
まず、実際に作りたい動画について説明しましょう。
そうすれば、適切なモデルの選択がずっと簡単になります。


