

モデル*
Movmix 4.0
最大300秒、より豊かなストーリーライン、そして強力な参照ベースの生成機能。

クリックまたはドラッグして画像をアップロードしてください
画像、動画、音声の参照から動画を作成
プロンプトだけでは不十分な場合は、AIリファレンス・トゥ・ビデオジェネレーターを使用して、画像、クリップ、またはオーディオでキャラクター、動き、スタイルをガイドします。
リファレンス動画AIでキャラクターやアセットに命を吹き込む
リファレンス・トゥ・ビデオ AIは、静止したキャラクター設定資料、商品写真、スタイルのリファレンスを、滑らかで映画的な動画に変換します。単一フレームをアニメーション化するだけの標準的な画像から動画への変換ツールとは異なり、完全に新しいカメラアングル、モーション、環境全体で一貫して顔の識別情報、衣装、オブジェクトの詳細を抽出し固定します。
静止リファレンスから映画的なモーションへ
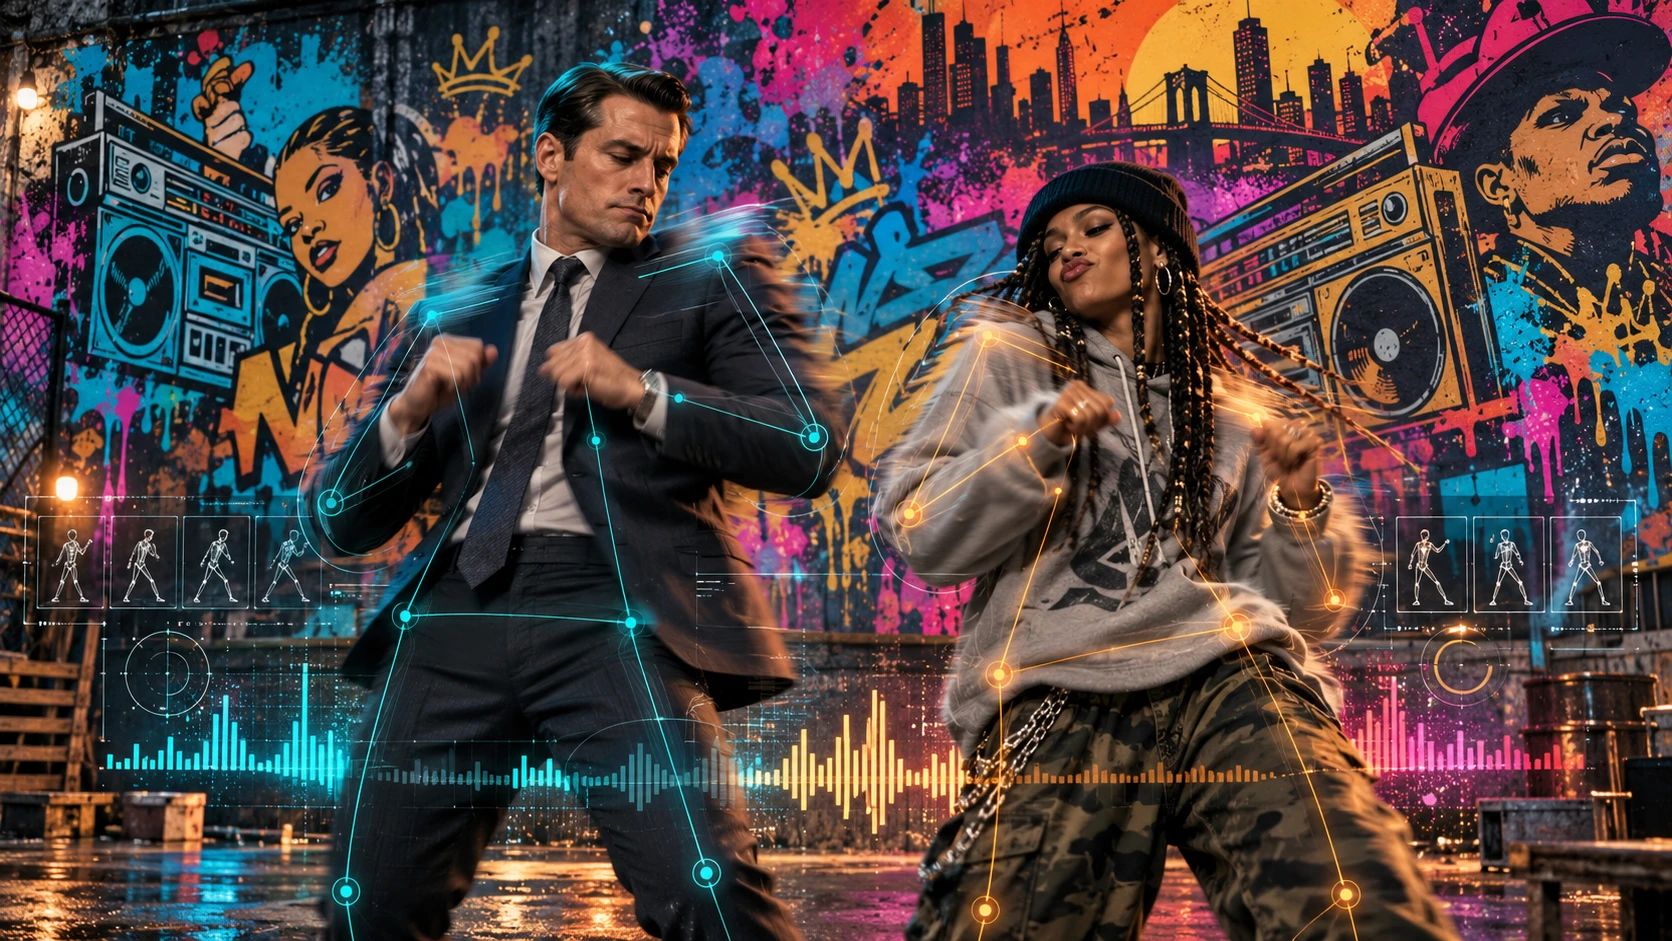
単一フレームのアニメーションに留まりません。キャラクターのポートレート、商品ショット、シーンのリファレンスをMovmixに入力すると、AIが核となる視覚的アイデンティティを抽出し、歪みゼロで全く新しいカメラアングル、アクション、複数の被写体間のインタラクションを生成します。
リファレンス画像 · 被写体融合 · AI動画結果
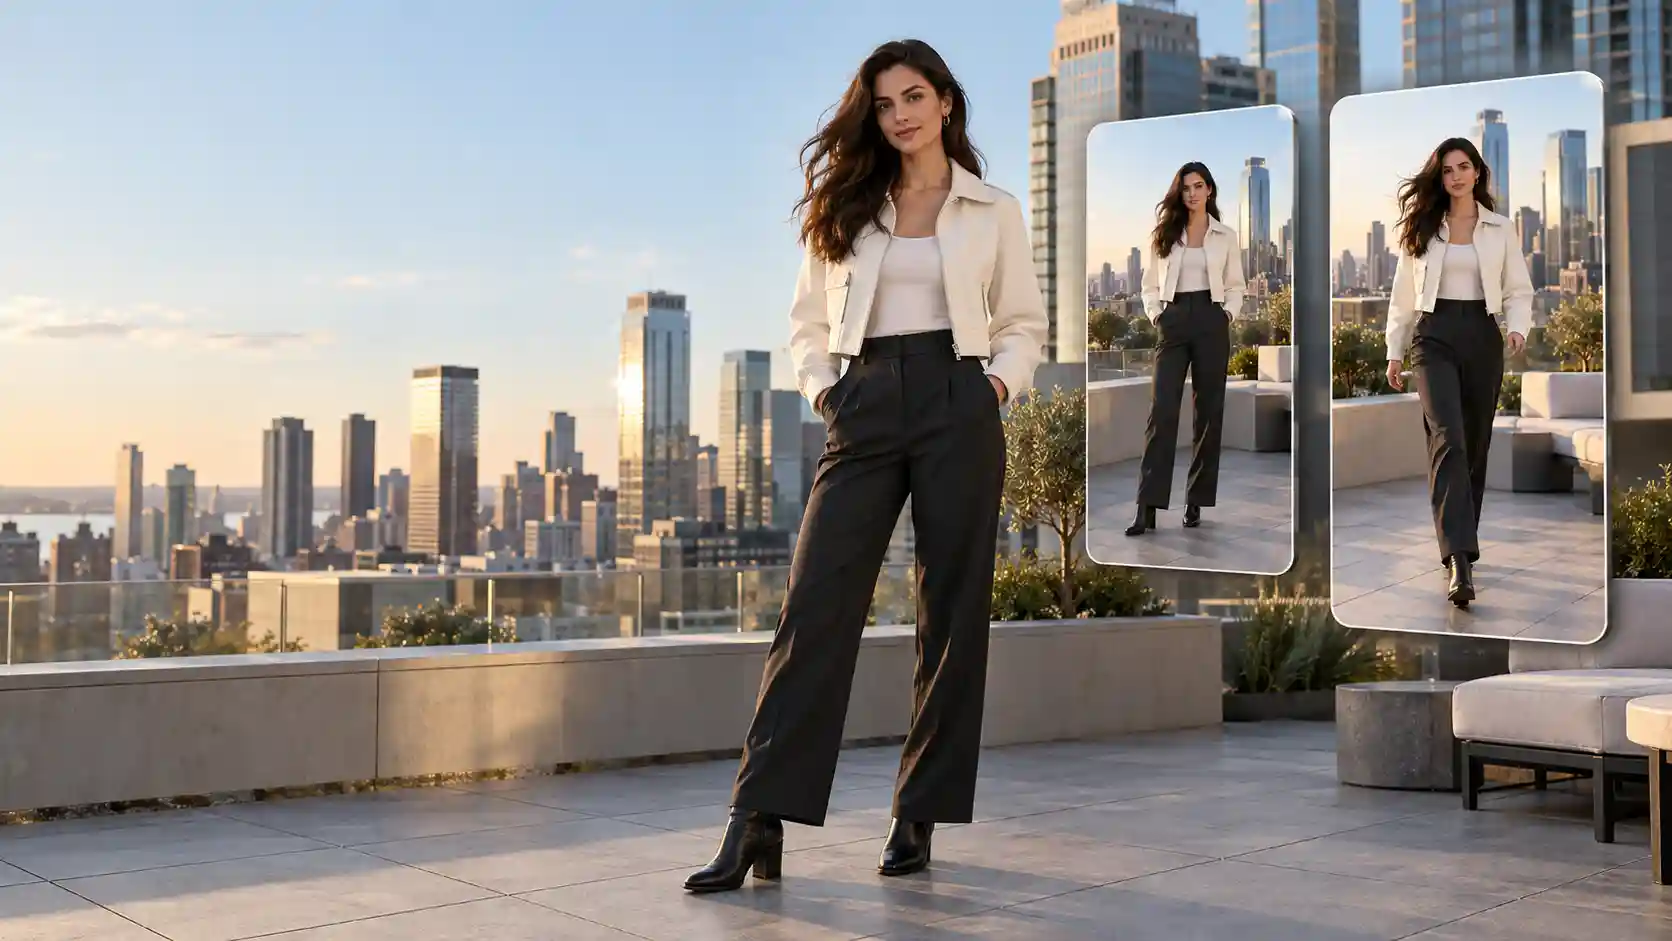
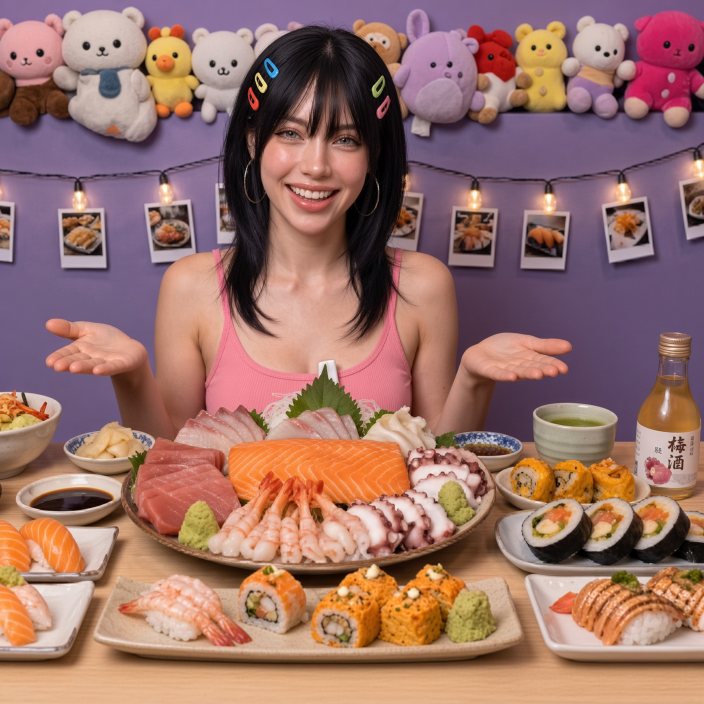
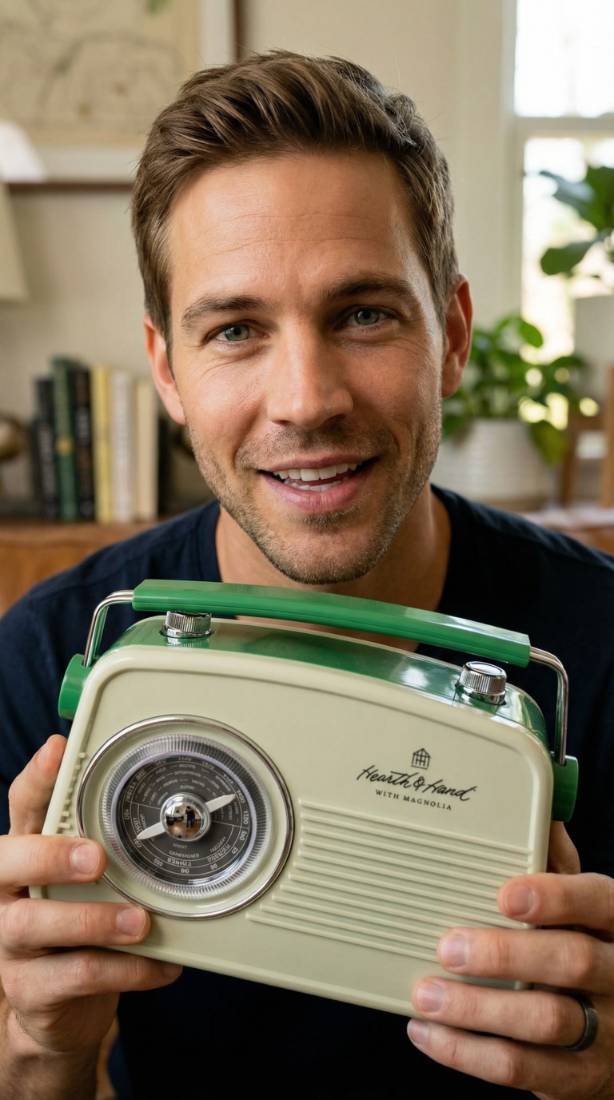
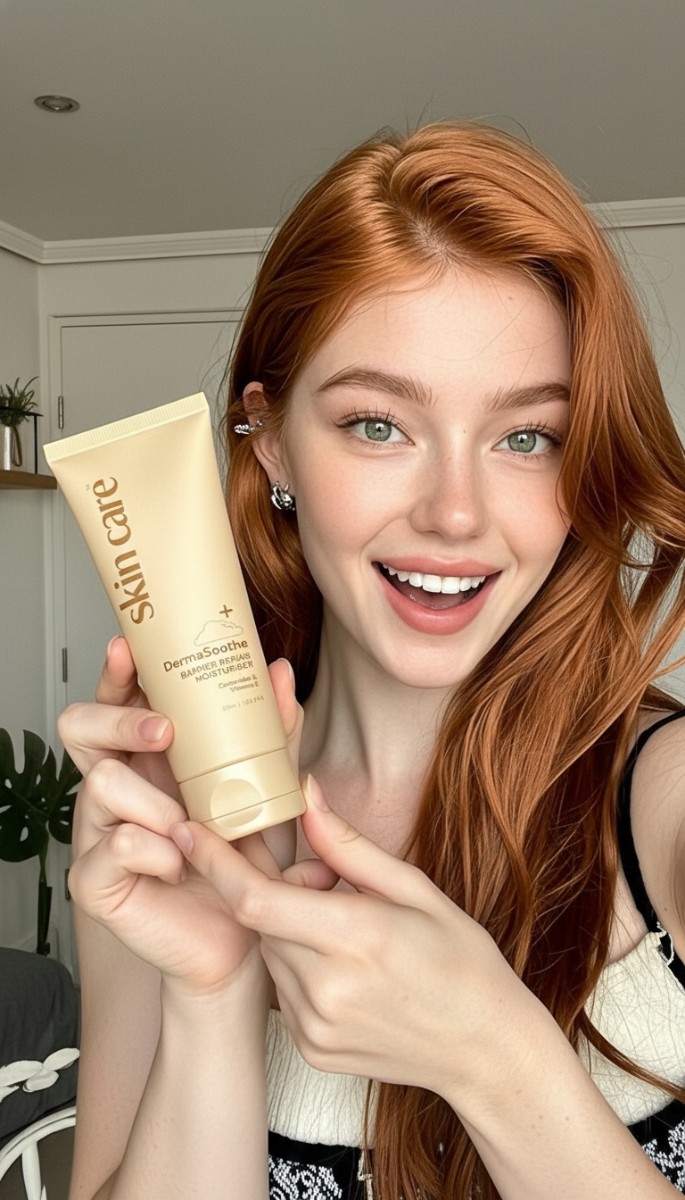
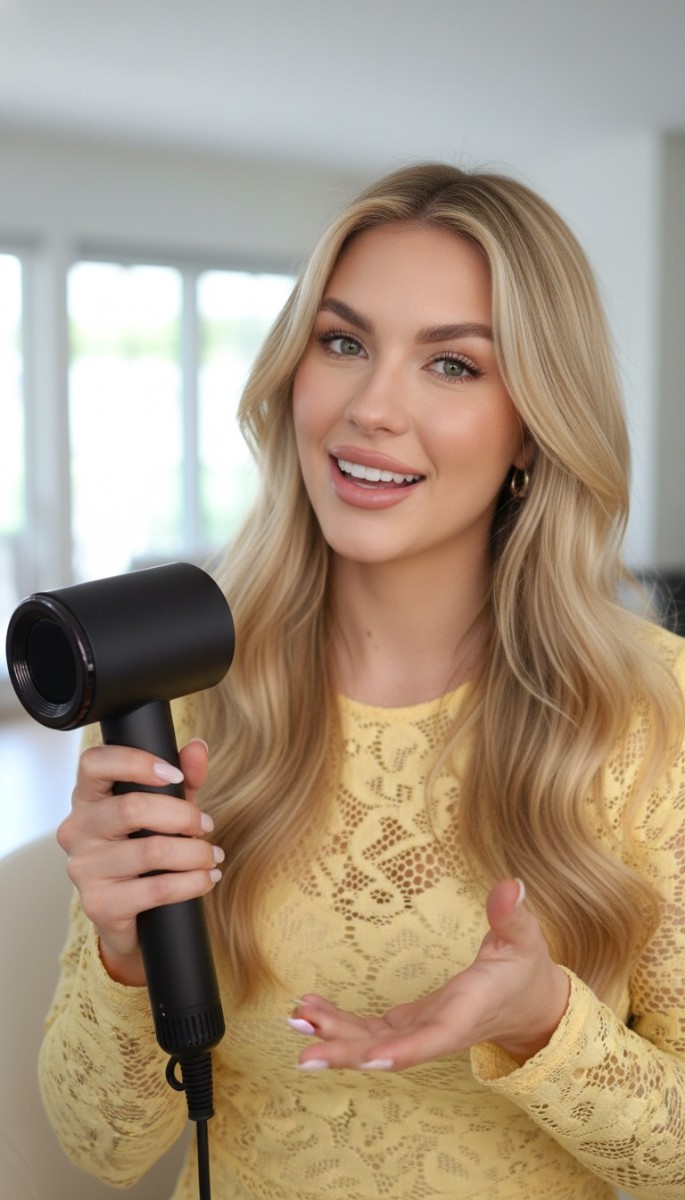
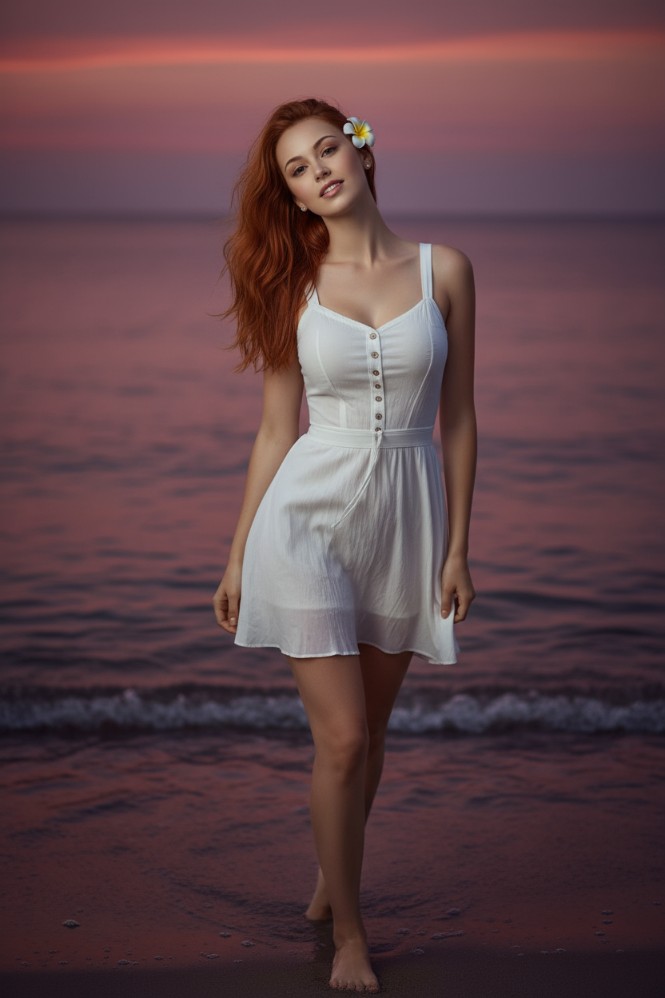
アップロードしたリファレンス画像と生成された動画を並べて比較できます。キャラクター、衣装、小道具、シーンなど複数の写真をアップロードし、AIがそれらを組み合わせて、一貫性のある全く新しい動画クリップを作成する様子をご覧ください。
| 入力 | 出力動画 |
|---|---|
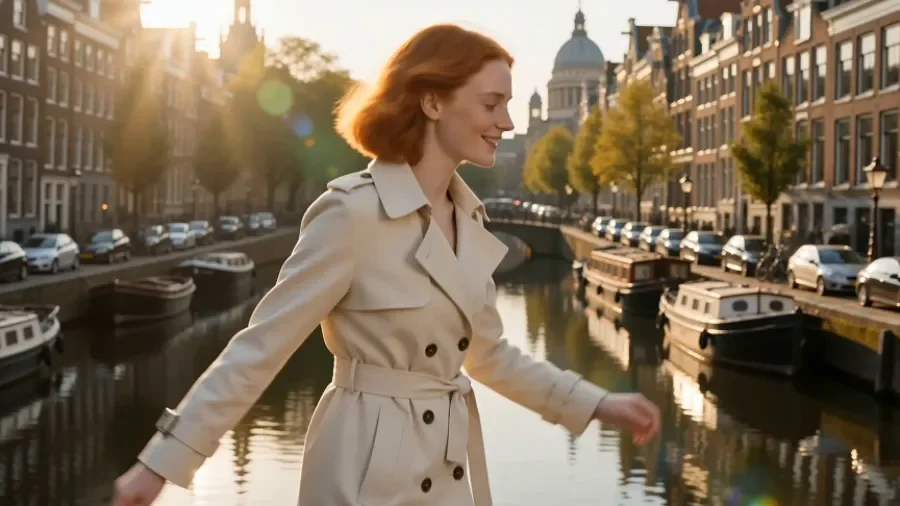 |
@Ref1の女性モデルが、ゴールデンアワーの日差しを受けるパリのバルコニーに立ち、手に@Ref2のルビーレッドの香水ボトルを持って温かい空気中に細かいミストを噴霧しています。彼女はカメラに向かって柔らかく微笑み、風がブロンドのボブヘアを優しく揺らしています。映画的なミディアムクローズアップ、浅い被写界深度。
| 入力 | 出力動画 |
|---|---|
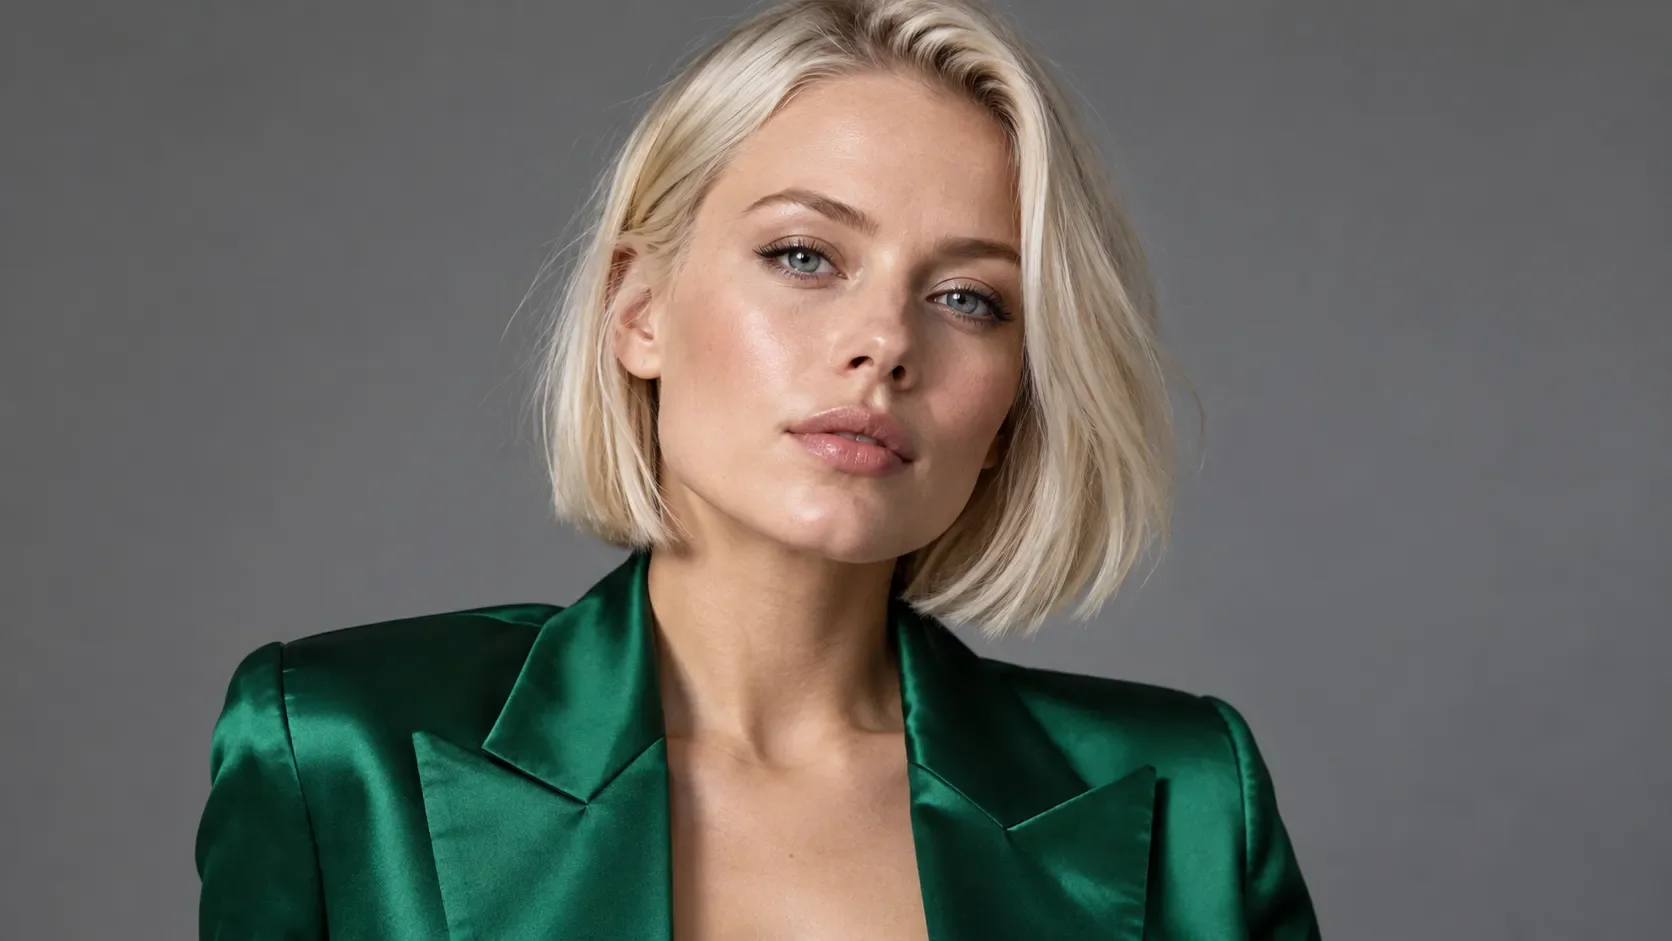 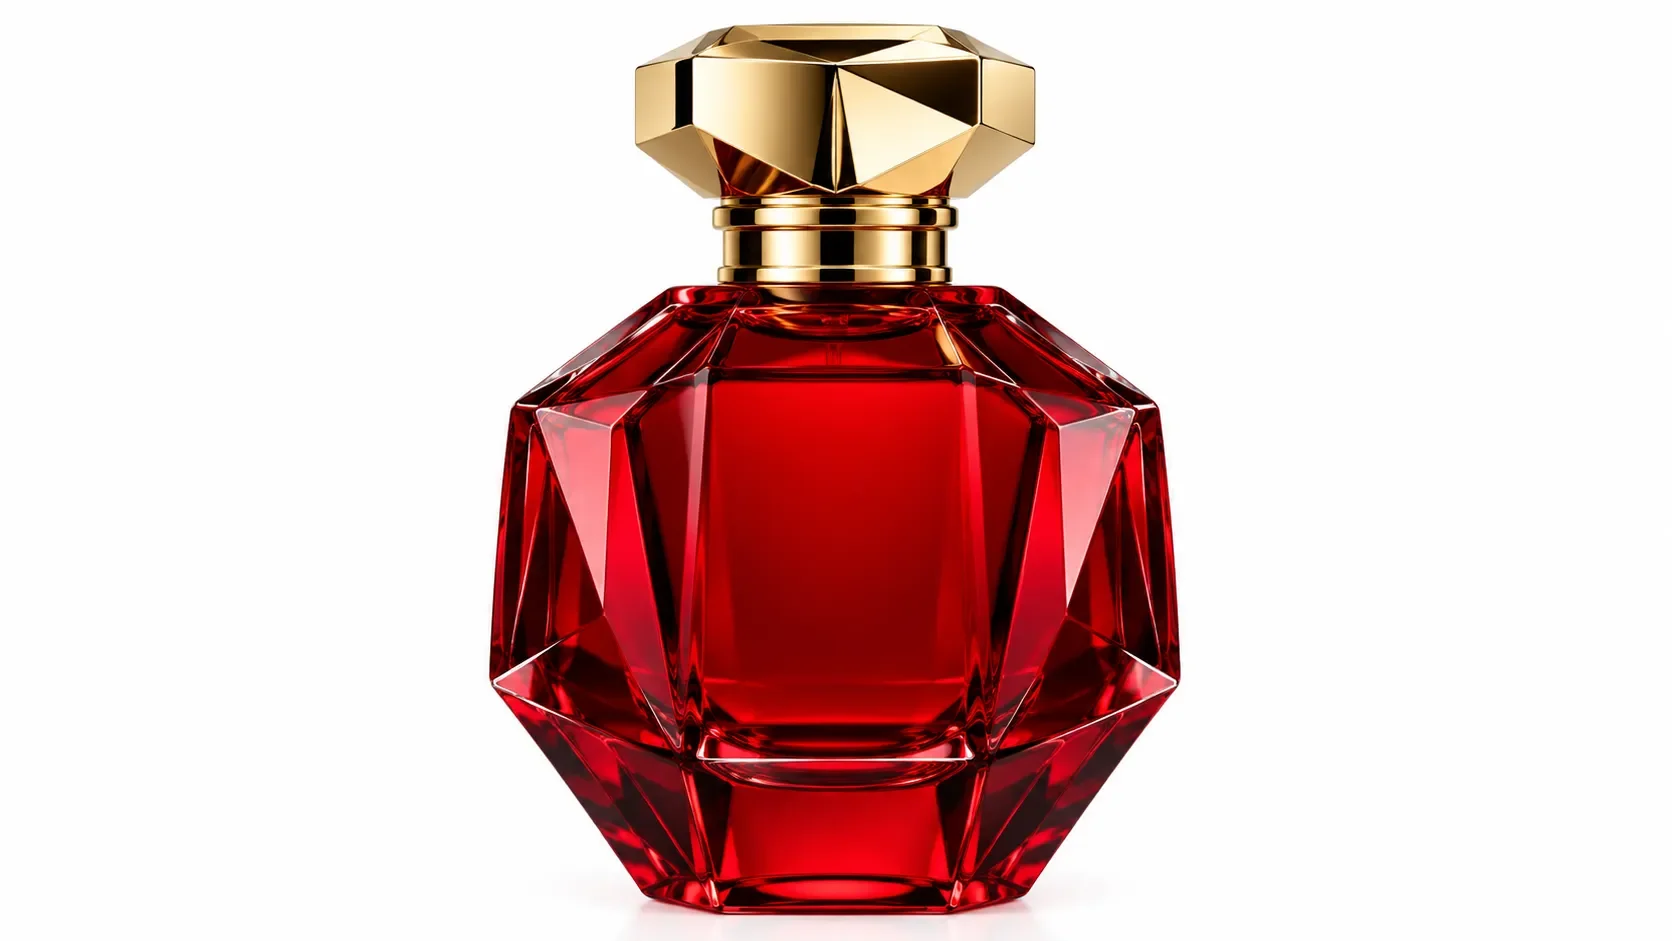 |
真のアイデンティティと顔の固定
カット間で顔が変形してしまう問題に悩むのはもう終わりです。主人公のリファレンス画像を1〜7枚アップロードすると、モデルは正確な顔の形状、ヘアスタイル、衣装のテクスチャを維持しながら、全く新しいアクションやショットを生成します。
複数被写体と小道具の統合
キャラクターの写真、特定の製品(香水ボトルやスポーツカーなど)、背景のリファレンスをアップロードします。それらがどのように相互作用するかをプロンプトで指示すると、AIが正確なライティングと物理演算ですべての要素をシームレスに融合させる様子をご覧いただけます。
最初のフレームを超えた自由
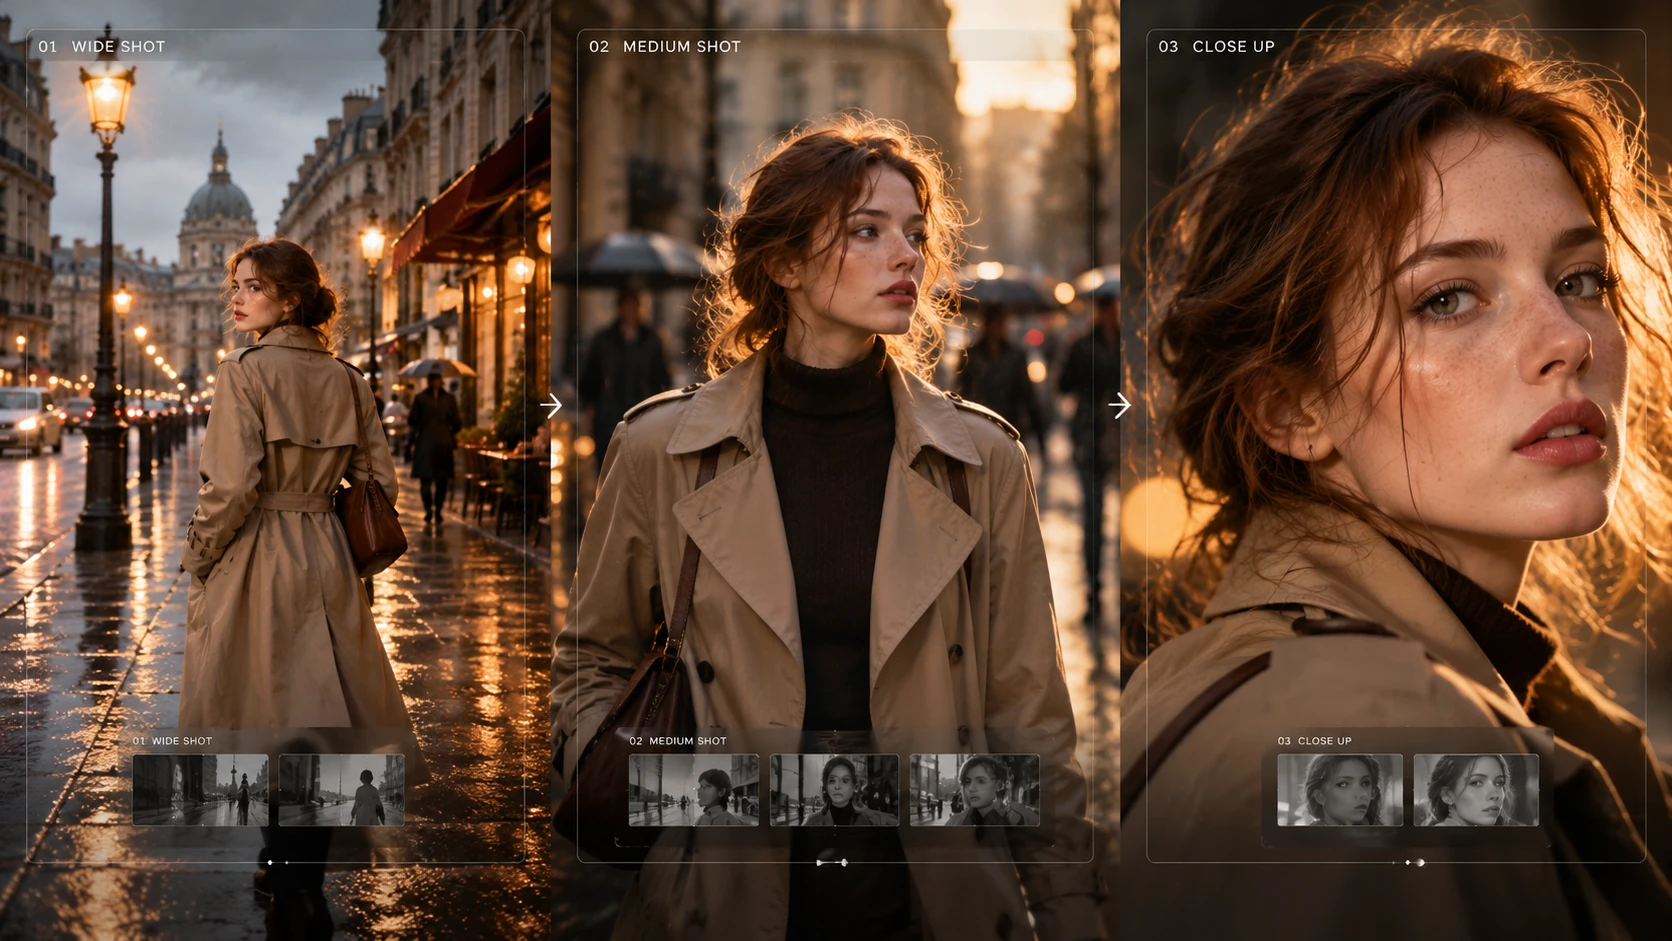
従来の画像から動画への変換(I2V)では、アップロードした画像の構図そのままから動画を開始する必要がありました。リファレンス・トゥ・ビデオは被写体の概念を抽出するため、新しいカメラフレーミング、クローズアップ、またはワイドショットをゼロからディレクションできます。
最高峰の動画エンジンによるパワー
Movmix内で、Kling、Vidu、Seedance、Wanなどの業界をリードするマルチリファレンス動画エンジン之间をシームレスに切り替え、特定の美的感覚、フレームレート、再生時間のニーズに合わせて調整できます。