Googleは最近、数々の印象的なAIモデルをリリースしてきましたが、最新のGeminiアップデートで最も興味深い点は、単一のモデルそのものではないかもしれません。
それはワークフローです。
Googleは現在、クリエイターに対してNano Banana 2 LiteとGemini Omni Flashの組み合わせ方を明示的に示しています。まず画像を生成または調整し、その後、その画像をOmniに入力して動画に変換します。
つまり、次のようになります。
最初のフレームを完璧に仕上げ、それから動かす。
これは当然のように聞こえるかもしれませんが、AI動画における最大の課題の一つを解決します。それは、1つのモデルにキャラクター、構図、環境、動き、カメラワーク、そして最終ショットをすべて同時に考案させるという問題です。
GoogleはNano Banana 2 Liteを、最速かつコスト効率の高いNano Banana画像モデルと位置づけています。一方、Gemini Omni Flashは、テキスト、画像、動画入力の組み合わせを用いた動画生成および対話型編集向けに設計されています。Googleは特に、エンドツーエンドのメディアワークフローのためにこれら2つのモデルを連鎖させて使用することを推奨しています。
さらに、これらのワークフローはどちらもMovmixで利用可能であるため、ファイルを頻繁にダウンロードしたり、無関係なツール間を行き来したりすることなく、同じアプローチを実践できます。
まず、Googleは実際に何をリリースしたのか?
このアップデートには2つの要素があります。
Nano Banana 2 Liteは、高速な画像生成と編集のために構築されています。Googleによると、約4秒で1Kのテキストから画像への変換結果を生成でき、大量処理かつ低遅延のワークフローに最適化されています。
ゼロから始める場合は、Nano Banana 2 Lite Text to Imageを使用して最初のフレームを作成できます。
すでに写真や商品画像をお持ちですか?Nano Banana 2 Lite Image to Imageを使用すれば、すべてを最初から作り直すことなく、シーン、スタイリング、または構図を変更できます。
次に登場するのがGemini Omni Flashです。
GoogleはOmni Flashを、マルチモーダルな動画生成・編集モデルとして位置づけています。対話型編集、マルチモーダル参照、実世界知識、そしてテキスト・グラフィック・アクション間の同期をサポートしています。
しかし、一般的なクリエイターにとって最も有用な点は、もっとシンプルです。
すでに気に入っている画像を与え、動画プロンプトでは「次に何が起こるべきか」に集中すればよいのです。
真の変化:動画モデルにすべてを任せるのをやめよう
質の低いAI動画の多くは、最初のフレームが不適切なことから始まります。
顔が少し歪んでいるかもしれません。
製品の間違った角度で映っているかもしれません。
部屋の様子が想像していたものと全く異なるかもしれません。
その後、さらに長い動画プロンプトを書いて、動画モデルがアニメーション化しながら somehow すべてを修正してくれることを期待します。
それは大きな要求です。
より良い最初のフレームから動画へのワークフローでは、役割を分担します。
画像モデルが答えるのは:
このシーンはどのように見えるべきか?
動画モデルが答えるのは:
次に何が起こるべきか?
このように考えると、プロンプトははるかに書きやすくなります。
すでに目に見えるボトル、モデル、部屋、または衣装を説明するために動画プロンプトの半分を使うのではなく、その言葉をモーション、タイミング、カメラの動きに充てることができます。
だからこそ、Google が Nano Banana 2 Lite と Gemini Omni Flash を連携させたという決定は、別のベンチマークチャートよりも重要なのです。
Movmixでワークフローを再現する方法
シンプルな製品広告を作成してみましょう。
スキンケア製品の画像1枚から、短いプロモーション動画を作成したい場合を想定します。
ステップ1:Nano Banana 2 Liteで最初のフレームを作成
画像から始めます。
例:
| プロンプト | 画像 |
|---|---|
| 滑らかな石のプラットフォーム上に置かれた高級スキンケアボトル、隣には新鮮な緑の葉、柔らかな朝の光、微かな水滴、清潔で自然な背景、エレガントな製品写真、アスペクト比16:9、テキストなし、ロゴなし。 | 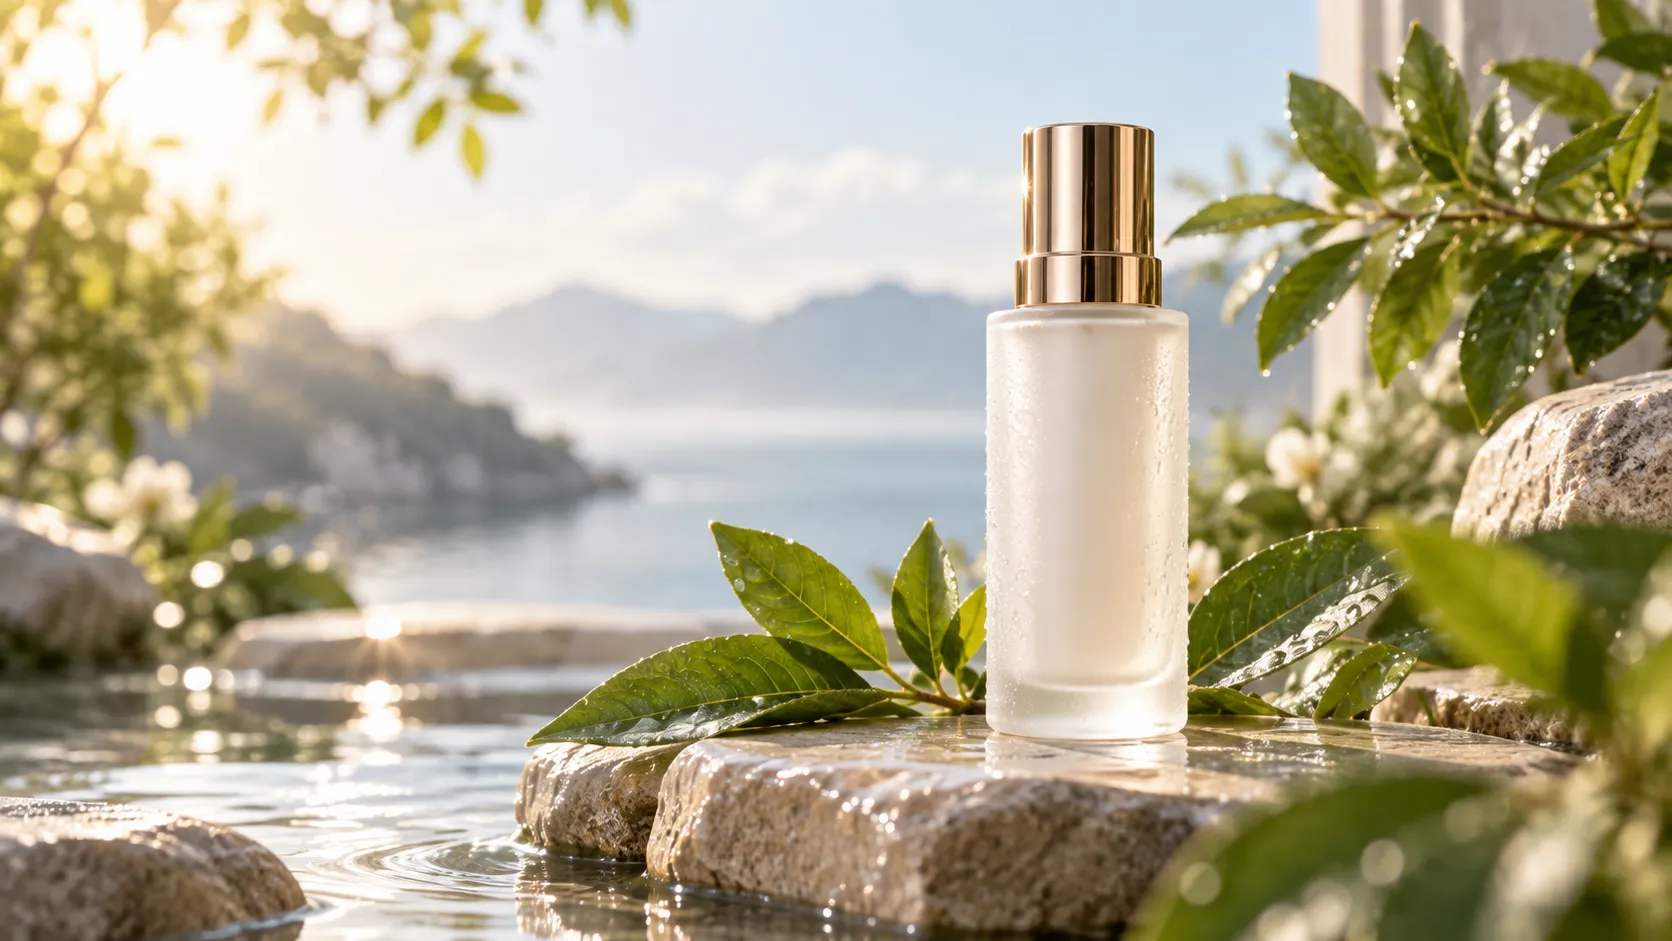 |
この段階では、動きについては完全に忘れてください。
結果を確認し、自問してください:ボトルの形状は正しいか?構図は良いか?ライティングは気に入っているか?背景は十分にクリーンか?
If not, fix the image now.
これは、動画を生成した後に問題に気づくよりも、はるかに簡単です。
ステップ2:Gemini Omniで画像を動画に変換
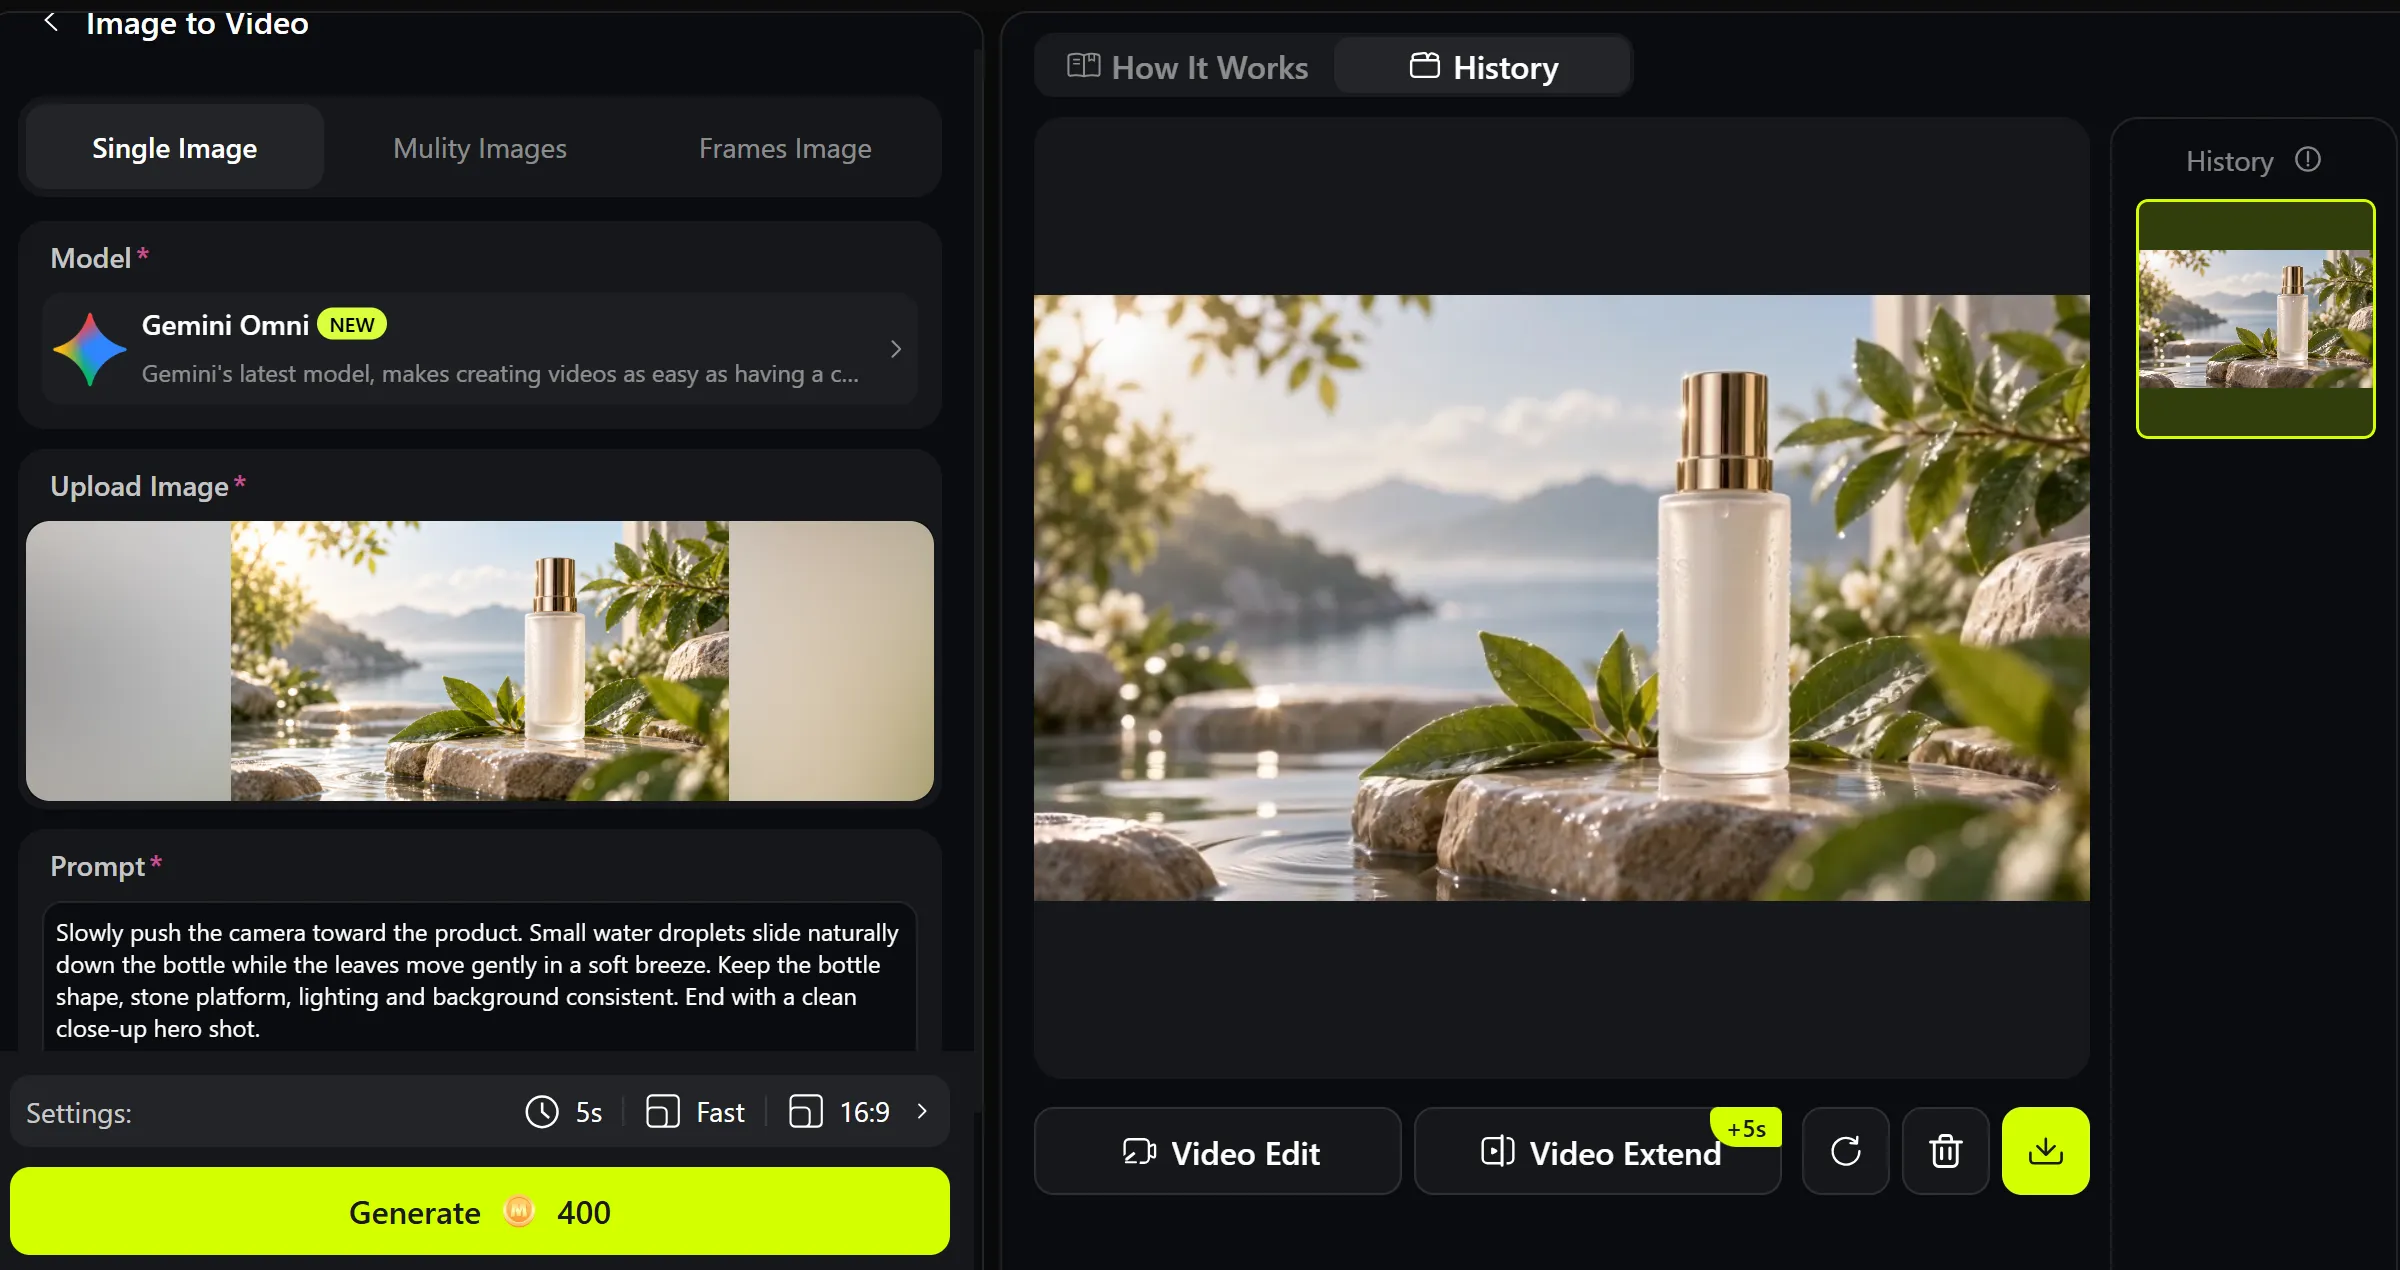
最初のフレームが適切に生成されたら、それをGemini Omni Image to Videoにアップロードします。
ここでプロンプトは次の点に集中できます:
何がないか気づきましたか?
私たちはボトルについて改めて説明していません。
画像がすでにその役割を果たしています。
動画プロンプトが主に制御するのは:
動き → カメラ → 一貫性 → エンディング
これはより明確な分担です。
ステップ3:プロジェクト全体ではなく、動きを微調整する
最初の動画は良く見えますが、カメラの動きが気に入らない場合を想定します。
画像を再生成しないでください。
変更するのは:
カメラのゆっくりしたプッシュイン
例えば以下のように:
製品周りのゆっくりした時計回りのカメラオービット
あるいは、構図を完全に固定したい場合:
カメラを固定したままにします。動くのは葉っぱと水滴だけです。
これは単純に聞こえるかもしれませんが、作業方法を変えることになります。
問題が発生するたびにプロジェクト全体を最初からやり直すのではなく、実際に問題があるステージだけを修正します。
生成されたクリップがすでに近くて視覚的な調整だけが必要な場合は、すべてを再作成するのではなく、Gemini Omni AI ビデオエディターを使って続けることもできます。
Google はすでに、このワークフローが有効な場面を示しています
Google は、Nano Banana 2 Lite と Gemini Omni がどのように連携するかを具体的に示すために、いくつかのデモを作成しました。
一つはAnywhereです。自撮り写真や写真をアップロードすると、Nano Banana 2 Lite が人物をさまざまな場所に配置し、画像を選択すると、Gemini Omni がそれをアニメーション化して動画にします。
ワークフローは基本的に以下の通りです:
写真 → 新しいシーン → アニメーションクリップ
これは、クリエイティブな決定がアニメーション開始前に行われるため、AI 生成画像をアニメーション化するための非常に実用的な方法です。
もう一つのデモはSpace Liftです。Nano Banana 2 Lite がまずアップロードされた部屋を再デザインし、その後 Gemini Omni が選択されたインテリアコンセプトをシネマティックな動きのあるショーケースに変換します。
ビデオモデルに部屋の再デザインとカメラ移動を同時に行うよう求めるのではなく、まず部屋がどうあるべきかを決定します。
その後、それをアニメーション化します。
Google の3つ目の例は、おそらく最も商業的に有用なものです:Omni Product Studioは、Nano Banana 2 Lite からの静止商品画像を、Gemini Omni を使用して EC 用動画に変換します。
これは本質的にAI 商品動画ワークフローです:
商品画像を生成 → 商品画像を承認 → 商品画像をアニメーション化 → 動画を微調整
マーケターやオンラインストアにとって、これは毎回まったく異なる商品ショットを盲目的に生成するよりもはるかに有用です。
基本的な画像から動画への変換を超えた機能
Omniの興味深い点は、このワークフローが1枚の静止画で止まる必要がないことです。
プロジェクトに追加のビジュアルリファレンスやモーションガイドが必要な場合、MovmixにはGemini Omni Reference to Videoのワークフローも用意されています。
これにより、異なる種類のクリエイションが可能になります。
1つのアセットで被写体の外見をモデルに指示し、もう1つのアセットでショットの動き方を伝えます。
ここでマルチモーダル動画は、従来の「1枚の画像をアップロードして結果を待つ」だけの画像から動画への変換よりも、はるかに有用なものになり始めます。
Gemini Omni Flashにはまだ限界があります
これは依然として新しいモデルであり、Googleは現在の制限事項について明確に示しています。
現在、Gemini Omni Flashは10秒間の動画を生成します。また、Googleによると、アップロードされたオーディオリファレンスやシーン拡張は、現時点ではGemini APIを通じてサポートされていません。APIスキーマでは最大3秒までの動画リファレンスが受け入れられる可能性がありますが、モデルによって正しく処理される段階には至っておらず、シーン変更時や大きなパンニング動作時にはキャラクターの一貫性が損なわれる可能性があります。
したがって、現状では以下のようにはいきません。
「何でもアップロードして、完璧な2分間の映画を作成し、帰宅する」
現時点での最も強力なユースケースは、より焦点が絞られています。
強力な最初のフレームを作成し、明確な動きを与え、短いクリップを生成してから、微調整を行います。
正直なところ、それだけでも十分に有用です。
なぜこれが新たなAIモデルの登場よりも重要なのか
ここで起きている最大の変化は、Googleが新しい画像モデルや動画モデルをもう一つ追加したという事実ではありません。
両者の境界線が消えつつある点です。
画像生成が動画生成の一部となります。
動画編集もまた、生成プロセスの一部となります。
参照素材の活用もプロンプト作成の一環となります。
すべてを完璧にこなす万能の「幻のモデル」を探すのではなく、クリエイターは同じアイデアの実現過程において、各段階に応じて異なるツールを活用できるようになります。
実用的なワークフローとしては、この方がはるかに理にかなっています。
全く新しい画像が必要ですか? Nano Banana 2 Lite Text to Image から始めましょう。
すでに保持したい画像がある場合は、それを洗練させます。
最初のフレームが準備できたら、それをGemini Omniに入力し、次のシーンで何を行うべきかを指示します。
Googleの新しいワークフローは、一言で要約できます。
まず本当に欲しいフレームを作成し、その後で動かす。
2026年のAI動画制作において、これは聞こえ以上に大きな転換点となるかもしれません。


